 KnowForge
存储布局
 师成· 更新于 2026-09-29· 阅读 14 分钟· 0 次阅读
以下描述了 Hudi 表在存储中文件的总体组织方式。
- Hudi 将数据表组织为存储上某个 基础路径(base path) 下的目录结构。
- 表可以根据表结构中定义的分区列,选择性地划分为若干 分区(partitions)。
- 在每个分区内部,文件被组织为 文件组(file groups),每个文件组由一个唯一的文件 ID(uuid)标识。
- 每个文件组包含若干 文件切片(file slices)。
- 每个切片包含一个 基础文件(base file)(parquet/orc/hfile,由配置 hoodie.table.base.file.format 定义),由在某个特定即时(instant)完成的提交写入;同时还包含一组 日志文件(log files)(
*.log.*),由在下一个基础文件所请求的即时之前完成的提交写入。 - Hudi 采用多版本并发控制(MVCC),其中 compaction 操作会合并日志文件和基础文件以生成新的文件切片,而 cleaning 操作会清除不再使用/较旧的文件切片,从而在文件系统上回收空间。
- 所有元数据,包括时间线(timeline)、元数据表(metadata table),都存储在基础路径下一个特殊的
.hoodie目录中。
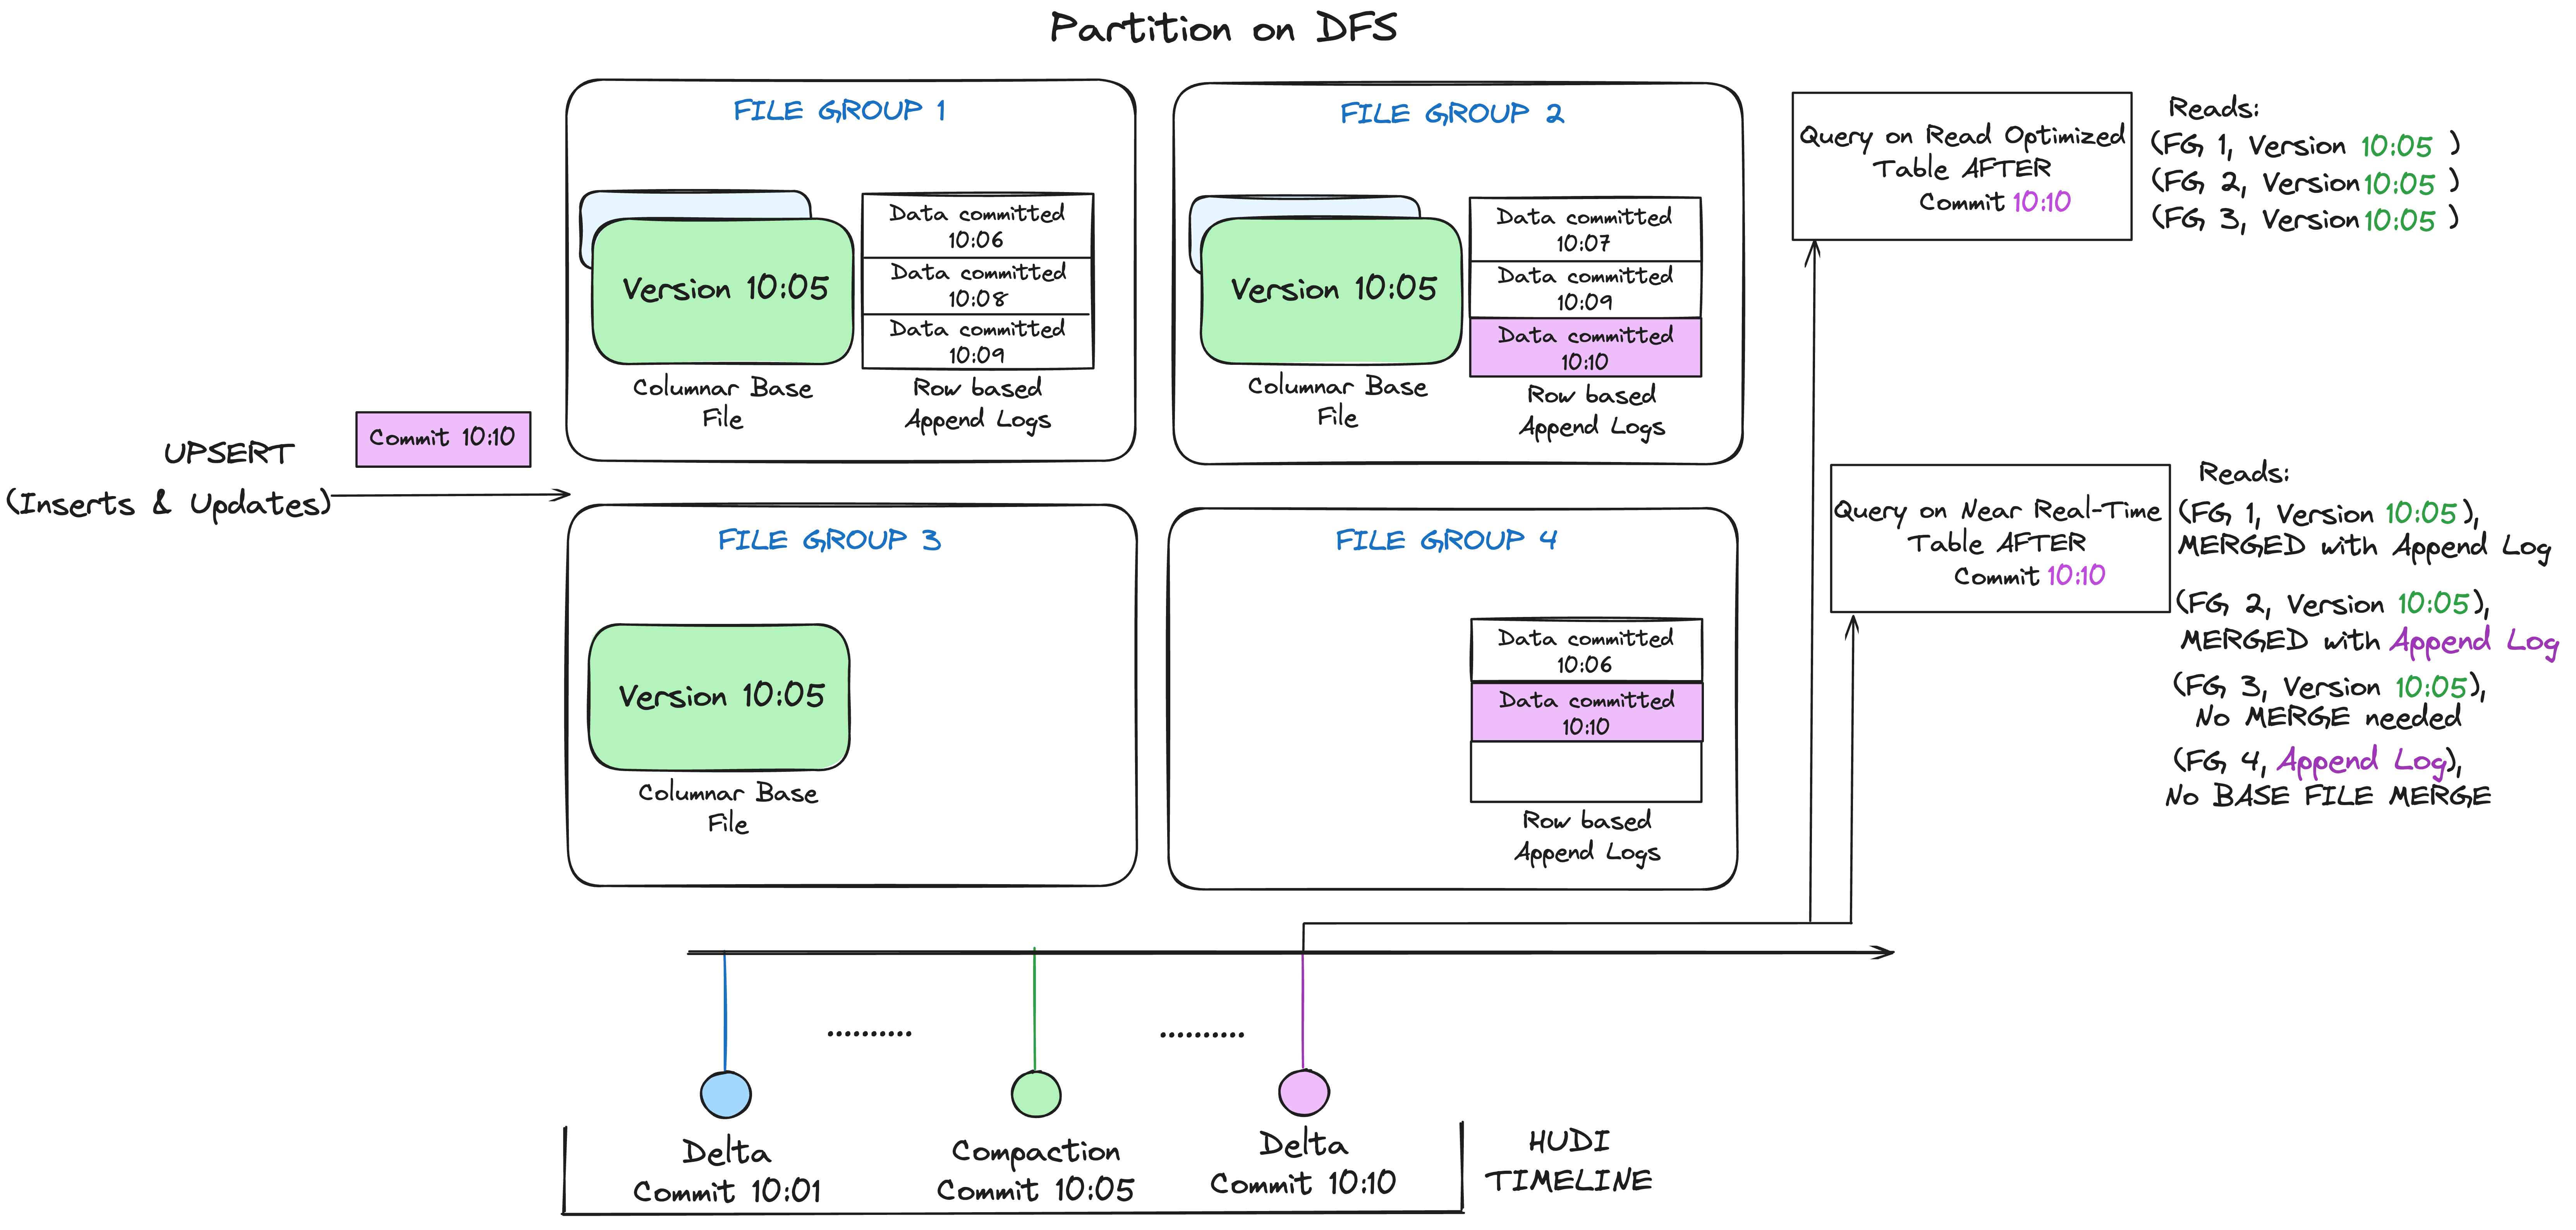
有关文件布局的更详细描述,请参阅技术规范。
基础文件
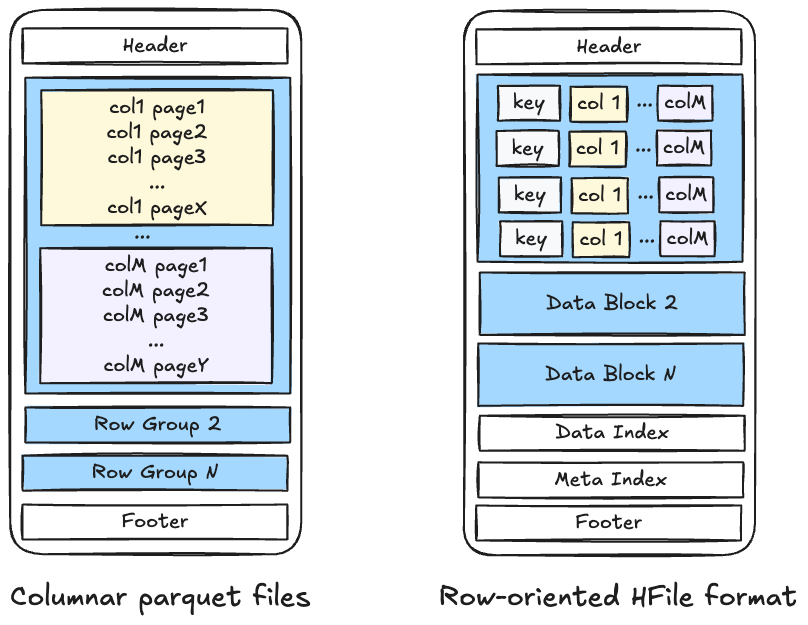
基础文件存储完整记录,而变更记录则存储在下方的增量日志文件中。Hudi 目前支持以下基础文件格式。
- 面向列的格式,支持向量化读取、列式压缩以及面向分析/数据科学的高效列访问。
- 面向行的 avro 文件,可用于快速扫描以读取完整记录。
- 针对随机访问优化的 HFile,便于对已建立索引的记录进行高效查找(基于 SSTable 格式)。
- Lance 文件,用于原生
VECTOR存储和 AI/ML 工作负载(仅限 Spark)。
Lance 基础文件格式
Lance 是一种可插拔的基础文件格式,通过 hoodie.table.base.file.format = 'lance' 按表选择。Hudi 负责管理表层(时间线、元数据、结构、文件组、表服务);Lance 则是基础文件的磁盘文件格式。MOR 表的日志文件仍为 Avro 格式;日志压缩会将 Avro 日志合并到 Lance 基础文件中。
-- COW
CREATE TABLE my_ai_table (
    id        STRING,
    embedding VECTOR(768),
    metadata  STRING
) USING hudi
TBLPROPERTIES (
    primaryKey = 'id',
    type = 'cow',
    hoodie.record.merger.impls = 'org.apache.hudi.DefaultSparkRecordMerger',
    hoodie.table.base.file.format = 'lance'
);

-- MOR (Lance base + Avro logs)
CREATE TABLE my_ai_table_mor (
    id        STRING,
    embedding VECTOR(768),
    metadata  STRING
) USING hudi
TBLPROPERTIES (
    primaryKey = 'id',
    type = 'mor',
    hoodie.record.merger.impls = 'org.apache.hudi.DefaultSparkRecordMerger',
    hoodie.table.base.file.format = 'lance'
);
Hudi 表服务在 Lance 支持的表上的行为如下。压缩(Compaction)会将 Avro 日志文件合并到 Lance 基础文件中。聚类(Clustering)会将记录重新组织到新的 Lance 文件中。清理(Cleaning)会移除过时的 Lance 文件切片。支持布隆过滤器索引;针对 Lance 基础文件,列统计(column-stats)和分区统计(partition-stats)索引会被自动禁用。支持的索引类型详见索引(Indexes)。
Lance 上的类型特定行为:
VECTOR列以 Lance 的FixedSizeList<Float32/Float64, dim>原生存储(仅支持 FLOAT 或 DOUBLE;Lance 不支持INT8,写入时会快速失败)。BLOB列默认使用DESCRIPTOR读取模式,与 Parquet 相同。- Lance 不支持
VARIANT列。将包含 VARIANT 列的表写入 Lance 会抛出HoodieNotSupportedException。VARIANT 表请使用 Parquet。 - 复杂类型(
STRUCT、ARRAY、MAP)可作为 Lance 列使用。 - 支持
populateMetaFields=false。用户自定义的键生成器在 Lance 支持的表上可正常工作。
Lance 仅支持 Spark。从 Flink、Hive、Presto 或 Trino 读取 Lance 支持的表会抛出 HoodieValidationException。Lance 文件同样不可分割:单个 Spark 任务读取一个 Lance 基础文件。
Lance 的 JAR 未包含在 Hudi 发行版中。请将与你的 Spark 版本匹配的 Lance Spark bundle 添加到 Spark 的 classpath 中:
| Spark 版本 | Bundle(Maven Central) |
|---|---|
| Spark 3.4 | org.lance:lance-spark-bundle-3.4_2.12:0.4.0 |
| Spark 3.5 | org.lance:lance-spark-bundle-3.5_2.12:0.4.0 |
| Spark 4.0 | org.lance:lance-spark-bundle-4.0_2.13:0.4.0 |
| Spark 4.1 | org.lance:lance-spark-bundle-4.1_2.13:0.4.0 |
export LANCE_BUNDLE_JAR=/path/to/lance-spark-bundle-3.5_2.12-0.4.0.jar
spark-shell --jars $HUDI_BUNDLE_JAR,$LANCE_BUNDLE_JAR
文件大小与内存
| 属性 | 默认值 | 说明 |
|---|---|---|
hoodie.lance.max.file.size | 125829120(120 MiB) | Lance 基文件的目标文件大小(字节),对应于 hoodie.parquet.max.file.size。 |
hoodie.lance.write.allocator.size.bytes | 268435456(256 MiB) | 用于缓冲进行中批次数据的 Arrow 子分配器的最大大小。对于含有超大 BLOB 列的表,可调大此值。 |
hoodie.lance.write.flush.byte.watermark | 100663296(96 MiB) | 触发当前写入批次刷新的字节大小阈值。必须小于 hoodie.lance.write.allocator.size.bytes。 |
Arrow 采用 2 的幂次方缓冲区倍增策略;默认的 256 MiB 分配器可在容纳 128 MiB 的倍增步长的同时保留余量。默认的 96 MiB 水位线(约为分配器上限的 3/8),为偏移量缓冲区和有效性缓冲区的倍增留出了空间,使其不会超出分配器限制。对于含有大型 BLOB 列的表,应同时调大分配器和水位线(保持水位线 ≈ 分配器的 3/8)。
混合格式表
hoodie.table.base.file.format 按表设置,因此在共享同一 Hudi 目录和元数据表的情况下,同一数据湖仓库中的不同表可以使用不同的基文件格式(Parquet、ORC、HFile、Lance)。
日志文件
日志文件在基文件创建之后,存储对基文件的增量变更(部分或全部),例如更新、插入和删除。日志文件包含不同的块(数据块、命令块、删除块等),用于编码对基文件的特定变更。数据块编码对基文件的更新/插入,并支持自定义以满足不同需求:
- 面向行的 Avro 文件,用于快速、轻量的写入
- 针对随机访问优化的 HFile,便于高效查找已索引的记录(基于 SSTable 格式)
- 列式 Parquet 文件,用于向量化的日志合并。
存储格式版本
Hudi 存储格式的各个元素(如日志格式、日志块结构、时间线文件/数据模式)均已进行版本化,并与给定的表版本绑定。表版本是一个单调递增的数字,每当存储中产生的某些位发生改变时,该数字就会递增。
向后兼容读取:Hudi 的版本发布遵循向后兼容原则,以确保新版本软件能够读取近期的旧版本表。在不同引擎之间升级 Hudi 的推荐方式是:先升级所有读取端(例如消费表的交互式查询引擎),再升级所有写入端以及表服务。Hudi 存储引擎还实现了自动升级能力,能够在后续的写入操作中平滑地完成表版本升级,自动执行所有必要的步骤,而无需中断查询和读取。
向后兼容写入:然而,由于基于 Hudi 构建的数据平台可能存在多阶段流水线,这些流水线同时充当读取端和写入端,上述方式并非在所有情况下都可行。在这种情况下,Hudi 升级需要先升级最下游的任务,然后逐级追溯到最早写入 Hudi 表的任务(可能由摄取系统执行)。为了简化这一过程,Hudi 也允许写入较旧的近期表版本,从而可以先将新的 Hudi 软件二进制文件在相同的旧表版本上发布到整个部署环境。当所有任务和引擎都使用新二进制文件后,再以任意顺序升级到更新的表版本,读取端会自动动态适配。
配置项
以下写入端配置用于控制旧版本表的写入以及自动升级行为。
| 配置名称 | 默认值 | 描述 |
|---|---|---|
| hoodie.write.table.version | latest(可选) | 该写入端将表存储时所使用的表版本。如果表已存在,此值应与当前表版本一致。按照上述方式进行升级时,请将其设置为较低的版本。 |
| hoodie.write.auto.upgrade | true(可选) | 如果启用,当当前表版本低于指定的写入表版本时,写入端会自动将表迁移到指定的写入表版本。 |
有关控制存储布局和数据分布(定义表内文件组织方式)的其他配置,请参阅此处。
评论
登录后参与评论