 KnowForge
写入操作
 师成· 更新于 2026-09-29· 阅读 18 分钟· 0 次阅读
了解 Hudi 支持的不同写入操作以及如何最佳地利用它们可能会很有帮助。这些操作可以在对表发起的多次写入之间选择或更改。每种写入操作都对应时间线上的一个动作类型。
从本质上讲,Hudi 在时间线和存储格式之上提供了一个高性能存储引擎,高效地实现这些操作。为便于理解,写入操作可分为两类。
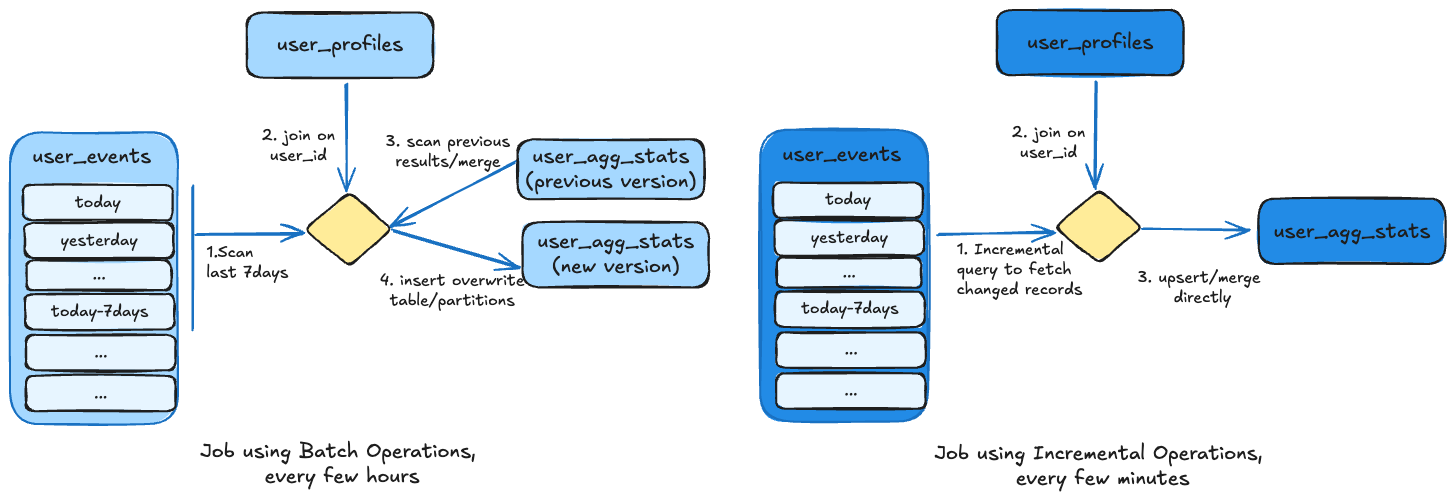
- 批量/整体操作:没有 Hudi 提供的功能时,最常见的写入方式是每隔几小时完全覆盖整个表和/或分区。例如,某个计算指定周聚合数据的作业会定期扫描全部数据,从头重新计算结果,并通过
insert_overwrite操作发布输出。Hudi 支持所有这类批量或典型"批处理"写入操作,同时提供本文讨论的原子性及其他存储特性。 - 增量操作:然而,Hudi 专为将这种处理模型转变为更增量式的方法而构建,如下图所示。为此,存储引擎实现了增量写入操作,擅长将增量变更应用到表上。例如,同样的处理现在只需从上游系统或 Hudi 增量查询中获取发生变化的记录,然后仅针对发生变化的特定记录直接更新目标表上的聚合结果即可。
操作类型
UPSERT(更新插入)
类型:增量,动作:COMMIT(CoW),DELTA_COMMIT(MoR)
这是默认操作,首先通过查询索引将输入记录标记为插入或更新。在运行启发式规则以确定如何在存储上最佳地打包这些记录(从而优化文件大小等因素)之后,记录最终被写入。该操作推荐用于数据库变更捕获等输入几乎必然包含更新的场景。目标表永远不会出现重复记录。
INSERT(插入)
类型:增量,动作:COMMIT(CoW),DELTA_COMMIT(MoR)
该操作在启发式规则/文件大小方面与 upsert 非常相似,但完全跳过了索引查询步骤。因此,对于日志去重等场景(结合下文提到的过滤重复项的选项),通过跳过索引标记步骤,它可以比 upsert 快得多。该操作也适用于能够容忍重复记录、但只需要 Hudi 的事务性写入/增量查询/存储管理能力的场景。
BULK_INSERT(批量插入)
类型:批量,动作:COMMIT(CoW),DELTA_COMMIT(MoR)
upsert 和 insert 操作都会将输入记录保留在内存中,以便更快地完成存储启发式计算(以及其他处理),因此在首次加载/引导海量数据时可能会比较吃力。bulk insert 提供与 insert 相同的语义,但采用了基于排序的数据写入算法,对于数百 TB 的初始加载量具有很好的扩展性。不过,它在文件大小的把控上只是尽力而为,并不像 insert/upsert 那样保证文件大小。
DELETE
类型:增量(Incremental),动作:COMMIT(CoW)、DELTA_COMMIT(MoR)
Hudi 支持在存储于 Hudi 表中的数据上实现两种类型的删除,方式是允许用户指定不同的记录载荷(payload)实现。
软删除(Soft Deletes):保留记录键,仅将其他所有字段的值置为 null。只要在表 schema 中确保相应字段可为空,然后将这些字段设为 null 并对表执行 upsert 即可实现。
硬删除(Hard Deletes):该方法会从表中彻底清除一条记录的所有痕迹,包括其任何副本。实现方式有以下三种:
- 使用 DataSource,将
"hoodie.datasource.write.operation"设置为"delete"。这将删除所提交 DataSet 中的所有记录。 - 使用 DataSource,将
PAYLOAD_CLASS_OPT_KEY设置为"org.apache.hudi.EmptyHoodieRecordPayload"。这将删除所提交 DataSet 中的所有记录。 - 使用 DataSource 或 Hudi Streamer,在 DataSet 中添加名为
_hoodie_is_deleted的列。对于所有要删除的记录,该列的值必须设为true;对于要执行 upsert 的记录,则设为false或保持为 null。
- 使用 DataSource,将
BOOTSTRAP
Hudi 支持使用 bootstrap 操作将现有的大型表迁移到 Hudi 表中。实现方式有多种,详情请参阅引导页面。
INSERT_OVERWRITE
类型:批量(Batch),动作:REPLACE_COMMIT(CoW + MoR)
该操作用于重写输入数据中出现的所有分区。对于一次性重新计算整个目标分区(而不是增量更新目标表)的批处理 ETL 作业,该操作可能比 upsert 更快。这是因为在 upsert 写入路径中,我们可以完全绕过索引、precombine 以及其他重新分区步骤。在执行数据回填(backfill)或类似场景时,该操作非常有用。
INSERT_OVERWRITE_TABLE
类型:批量(Batch),动作:REPLACE_COMMIT(CoW + MoR)
出于任何原因,该操作都可用于覆盖整张表。Hudi 的 cleaner 最终会根据配置的清理策略,异步清理上一个表快照的文件组。该操作比执行显式删除要快得多。
DELETE_PARTITION
类型:批量(Batch),动作:REPLACE_COMMIT(CoW + MoR)
除了删除单条记录外,Hudi 还支持通过该操作批量删除整个分区。要删除特定分区,可以使用配置 hoodie.datasource.write.partitions.to.delete。
配置项
以下是与上述写入操作类型相关的基本配置。更多基于 Spark 的配置请参阅 Write Options,基于 Flink 的配置请参阅 Flink options。
基于 Spark 的配置:
配置名称默认值描述
hoodie.datasource.write.operationupsert (可选)指定写入操作执行的是 upsert、insert 还是 bulk_insert。使用 bulk_insert 将新数据加载到表中,之后再使用 upsert/insert。bulk insert 采用基于磁盘的写入路径,能够在无需缓存数据的情况下扩展以处理大规模输入。
Config Param: OPERATION
hoodie.table.ordering.fields(无)(可选)用于记录合并比较的字段,以逗号分隔。默认情况下,当两条记录的键值相同时,会选取排序字段值较大的那条(由 Object.compareTo(..) 确定)。如果配置了多个字段,则先比较第一个字段;若第一个字段值相同,则比较第二个字段,以此类推。Config Param: ORDERING_FIELDS
hoodie.combine.before.insertfalse(可选)当插入的记录具有相同的键时,控制是否先对它们进行合并(即去重)再写入存储。
Config Param: COMBINE_BEFORE_INSERT
hoodie.datasource.write.insert.drop.duplicatesfalse(可选)设置为 true 时,写入操作期间传入 DataFrame 中的记录不会覆盖具有相同键的现有记录。该配置自 0.14.0 起已废弃,请改用 hoodie.datasource.insert.dup.policy。
Config Param: INSERT_DROP_DUPS
hoodie.bulkinsert.sort.modeNONE(可选)org.apache.hudi.execution.bulkinsert.BulkInsertSortMode:批量插入期间对记录进行排序的模式。
NONE(默认):不排序。速度最快,在文件数量和开销方面与spark.write.parquet()一致。GLOBAL_SORT:确保最佳的文件大小,以排序为代价实现最低的内存开销。PARTITION_SORT:通过只在 Spark RDD 分区内排序来取得折中,同时保持较低的写入内存开销。文件大小的优化效果不如GLOBAL_SORT。PARTITION_PATH_REPARTITION:确保表中单个物理分区的数据由同一个 Spark executor 写入。只有当输入数据在不同分区路径之间均匀分布时才应使用。如果数据存在倾斜(大部分记录都属于少数几个分区路径),则可能导致 Spark executor 之间的负载不均衡。PARTITION_PATH_REPARTITION_AND_SORT:确保表中单个物理分区的数据由同一个 Spark executor 写入。只有当输入数据在不同分区路径之间均匀分布时才应使用。与PARTITION_PATH_REPARTITION相比,由于多个物理分区的数据可能会被发送到同一个 Spark 分区和 executor,这种排序模式会在单个 Spark 分区内额外执行一步,按分区路径对记录进行排序。如果数据存在倾斜(大部分记录都属于少数几个分区路径),则可能导致 Spark executor 之间的负载不均衡。
Config Param: BULK_INSERT_SORT_MODE
hoodie.bootstrap.base.path无 **(必需)**仅当操作类型为 bootstrap 时适用。需要作为 Hudi 表进行引导的基路径
Config Param: BASE_PATHSince Version: 0.6.0
hoodie.bootstrap.mode.selectororg.apache.hudi.client.bootstrap.selector.MetadataOnlyBootstrapModeSelector(可选)选择引导数据集中每个文件/分区进行引导的模式
可能的取值:
org.apache.hudi.client.bootstrap.selector.MetadataOnlyBootstrapModeSelector:该模式下不会将完整的记录数据复制到 Hudi,因此避免了重写整个数据集的全部开销。取而代之的是,只包含相应元数据列的“骨架”文件会被添加到 Hudi 表中。Hudi 依赖原始表中的数据,如果原始表位置中的文件被删除或修改,将会导致数据丢失或损坏。org.apache.hudi.client.bootstrap.selector.FullRecordBootstrapModeSelector:该模式下会将完整的记录数据复制到 Hudi,并添加元数据列。全记录引导在功能上等同于一次 bulk-insert。完成全记录引导后,即使原始表被修改或删除,Hudi 也能正常运行。org.apache.hudi.client.bootstrap.selector.BootstrapRegexModeSelector:一种通过指定分区来选择引导模式的引导选择器。
Config Param: MODE_SELECTOR_CLASS_NAMESince Version: 0.6.0
hoodie.datasource.write.partitions.to.deleteN/A **(必填)**仅当操作类型为 delete_partition 时适用。以逗号分隔的待删除分区列表。支持使用通配符 *
Config Param: PARTITIONS_TO_DELETE
基于 Flink 的配置:
配置名称默认值描述
write.operationupsert(可选)本次写入应执行的写操作
Config Param: OPERATION
ordering.fields(无默认值)(可选)实际写入前用于对记录排序的字段。当两条记录的键值相同时,我们会选取排序字段值最大的那一条,依据 Object.compareTo(..) 进行比较。注意:旧配置 precombine.field 已弃用。
Config Param: ORDERING_FIELDS
write.precombinefalse(可选)指示是否在插入/更新前去重的标志。默认情况下,以下场景将接受重复数据以获取额外性能:1)insert 操作;2)MOR 表的 upsert,MOR 表在读取时去重
Config Param: PRE_COMBINE
write.bulk_insert.sort_inputtrue(可选)是否按指定字段对批量插入任务的输入进行排序,默认为 true
Config Param: WRITE_BULK_INSERT_SORT_INPUT
write.bulk_insert.sort_input.by_record_keyfalse(可选)是否按记录键对批量插入任务的输入进行排序,默认为 false
Config Param: WRITE_BULK_INSERT_SORT_INPUT_BY_RECORD_KEY
写入路径
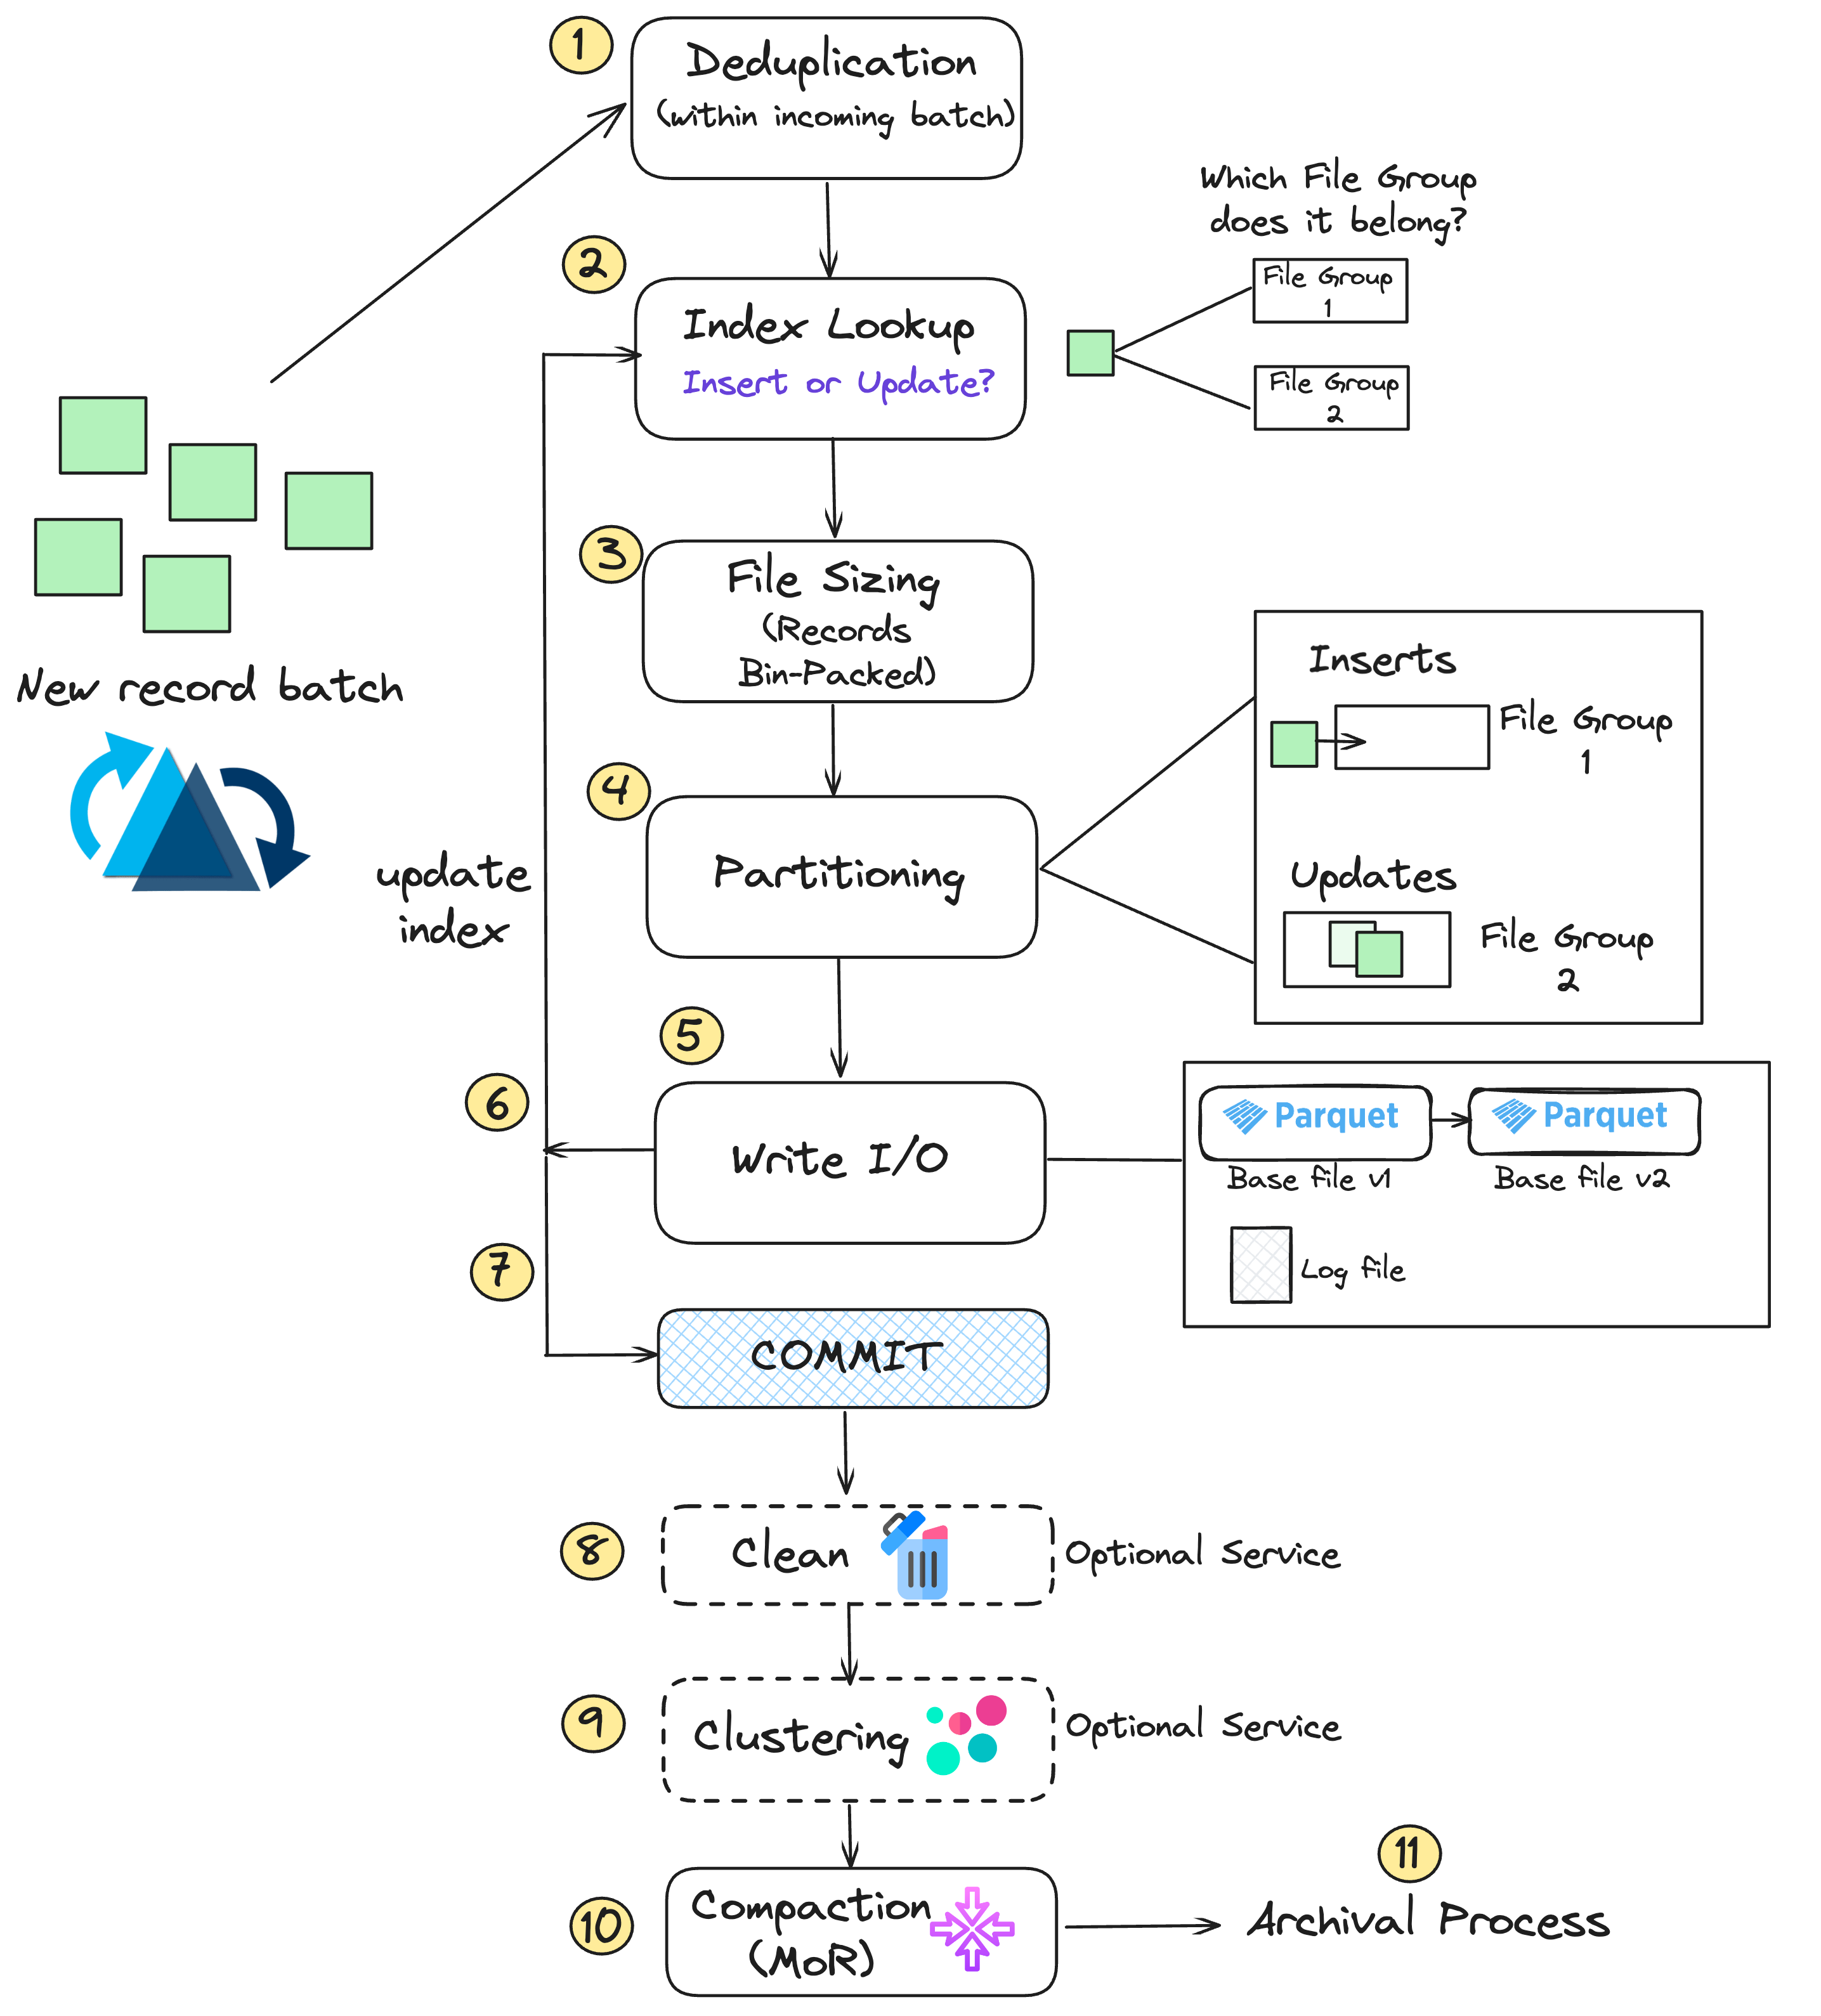
以下深入介绍了 Hudi 的写入路径以及写入过程中发生的事件序列。
- 去重:首先,你的输入记录在同一批次内可能存在重复键,需要按键进行合并或归约。
- 索引查找:接下来,会执行一次索引查找,尝试匹配输入记录,以确定它们属于哪些文件组。
- 文件大小调整:然后,Hudi 会根据此前提交的平均大小制定计划,向小文件中追加足够的记录,使其接近配置的最大限制。
- 分区:接下来进入分区环节,我们要决定某些更新和插入将放入哪些文件组,或者是否创建新的文件组。
- 写入 I/O:现在我们真正执行写入操作,即创建新的基础文件、追加到日志文件,或对现有基础文件进行版本化。
- 更新索引:写入完成后,我们会回去更新索引。
- 提交:最后,我们原子性地提交所有这些更改。(可以配置提交后回调。)
- 清理(如需要):提交之后,如果需要则会触发清理。
- 压缩:如果你使用的是 MOR 表,压缩会以内联方式运行,或被异步调度执行。如果启用了
hoodie.log.compaction.inline,日志压缩也可能会运行,它会将小的日志块拼接起来,而无需重写基础文件。 - 归档:最后,我们执行归档步骤,将旧的时间线项移动到归档文件夹中。
以下是该流程的图示。
视频
评论
登录后参与评论