 KnowForge
表与查询类型
 师成· 更新于 2026-09-29· 阅读 20 分钟· 0 次阅读
Hudi 的 表类型(table types) 定义了数据的存储方式以及写操作在表之上的实现方式(即数据如何写入)。相应地,查询类型(query types) 定义了底层数据如何暴露给查询(即数据如何读取)。
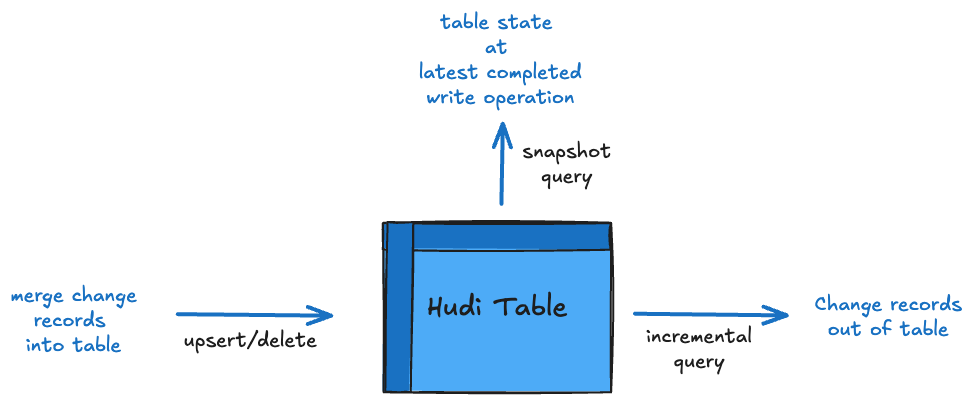
图:表与查询
Hudi 引入了以下表类型,如今这些类型已被业界广泛采用,用于权衡类似的取舍。
Copy On Write(写时复制):Copy-on-Write(CoW)表类型针对读多写少的工作负载进行了优化。在这种模式下,记录的更新或删除会触发文件组中新建基础文件,且不会写入任何日志文件。这确保了每次查询只需读取基础文件,无需动态合并日志文件,从而提供较高的读取性能。CoW 表非常适合 OLAP 扫描/查询,但由于更新或删除时需要重写基础文件,即使每个文件中只有小部分记录被修改,其写操作也可能较慢。
Merge On Read(读时合并):Merge-on-Read(MoR)表类型通过将轻量级日志文件与基础文件结合,并进行周期性压缩(compaction),在写性能和读性能之间取得平衡。数据的更新和删除会写入日志文件(采用 Avro 等基于行的格式,或列式/基础文件格式),这些日志文件中的变更随后会在查询执行期间与基础文件动态合并。这种方式降低了写入延迟,并支持近实时的数据可用性。不过,查询性能可能因日志文件是否已被压缩而有所差异。
无论是哪种表类型,两者都提供了诸如原子写入、索引等核心事务能力,以及增量查询、自动文件大小调整和可扩展的表元数据追踪等独有的新特性。
Copy On Write 表
下图从概念上展示了数据写入 Copy-on-Write 表,以及在其之上运行的两个查询的工作方式。
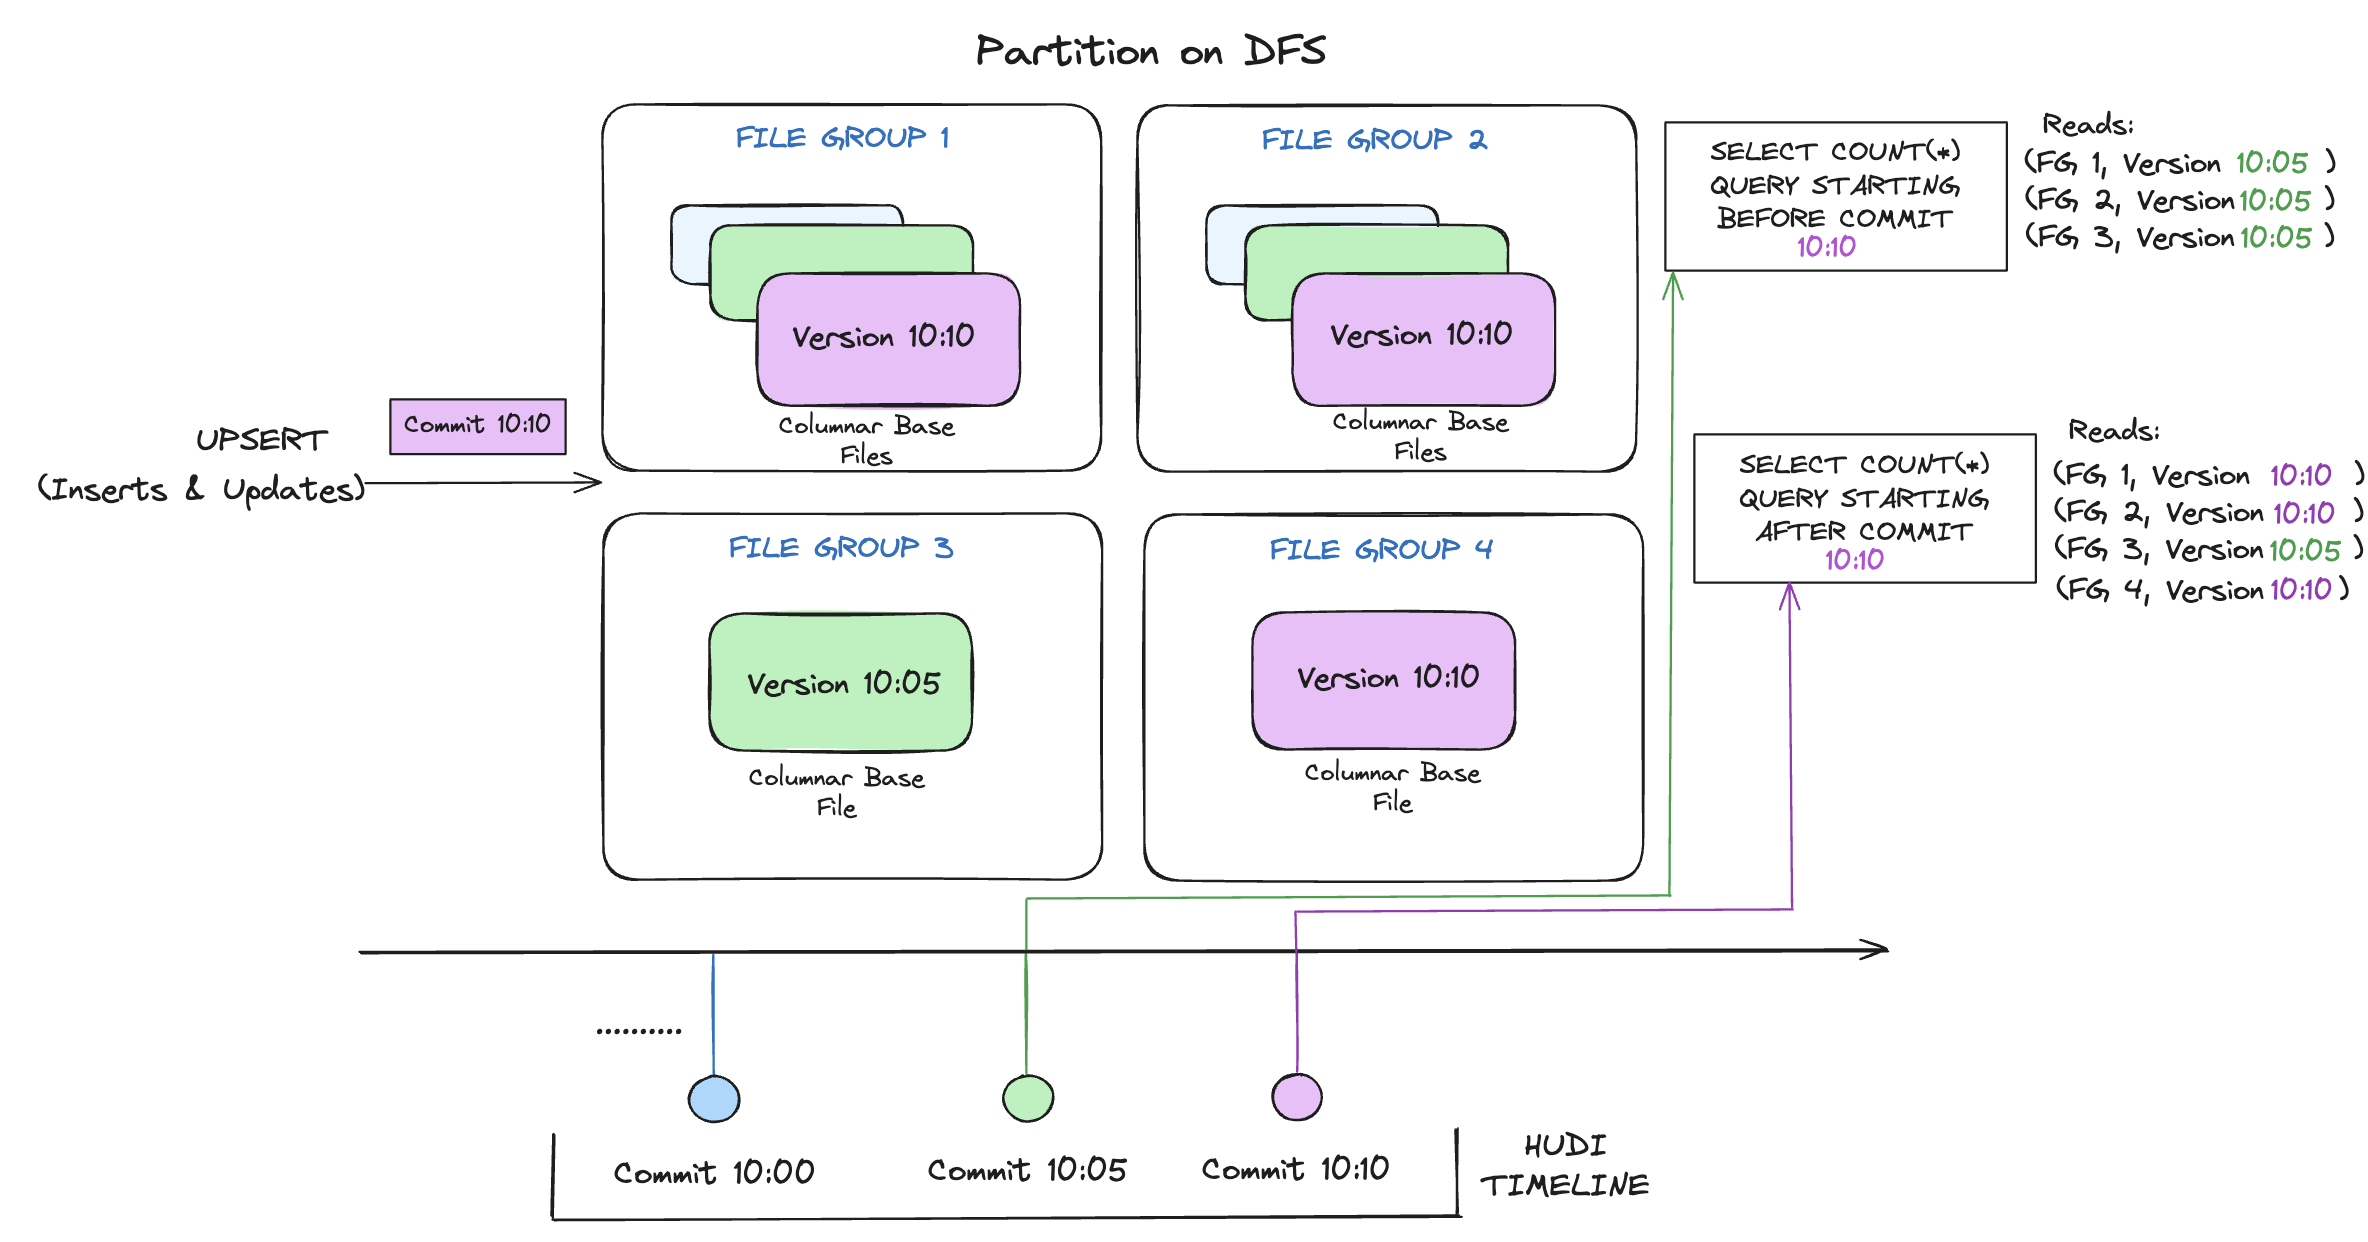
随着数据写入,对现有文件组的更新会为该文件组生成一个新的文件切片,并打上与本次提交所请求的即时时间(requested instant time)相关的标记;而插入操作则会分配一个全新的文件组,并为该文件组写入第一个文件切片。这些文件切片及其提交完成的即时时间在上图中以不同颜色标出。针对此类表执行的 SQL 查询(例如统计该分区中总记录数的 select count(*)),会先检查时间线上的已完成写入,然后过滤掉每个文件组中除最新文件切片之外的所有切片。可以看到,较早发起的查询无法看到当前进行中(inflight)提交的文件(以粉色标出),而在该提交之后启动的新查询则能读取到新数据。因此,查询不受任何写入失败或部分写入的影响,只会读取已提交的数据。
以下场景非常适合使用 CoW 表。
- 批处理 ETL/数据管道:为基于 SQL 的 ETL(从数据仓库迁移而来)或编写每隔数小时运行一次的复杂代码管道,提供了一个简单易用的方案。这类表通常是下游从原始层/接入层派生而来的表。
- 数据湖上的数据仓库:凭借出色的读取性能,CoW 表可用于快速运行 OLAP 查询,并结合其他表服务,基于这些查询对数据布局进行优化。
- 静态或缓慢变化的数据:由于其简单性,CoW 表是维表或更新频率极低、几乎不发生变化的表的绝佳选择。
读时合并表(Merge On Read Table)
下图说明了 MoR 表的工作方式,并展示了两类查询——快照查询(snapshot query)和读优化查询(read optimized query)。
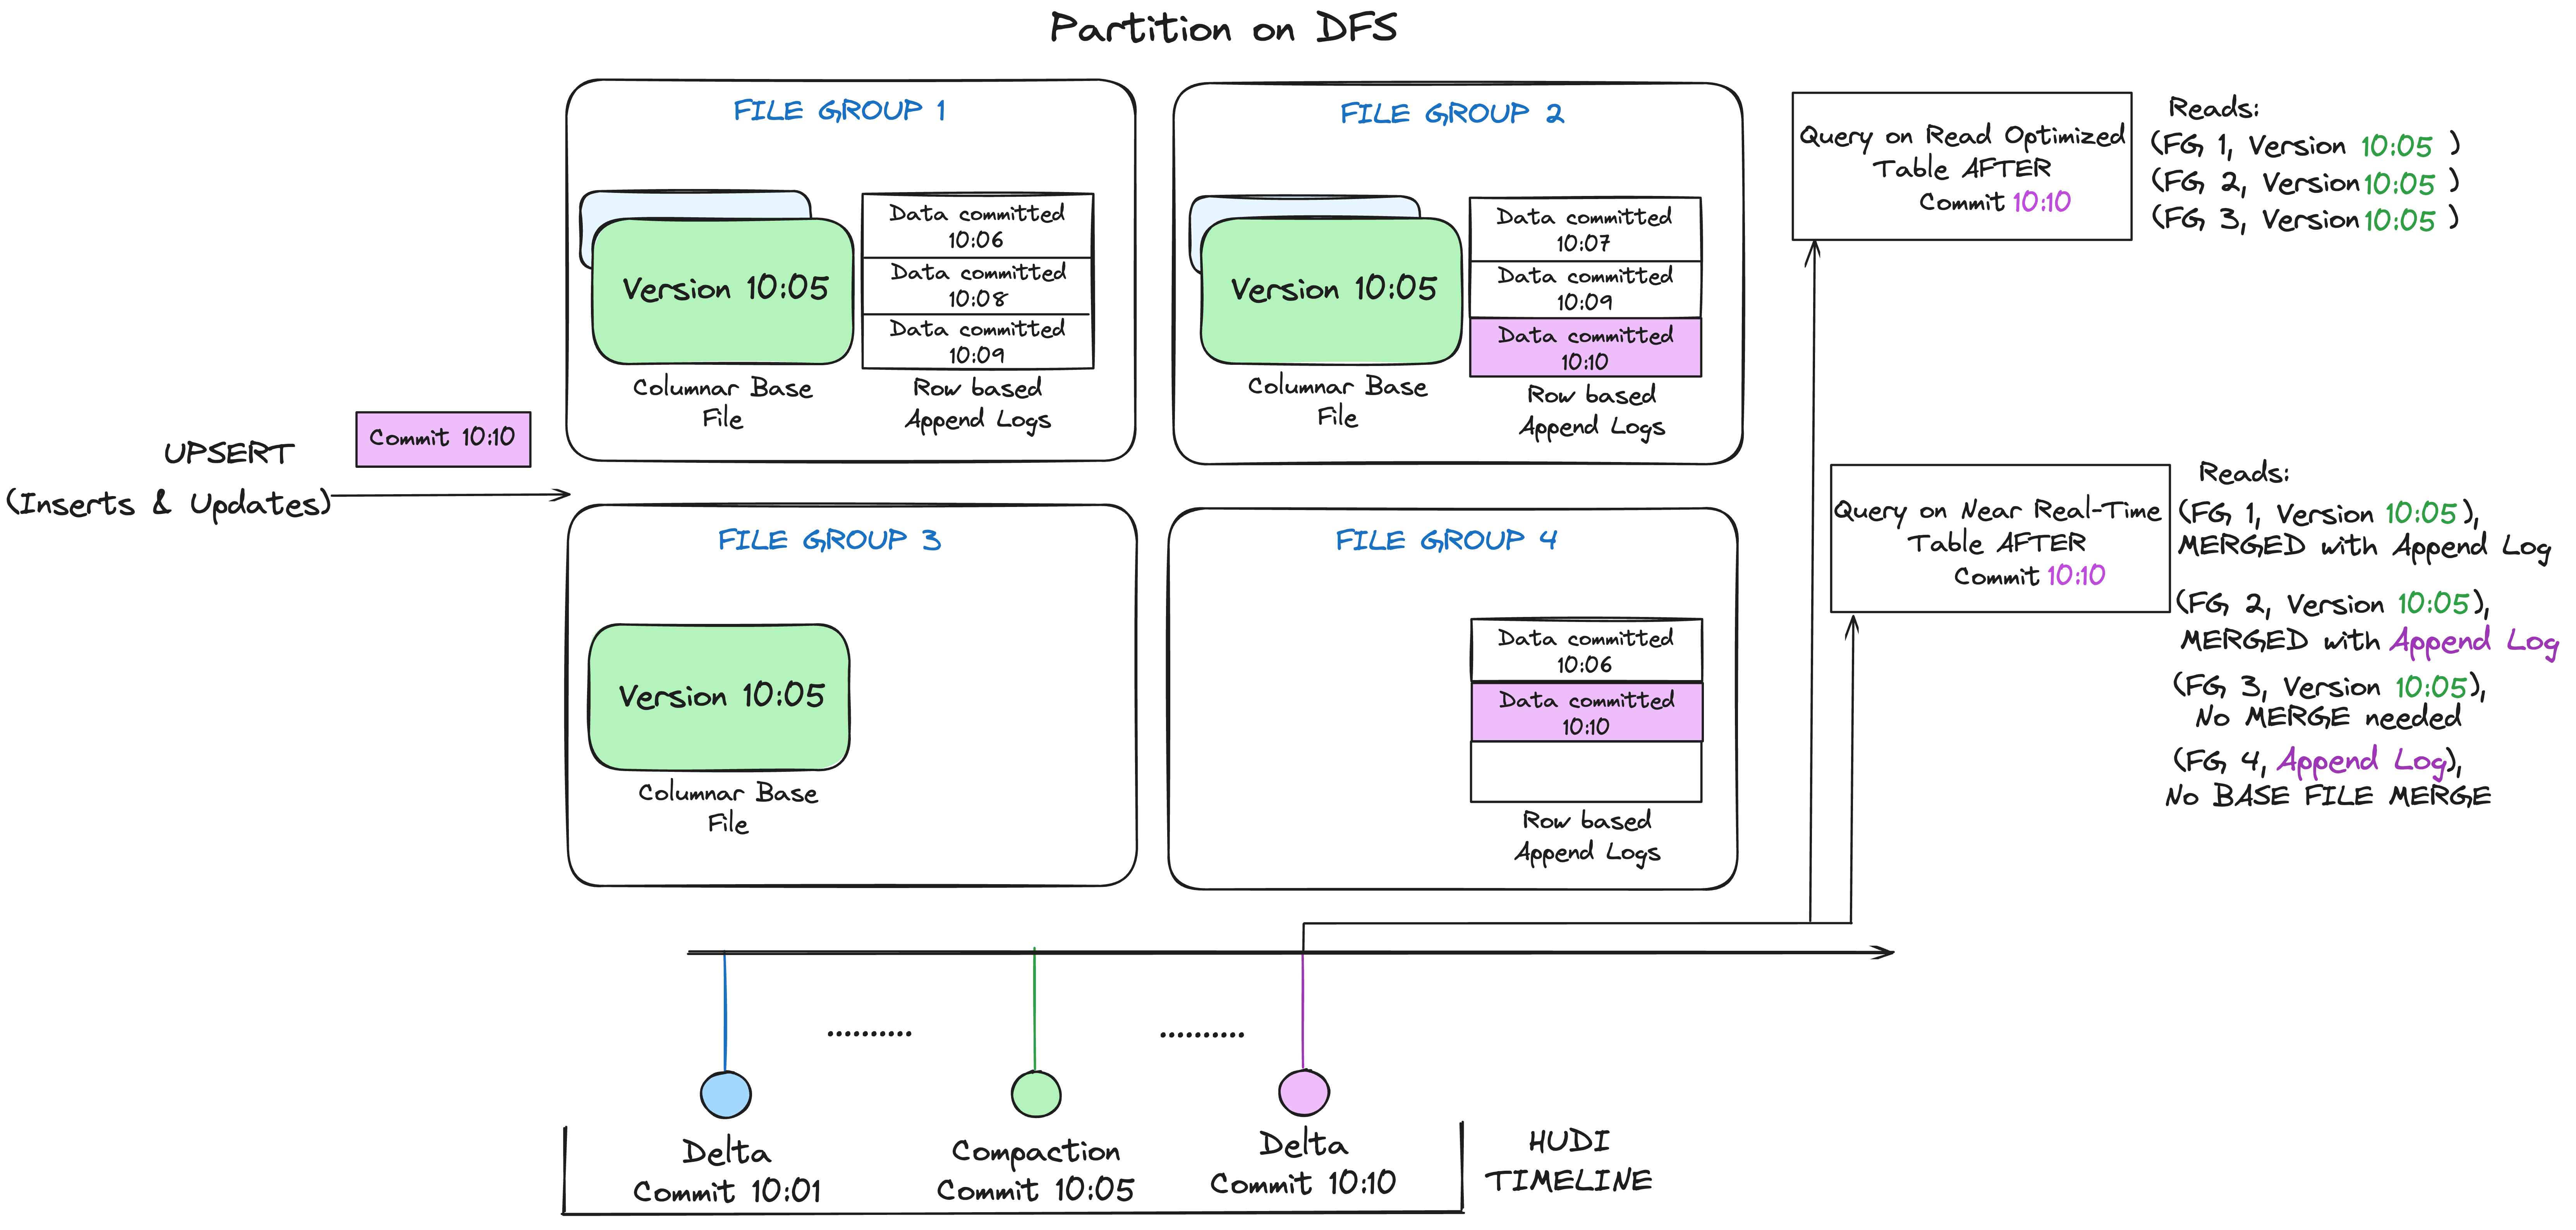
这个例子中发生了许多有趣的现象,充分体现了该方案中的细微之处。
- 由于写入更轻量,我们现在大约每 1 分钟就能产生更频繁的提交。
- 在每个文件组内部,现在存在 delta 日志文件,其中保存着对基础列式文件中记录的增量更新。在示例中,delta 日志文件保存了 10:05 到 10:10 之间完成的所有提交写入的数据。
- 基础列式文件会随压缩(提交操作)而产生新的版本。因此,如果只查看基础文件,那么表的布局看起来与写时复制表完全相同。
- 周期性的压缩进程会合并这些来自 delta 日志的变更,并生成一个新版本的基础文件,正如示例中 10:05 时发生的情况一样。
- 对同一张底层表有两种查询方式:读优化查询和快照查询,具体取决于你更看重查询性能还是数据的新鲜度。
- 对于读优化查询,某次提交的数据何时能被查询到,其语义会发生细微的变化。请注意,在 10:10 运行的读优化查询看不到上述 10:05 之后的数据,而快照查询始终能看到最新数据。因此,这一点必须与你选择的表压缩方式保持一致。
- 何时触发压缩,以及压缩时决定压缩哪些内容,是解决这些难题的关键所在。通过实施一种压缩策略——即对最新分区进行更积极的压缩,而对较旧的分区压缩得更少——我们可以确保读优化查询以一致的方式看到在 X 分钟内发布的数据。
读时复制表的目的是在分布式文件系统(DFS)之上直接支持近实时处理,而不是把数据复制到专门的系统中,因为这些系统可能无法处理这样的数据量。这种表还有一些次要的附带好处,例如通过避免数据的同步合并来降低写放大,即批量中每写入 1 字节数据实际产生的写入量。
MoR 表非常适合以下用例:
- 变更数据捕获(CDC)管道:结合合适的索引选择,MoR 表可提供业界领先的性能,能够跟上上游 RDBMS 或 NoSQL 存储中最具挑战性的写入模式所产生的变更捕获流。
- 流式数据摄取:MoR 表能够以最快速度将数据落地为行式格式,同时仍可借助异步后台压缩将其批量转换为列式格式(例如 Hudi 的 Kafka Connect Sink/Flink 集成)。这不仅能保证良好的数据新鲜度,还能带来更高的压缩比,从而让列式文件在长期使用中具备出色的查询性能。
- 混合批流工作负载:MoR 表可将延迟降低到分钟级,往往因此无需专门的流式存储,可在同一数据集上同时支持低延迟运营查询和批处理分析。此外,鉴于 MoR 天然对流处理友好(可以把 delta 日志想象成读取 Kafka segment),一些现有的流处理作业在 Hudi 的 source/sink 表上运行,相比使用 Kafka 更具成本效益。
- 频繁的更新与删除:高频更新的表,例如用户活动日志、交易跟踪、支付对账或库存跟踪,都可以受益于 MoR 表。类似地,在执行 GDPR/CCPA 等要求删除数据的合规计划时,MoR 能够累积全天陆续到达的删除记录,之后再进行一次压缩,从而摊销重写基础文件的成本,使总体成本降低 10 倍甚至更多。
对比
下表从宏观层面总结了这两种表类型的权衡取舍。
| 权衡项 | 写时复制(Copy-On-Write) | 读时合并(Merge-On-Read) |
|---|---|---|
| 写入延迟 | 更高 | 更低 |
| 查询延迟 | 更低 | 更高 |
| 更新成本 | 更高(重写整个基础文件) | 更低(追加到 delta 日志) |
| 基础文件大小 | 需要较小,以避免高昂的更新(I/O)成本 | 可以更大,因为更新成本低且可被摊销 |
| 读放大 | 0 | 对于查询读取的文件组:O(records_changed) |
| 写放大 | 对于给定的更新/删除模式最高,O(file_groups_written) | 对于写入的文件组:O(records_changed) |
在这里,读放大定义为读取每 1 字节实际数据所读取的字节数,写放大定义为每 1 字节实际变更数据写入存储时所写入的字节数。
查询类型
Hudi 支持以下查询类型。
- 快照查询(Snapshot Queries):查询看到的是截至最新已完成动作时表的最新快照。这就是大家平时在表上运行的普通 SQL 查询。在受支持的查询引擎上,Hudi 存储引擎会尽可能利用索引来加速这些快照查询。
- 时间旅行查询(Time Travel Queries):查询表在过去某个给定即时点的快照。时间旅行查询有助于访问活动时间线上的即时点或过去的存档点(savepoint)处表的多个版本(例如,机器学习特征存储,可在用于训练算法/模型的确切数据上对算法/模型进行打分)。
- 读优化查询(仅限 MoR 表):读优化查询通过纯列式文件(例如 Parquet 基础文件)提供出色的快照查询性能。用户通常会采用与事务边界对齐的压缩(compaction)策略,以提供表/分区的较旧一致视图。这适用于以下场景:将 Hudi 表作为外部表集成到通常只查询列式基础文件的数据仓库中,或者适用于不敏感于延迟、更看重效率而非数据新鲜度的 ML/AI 训练任务。
- 增量查询(最新状态):增量查询仅返回自时间线上的某个即时点以来新写入表中的数据。它提供自表的某个时间点以来插入/更新记录的最新值(即针对每个记录键,查询输出 1 条记录)。可用于对两个时间点之间的表状态进行"差异"比较。
- 增量查询(CDC):这是另一类增量查询,可从 Hudi 表中提供类似数据库的变更数据捕获(change data capture)流。CDC 查询的输出包含自某个时间点以来或两个时间点之间被插入、更新或删除的记录,每条变更记录都带有变更前镜像(before image)和变更后镜像(after image),以及导致该变更的操作。
下表总结了快照查询与读优化查询之间的权衡。
| 权衡 | 快照查询 | 读优化查询 |
|---|---|---|
| 数据延迟 | 更低 | 更高 |
| 查询延迟 | 更高(合并基础/列式文件 + 基于行的增量/日志文件) | 更低(原始基础/列式文件的性能) |
增量查询
对于初次接触流式系统或变更数据捕获(CDC)的用户,本节通过一个小示例来帮助理解增量查询的意义。将其正确应用于数据管道,可以大幅降低成本,并成倍提升效率。
为此,我们以一个存储 orders 的 Hudi 表为例,该表按小时分区,分区表示订单下单的小时。该表持续从上游来源接收更新。
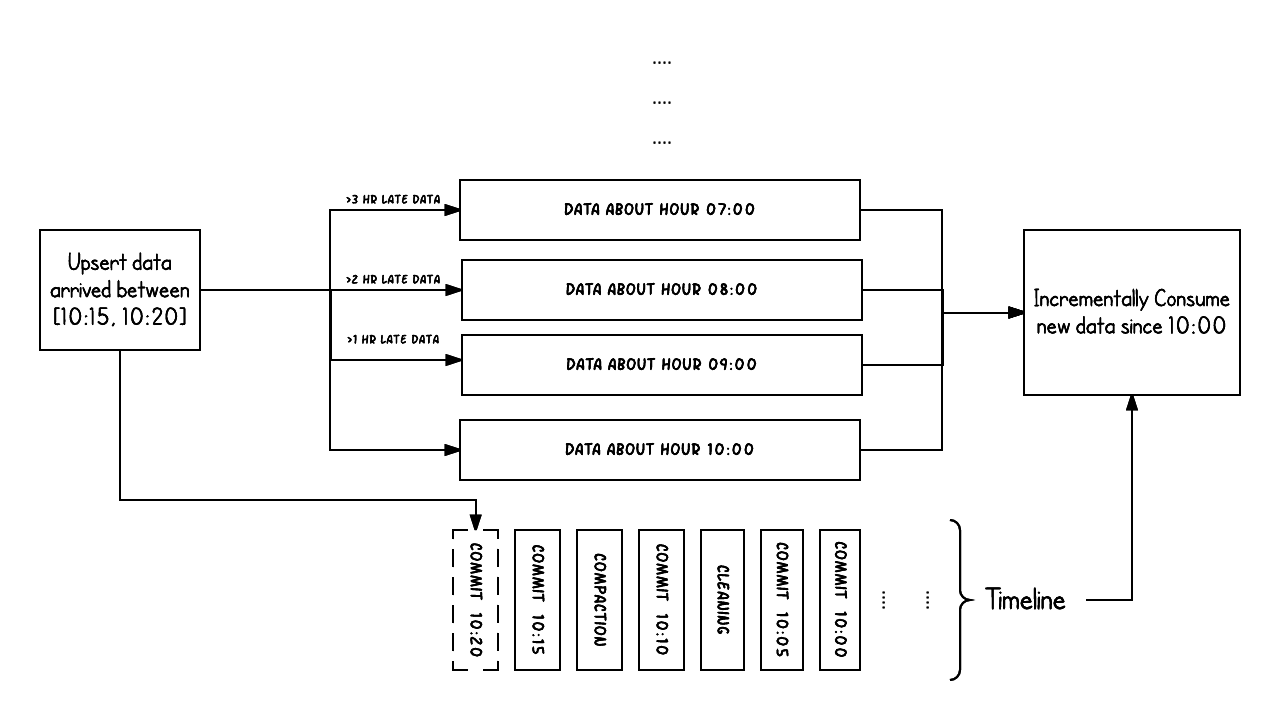
上面的示例展示了在 10:00 到 10:20 之间 Hudi 表上发生的更新插入操作,大约每 5 分钟一次,这些操作连同其他后台的清理/压缩任务,会在 Hudi 时间线上留下提交元数据。基于这个简单的示例,可以轻松理解超越批处理的流式世界中的两个关键概念。当存在迟到数据时(属于 9:00 这一小时的订单在 10:20 才延迟超过 1 小时被更新/插入),我们可以看到更新插入操作将新数据写入了更早的小时分区。时间线上的提交实例表示数据的 arrival time(到达时间,即上午 10:20),而实际的数据组织方式则反映了该记录所属的、或数据本应归属的实际时间值,即 event time(事件时间,即从 09:00 开始的小时分桶)。
了解记录在事件时间和到达时间两个维度上的变化情况,有助于构建非常高效的增量处理管道。借助时间线和记录级元数据,一个尝试获取自 10:00 以来成功提交的所有新数据的增量查询,可以非常高效地仅消费发生变化的记录,而无需例如扫描所有大于 07:00 的时间分桶——这是批处理 ETL 作业/SQL 中的典型做法。此外,它还支持使用常规过滤器(例如 where hourly_partition='09')基于事件时间进行便捷过滤。
有关查询类型的配置,请参见下文。
查询配置
以下是与不同查询类型相关的配置。
Spark 配置
配置名称默认值描述
hoodie.datasource.query.typesnapshot(可选)数据需要以何种模式读取:incremental 模式(自某个 instantTime 以来的新数据)、read_optimized 模式(基于基础文件获取最新视图)或 snapshot 模式(通过合并基础文件和(如有)日志文件获取最新视图)
Config Param: QUERY_TYPE
hoodie.datasource.read.begin.instanttimeN/A **(必填)**当 hoodie.datasource.query.type 设置为 incremental 时必须填写。表示开始增量拉取数据的 instant 时间。此处的 instanttime 不一定对应时间线上的某个 instant。instant_time 大于 BEGIN_INSTANTTIME 的新写入数据会被取出。例如:'20170901080000' 将获取 2017 年 9 月 1 日上午 08:00 之后写入的所有新数据。注意,如果 hoodie.datasource.read.handle.hollow.commit 设置为 USE_STATE_TRANSITION_TIME,则将使用 instant 的 stateTransitionTime 进行比较。接受的格式:yyyyMMddHHmmss[SSS]、yyyy-MM-dd、yyyy-MM-dd HH:mm:ss[.SSS]、yyyy-MM-ddTHH:mm:ss[.SSS]、epoch 秒(10 位)、epoch 毫秒(13 位),或 earliest。无效值会立即抛出错误。
Config Param: BEGIN_INSTANTTIME
hoodie.datasource.read.end.instanttimeN/A **(必填)**当 hoodie.datasource.query.type 设置为 incremental 时使用。表示限制增量拉取数据的结束 instant 时间。未指定时,默认取时间线上最新的提交时间。指定后,instant_time 小于等于 END_INSTANTTIME 的新写入数据会被取出。指定开始和结束 instant 时间的时点类型查询更有意义。注意,如果 hoodie.datasource.read.handle.hollow.commit 设置为 USE_STATE_TRANSITION_TIME,则将使用 instant 的 stateTransitionTime 进行比较。接受的格式:yyyyMMddHHmmss[SSS]、yyyy-MM-dd、yyyy-MM-dd HH:mm:ss[SSS]、yyyy-MM-ddTHH:mm:ss[.SSS]、epoch 秒(10 位)、epoch 毫秒(13 位),或 earliest。无效值会立即抛出错误。
Config Param: END_INSTANTTIME
hoodie.datasource.query.incremental.formatlatest_state (可选)该配置与 'incremental' 查询类型配合使用。
设置为 latest_state 时,返回最新记录的值;设置为 cdc 时,返回 CDC 数据。
Config Param: INCREMENTAL_FORMATSince Version: 0.13.0
as.of.instantN/A **(必填)**时间旅行查询的查询 instant。仅在时间旅行查询场景中为必填。若未指定,查询将返回最新的快照。接受的格式:yyyyMMddHHmmss[SSS]、yyyy-MM-dd、yyyy-MM-dd HH:mm:ss[.SSS]、yyyy-MM-ddTHH:mm:ss[.SSS]、epoch 秒(10 位)、epoch 毫秒(13 位)。无效值会立即抛出错误。
Config Param: TIME_TRAVEL_AS_OF_INSTANT
更多详情请参阅此处
Flink 配置
| 配置名称 | 默认值 | 描述 |
|---|---|---|
| hoodie.datasource.query.type | snapshot (可选) | 决定数据文件的读取方式:1) 快照模式(基于行式与列式数据获取最新视图);2) 增量模式(获取某个 instantTime 以来的新数据)。如果设置了 cdc.enabled,则可以对 CDC 数据执行增量查询;3) 读优化模式(基于列式数据获取最新视图)。默认值:snapshot |
Config Param: QUERY_TYPE
read.start-commit无 (必填) 在增量查询时必须提供。用于读取的起始提交瞬间,提交时间格式应为 'yyyyMMddHHmmss',默认从最新的瞬间开始读取以进行流式读取。
Config Param: READ_START_COMMIT
read.end-commit无 (必填) 在增量查询场景中使用。用于读取的结束提交瞬间,提交时间格式应为 'yyyyMMddHHmmss'。
Config Param: READ_END_COMMIT
更多详情请参阅此处。
视频
评论
登录后参与评论