 KnowForge

关于这本书
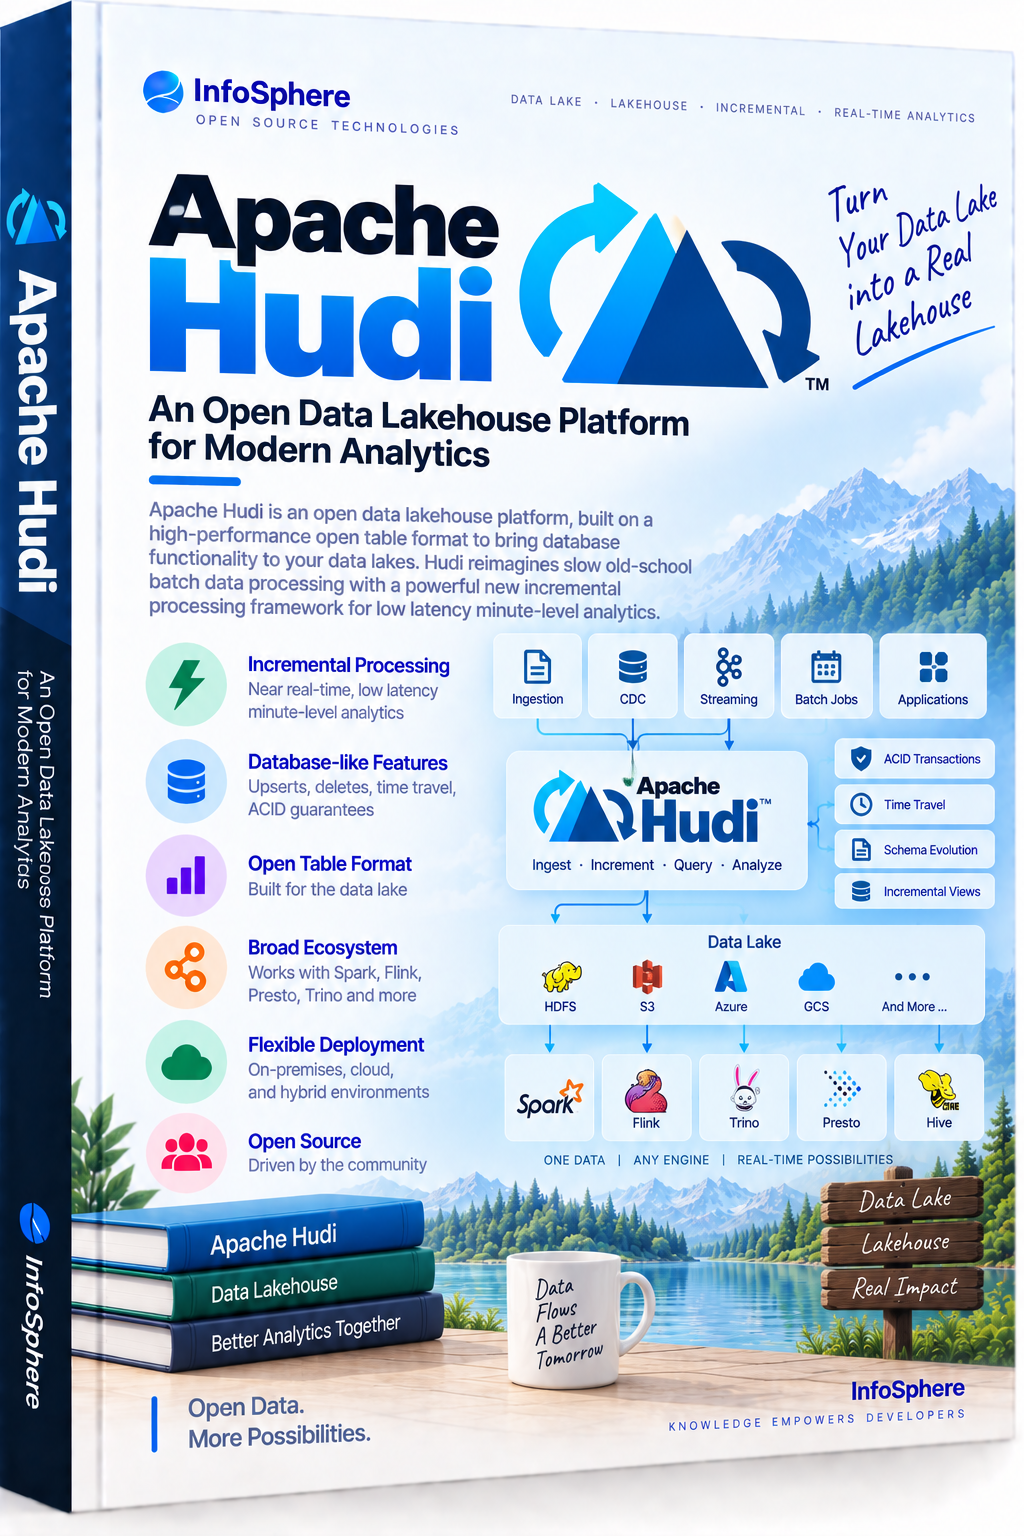
Apache Hudi 是一个开源的数据湖仓平台,构建在高性能的开源表格式之上,为您的数据湖带来数据库功能。Hudi 通过强大的全新增量处理框架重新构想缓慢的传统批处理,实现低延迟的分钟级分析。
目录
共 10 个章节· 全部 80 节- 01快速入门 概述 Spark 快速入门 Flink 快速入门…7 节
- 02设计与概念 Hudi 技术栈 时间线 存储布局…11 节
- 03数据接入 使用 Spark 使用 Flink 使用 Kafka Connect3 节
- 04写入表 SQL DDL SQL DML 批量写入…4 节
- 05读取表 SQL 查询 批量读取 流式读取3 节
- 06表服务 压缩 聚簇 清理…7 节
- 07数据目录 AWS Glue 数据目录 Google BigQuery DataHub…6 节
- 08平台与工具 导出器 数据质量 提交后回调…5 节
- 09运维 Hudi 性能 部署 SQL 存储过程…9 节
- 10配置项 基础配置 全部配置 存储配置3 节
你可能也喜欢
ApacheApache Iceberg+1
已完成
Apache Polaris 是 Apache Iceberg™ 表的目录实现,基于开源的 Apache Iceberg™ REST 协议构建。
20
2026-09-29
ApacheDataFusion+2
Apache DataFusion 简体中文已完成
DataFusion 是一个用 Rust 编写的可扩展查询引擎,使用 Apache Arrow 作为其内存格式。
8
2026-09-28