 KnowForge
索引
 师成· 更新于 2026-09-29· 阅读 45 分钟· 0 次阅读
在数据库中,索引是为了快速定位所需记录而维护的辅助数据结构,避免从存储中读取不必要的数据。鉴于 Hudi 的设计已针对处理可变的变更流及其多样化的写入模式做了大量优化,Hudi 将索引视为其设计中不可分割的一部分,并自创立之初就独有地支持索引能力,以加速数据湖仓上的写入,同时仍保持列式查询性能。
键到文件组的映射
Hudi 中最基础的索引机制会维护一个从给定键(记录键,可选加上分区路径)到文件 ID 的一致映射。其他类型的索引(如二级索引)都建立在这一基础之上。记录键与文件组/文件 ID 之间的映射在记录的第一版写入某个文件组后就几乎不再改变。只有聚类(clustering)以及以“删除 + 插入”方式实现的跨分区更新,才会将记录键重新映射到另一个文件组。即便如此,在时间线上的任何已完成时刻,给定的记录键都恰好只关联一个文件组。
索引的必要性
对于写时复制(Copy-On-Write)表,索引通过避免与整个数据集进行关联来确定需要重写哪些文件,从而实现快速的 upsert/delete 操作。对于读时合并(Merge-On-Read)表,索引使 Hudi 能够限定任意给定基础文件需要合并的变更记录数量。具体而言,某个基础文件只需合并属于它的那些记录的更新。
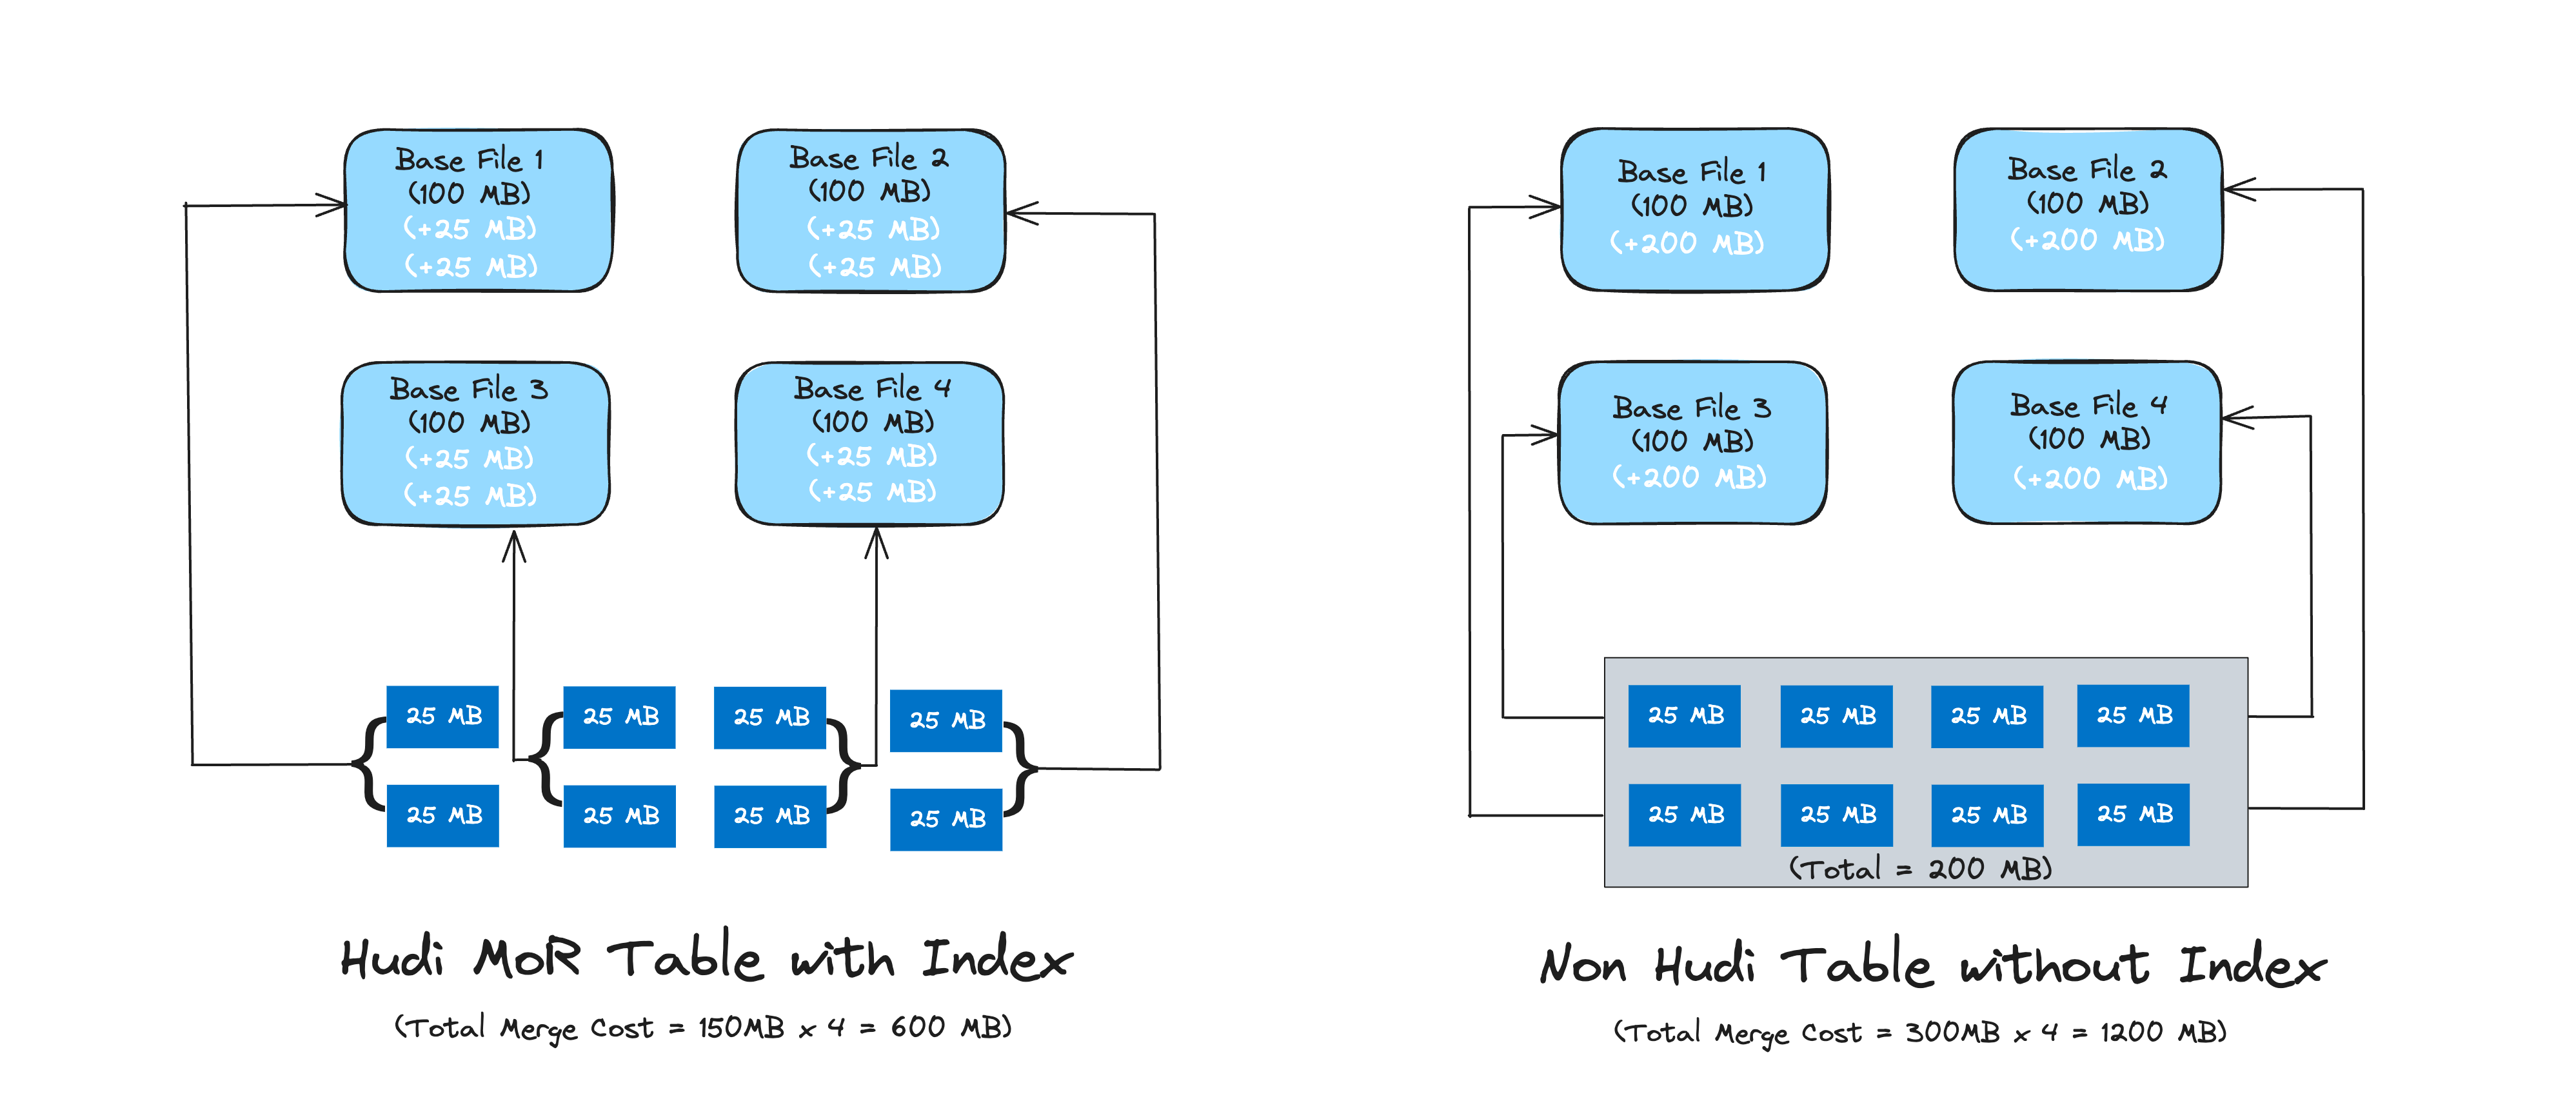
图:更新(深蓝色块)针对基础文件(浅蓝色块)的合并开销对比
相比之下,
- 没有索引组件的设计(例如 Apache Hive/Apache Iceberg)最终不得不将所有基础文件与所有传入的更新/删除记录进行合并(读放大高达 10-100 倍)。
- 采用重度写优化 OLTP 数据结构(如 LSM 树)的设计则不需要索引组件。但它们在云存储上执行扫描密集型负载时表现不佳,因此不适合提供分析查询服务。
Hudi 的优势在于:以索引带来的额外存储成本为代价,同时实现了出色的写入性能和读取性能——而这一索引还能解锁更多能力,我们将在下文探讨。
多模态索引 于 Hudi 0.11.0 版本引入,是对湖仓中通用索引子系统应有形态的重新构想。多模态索引通过增强元数据表来实现,使其能够以新分区的形式灵活扩展新的索引类型,并配合异步索引构建。
Hudi 通过增强元数据表,使其具备整合新型索引的能力,并辅以异步的索引构建机制,从而支持多模态索引。这一增强使得元数据表能够容纳多种索引,显著提升了表的写入和读取效率。
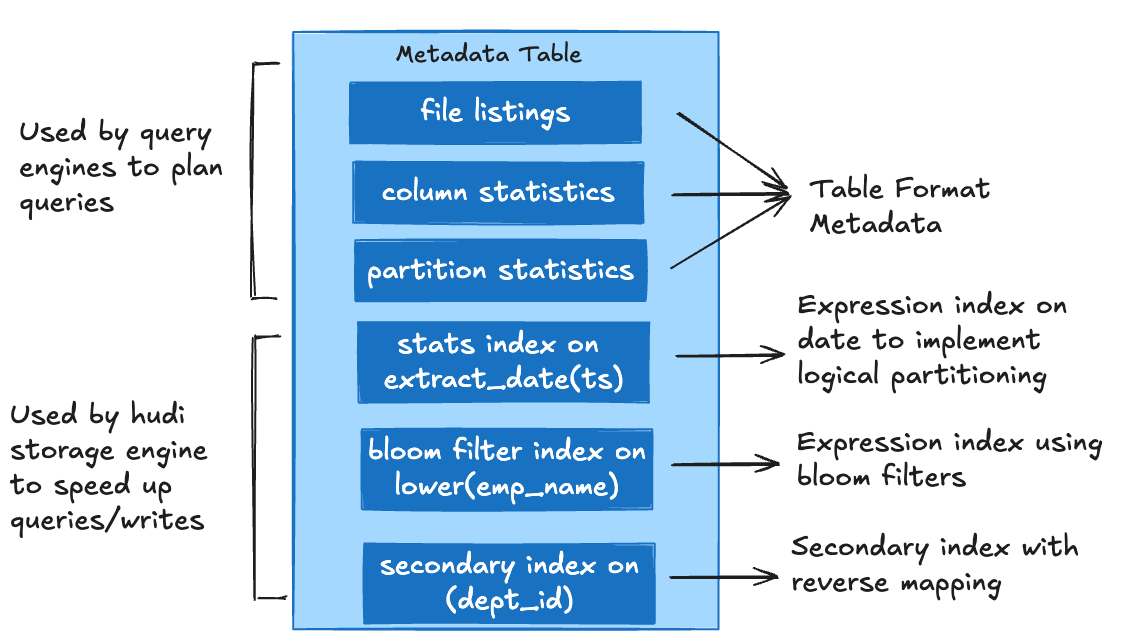
图:Hudi 中的索引
布隆过滤器
布隆过滤器索引以 bloom_filter 分区的形式存储在元数据表中。该索引对记录键的最小值和最大值采用基于范围的剪枝,并使用基于布隆过滤器的查找来标记传入记录。对于大型表而言,这意味着需要读取所有匹配数据文件的 footer 以获取布隆过滤器,当更新随机分布在整个数据集上时,这种开销可能很大。该索引将所有数据文件的布隆过滤器集中存储,避免直接扫描所有数据文件的 footer。
以下是控制启用和配置布隆过滤器的相关配置项。
| 配置名称 | 默认值 | 描述 |
|---|---|---|
| hoodie.metadata.index.bloom.filter.enable | false | 是否在元数据表中对用户数据文件的布隆过滤器建立索引。启用后,元数据表将包含一个用于存储布隆过滤器索引的分区,并在索引查找时使用。Config Param: ENABLE_METADATA_INDEX_BLOOM_FILTERSince Version: 0.11.0 |
| hoodie.bloom.index.prune.by.ranges | true | 仅当索引类型为 BLOOM 时适用。为 true 时,利用文件中的范围信息来加速索引查找。如果键具有单调递增的前缀(例如时间戳),该配置尤为有用。如果记录键完全随机,建议关闭此配置,因为范围剪枝只会给索引查找带来额外开销。Config Param: BLOOM_INDEX_PRUNE_BY_RANGES |
hoodie.bloom.index.update.partition.path false 仅在索引类型为 GLOBAL_BLOOM 时适用。设置为 true 时,若更新操作中包含已存在记录的分区路径,则会将传入的记录插入到新分区,并删除旧分区中的原始记录。设置为 false 时,原始记录仅在旧分区中被更新Config Param: BLOOM_INDEX_UPDATE_PARTITION_PATH_ENABLE
hoodie.bloom.index.use.metadata false 仅在索引类型为 BLOOM 时适用。设置为 true 时,索引查找将使用元数据表中的布隆过滤器和列统计信息(如果可用),以加快处理速度。Config Param: BLOOM_INDEX_USE_METADATASince Version: 0.11.0
hoodie.metadata.index.bloom.filter.column.list (N/A) 以逗号分隔的列列表,将为这些列构建布隆过滤器索引。如果未设置,则仅对 record key 建立索引。Config Param: BLOOM_FILTER_INDEX_FOR_COLUMNSSince Version: 0.11.0
hoodie.metadata.index.bloom.filter.file.group.count 4 元数据布隆过滤器索引分区的文件组数量。该配置控制基础文件和日志文件的大小以及布隆过滤器索引分区的读取并行度。建议将文件组数量设置为使基础文件小于 1GB。Config Param: METADATA_INDEX_BLOOM_FILTER_FILE_GROUP_COUNTSince Version: 0.11.0
Record Index
Record Index 存储在元数据表的 record_index/ 分区中,包含 record key 到位置的映射。该索引有助于比其他现有索引更快地定位记录,在索引查找主导写入延迟的大型部署中,可提供数量级的加速。为适应极高的数据规模,它采用了基于哈希的键空间分片。此外,在读取数据时,该索引支持点查,显著加快索引映射的检索过程。
Hudi 支持 Record Index 的两种变体:
- 全局 Record Index(Global Record Index):强制表中所有分区的键唯一性。这是在 0.14.0 中引入的默认变体。
- 分区 Record Index(Partitioned Record Index):保证分区路径和 record key 组合的唯一性。该变体通过将索引查找限制在相关分区中,加速超大分区数据集的查找。在 1.1.0 中引入。
以下是控制写入端启用 Record Index 构建和维护的配置。
| 配置名称 | 默认值 | 描述 |
|---|---|---|
hoodie.metadata.record.index.enable |
false |
在元数据表中创建 HUDI 全局 Record Index(已废弃,请使用 hoodie.metadata.global.record.level.index.enable)Config Param: RECORD_INDEX_ENABLE_PROPSince Version: 0.14.0 |
hoodie.metadata.global.record.level.index.enable |
false |
在元数据表中启用全局 Record Index。启用后,将强制表中所有分区的键唯一性。Config Param: GLOBAL_RECORD_LEVEL_INDEX_ENABLE_PROPSince Version: 0.14.0 |
hoodie.metadata.record.level.index.enable false 启用元数据表内的分区 Record Index。启用后,可保证分区路径与记录键组合的唯一性,从而加快超大分区数据集中的查找速度。Config Param: RECORD_LEVEL_INDEX_ENABLE_PROPSince Version: 1.1.0
hoodie.metadata.record.index.growth.factor 2.0 在自动估算需要创建的文件组数量时,将当前记录数乘以该系数。这有助于为数据集中记录数量的增长预留空间。Config Param: RECORD_INDEX_GROWTH_FACTOR_PROPSince Version: 0.14.0
hoodie.metadata.record.index.max.filegroup.count 10000 Record Index 可使用的最大文件组数量。Config Param: RECORD_INDEX_MAX_FILE_GROUP_COUNT_PROPSince Version: 0.14.0
hoodie.metadata.record.index.max.filegroup.size 1073741824 单个文件组的最大字节大小。文件组越大,合并(compact)所需的时间越长。Config Param: RECORD_INDEX_MAX_FILE_GROUP_SIZE_BYTES_PROPSince Version: 0.14.0
hoodie.metadata.record.index.min.filegroup.count 10 Global Record Index 可使用的最小文件组数量。Config Param: RECORD_INDEX_MIN_FILE_GROUP_COUNT_PROPSince Version: 0.14.0
注意: 对于全局记录索引,请改用 hoodie.metadata.global.record.level.index.min.filegroup.count。
hoodie.metadata.global.record.level.index.min.filegroup.count 10 Global Record Index 可使用的最小文件组数量。Config Param: GLOBAL_RECORD_LEVEL_INDEX_MIN_FILE_GROUP_COUNT_PROPSince Version: 0.14.0
hoodie.metadata.global.record.level.index.max.filegroup.count 10000 Global Record Index 可使用的最大文件组数量。Config Param: GLOBAL_RECORD_LEVEL_INDEX_MAX_FILE_GROUP_COUNT_PROPSince Version: 0.14.0
hoodie.metadata.record.level.index.min.filegroup.count 1 分区 Record Index 可使用的最小文件组数量。Config Param: RECORD_LEVEL_INDEX_MIN_FILE_GROUP_COUNT_PROPSince Version: 1.1.0
hoodie.metadata.record.level.index.max.filegroup.count 10 分区 Record Index 可使用的最大文件组数量。Config Param: RECORD_LEVEL_INDEX_MAX_FILE_GROUP_COUNT_PROPSince Version: 1.1.0
hoodie.record.index.update.partition.path false 与键 'hoodie.bloom.index.update.partition.path' 类似,默认值:true,isAdvanced:true,说明:仅在索引类型为 GLOBAL_BLOOM 时适用。设置为 true 时,若更新操作涉及已存在记录的分区路径,会将传入的记录插入到新分区,并删除旧分区中的原记录。设置为 false 时,原记录仅在旧分区中被更新。since version:version 未定义,deprecated after:version 未定义,但适用于 record index。Config Param: RECORD_INDEX_UPDATE_PARTITION_PATH_ENABLESince Version: 0.14.0
表达式索引
表达式索引是针对某列函数建立的索引。如果查询中包含对该列函数的谓词,则可以使用表达式索引来加速查询。表达式索引存储在元数据表中以 expr_index_ 为前缀的分区下(每个表达式索引对应一个分区)。表达式索引可以使用 SQL 语法创建,详情请参阅 SQL DDL 文档。
以下是控制写入端是否启用表达式索引构建与维护的配置项。
配置名称默认值描述
hoodie.metadata.index.expression.enablefalse在元数据表中启用表达式索引。当此配置属性被启用(true)时,Hudi 写入端会自动保持所有表达式索引与数据表一致。当被禁用(false)时,所有表达式索引都会被删除。请注意,单个表达式索引只能通过 Spark SQL 中的 CREATE INDEX 语句创建,并通过 DROP INDEX 语句删除。Config Param: EXPRESSION_INDEX_ENABLE_PROPSince Version: 1.0.0
hoodie.metadata.index.expression.file.group.count2元数据表达式索引分区的文件组数量。Config Param: EXPRESSION_INDEX_FILE_GROUP_COUNTSince Version: 1.0.0
hoodie.expression.index.function(无)用于构建表达式索引的函数。Config Param: INDEX_FUNCTIONSince Version: 1.0.0
hoodie.expression.index.name(无)表达式索引的名称。该名称同时用作元数据表中的分区名称。Config Param: INDEX_NAMESince Version: 1.0.0
hoodie.expression.index.typeCOLUMN_STATS表达式索引的类型。如果命令中没有函数和表达式,默认值为 column_stats。可选的有效值包括 BITMAP、COLUMN_STATS、LUCENE 等。如果未提供 index_type,且命令中存在函数或表达式,则会创建一个基于列统计信息的表达式索引。Config Param: INDEX_TYPESince Version: 1.0.0
二级索引
二级索引允许用户在 Hudi 表中不属于记录键(record key)列的列上创建索引(对于记录键字段,Hudi 支持记录级索引)。二级索引可用于加速对非记录键列设置谓词的查询。
以下是控制写入端是否启用二级索引构建与维护的配置项。
配置名称默认值描述
hoodie.metadata.index.secondary.enabletrue (可选) 在元数据表中启用二级索引。当此配置属性启用(true)时,Hudi 写入器会自动保持所有二级索引与数据表的一致性。当禁用(false)时,所有二级索引将被删除。注意,单个二级索引只能通过 Spark SQL 中的 CREATE INDEX 语句创建,并通过 DROP INDEX 语句删除。Config Param: SECONDARY_INDEX_ENABLE_PROPSince Version: 1.0.0
hoodie.datasource.write.secondarykey.column(无) 构成二级键部分的列。实际值将通过对字段值调用 .toString() 获取。嵌套字段可以使用点号表示法指定,例如:a.b.cConfig Param: SECONDARYKEY_COLUMN_NAME
其他写入端索引
上述所有索引均可供读取器/写入器使用,它们通过与元数据表的集成来实现。此外,存储引擎还实现了其他索引机制,通过高效地读取/连接/处理传入记录,与存储在基文件/日志文件自身中的信息(例如存储在 Parquet 文件页脚中的布隆过滤器)或智能数据布局(例如桶索引)进行匹配。
目前,Hudi 支持以下索引类型。Spark 引擎的默认值为 SIMPLE,Flink 和 Java 引擎的默认值为 INMEMORY。写入器可以通过 hoodie.index.type 配置项选择其中一种选项。
SIMPLE(Spark 与 Java 引擎的默认值):这是 Spark 引擎的标准索引类型。它将传入记录与从磁盘上的表中检索到的键进行高效连接。它要求键在分区内唯一,才能正常工作。
RECORD_INDEX(已弃用):使用上一节中的全局记录索引作为写入端索引。该索引在 0.14.0 版本中引入。已弃用——请改用
GLOBAL_RECORD_LEVEL_INDEX实现全局唯一性,或使用RECORD_LEVEL_INDEX实现分区内唯一性。RECORD_LEVEL_INDEX:使用分区记录索引作为写入端索引。该变体保证分区路径与记录键组合的唯一性,并针对大型分区数据集进行了优化。自 1.1.0 版本起可用。
GLOBAL_RECORD_LEVEL_INDEX:使用全局记录索引作为写入端索引。该变体在表的所有分区之间强制保证键的唯一性。自 1.1.0 版本起可用。
BLOOM:使用由记录键生成的布隆过滤器,并可选择根据记录键的取值范围进一步缩小候选文件的范围。它要求键在分区内唯一,才能正常工作。
GLOBAL_BLOOM:使用由记录键生成的布隆过滤器,并可利用记录键的取值范围进一步细化候选文件的选择。它要求键在表/全局范围内唯一,才能正常工作。
GLOBAL_SIMPLE:将传入记录与从存储上的表中提取的键进行轻量连接。它要求键在表/全局范围内唯一,才能正常工作。
HBASE:通过 Apache HBase 中的外部表来管理索引映射。
INMEMORY:在 Spark 和 Java 引擎中使用内存哈希映射,在 Flink 中使用 Flink 内存状态来进行索引。请注意,当用于 Flink 写入器时,这是
FLINK_STATE的别名。FLINK_STATE(Flink 的默认值):使用 Flink 状态后端来存储索引数据,即记录键到其所驻留文件组的文件 ID 的映射。
BUCKET:利用桶哈希来定位承载这些记录的文件组,这在大规模场景下尤其具有优势。桶索引根据桶的配置和管理方式分为三个变体:
简单桶索引(默认):在所有分区上使用固定数量的桶。桶数量一经设定即不可更改,既不能增加也不能减少。同时适用于 COW 表和 MOR 表。通过
hoodie.index.bucket.engine=SIMPLE和hoodie.bucket.index.num.buckets进行设置。由于所有分区的桶数量统一,对于分区大小差异较大或存在数据倾斜的表可能并不理想。- 分区级桶索引:允许基于正则表达式模式匹配,为不同分区设置不同的固定桶数量。已有的简单桶索引表可以通过 Spark 的
partition_bucket_index_manager存储过程升级为分区级桶索引,该过程会重新调整受影响的分区。升级后,写入端(Flink/Spark)会自动从表元数据中加载各分区的桶配置。这解决了桶数量统一带来的局限性,同时保持了每个分区内桶的不可变性。同时适用于 COW 表和 MOR 表。配置项为hoodie.index.bucket.engine=SIMPLE、hoodie.bucket.index.partition.expressions以及hoodie.bucket.index.partition.rule.type=regex。 - 一致性哈希桶索引:支持动态的桶数量,并可通过聚类实现自动调整大小。初始桶数量确定后,可基于文件大小在配置的最小/最大范围内扩缩容。通过动态调整大小,解决了大体量分区中的数据倾斜问题。Flink 可以调度聚类计划,但目前执行仍需要 Spark。仅与 MOR 表兼容。配置项为
hoodie.index.bucket.engine=CONSISTENT_HASHING、hoodie.bucket.index.num.buckets(初始数量)、hoodie.bucket.index.min.num.buckets和hoodie.bucket.index.max.num.buckets。
- 分区级桶索引:允许基于正则表达式模式匹配,为不同分区设置不同的固定桶数量。已有的简单桶索引表可以通过 Spark 的
自带实现:你可以扩展这个公开 API,并通过
hoodie.index.class提供SparkHoodieIndex的子类(用于 Apache Spark 写入端)来实现自定义索引。
全局索引与非全局索引
另一个值得了解的关键点是全局索引与非全局索引的区别。布隆索引和简单索引都有全局选项,分别为 hoodie.index.type=GLOBAL_BLOOM 和 hoodie.index.type=GLOBAL_SIMPLE。Record 索引同时支持全局和分区两种变体:
- 全局 Record 索引(
RECORD_INDEX或GLOBAL_RECORD_LEVEL_INDEX):在所有分区范围内强制唯一性 - 分区 Record 索引(
RECORD_LEVEL_INDEX):在每个分区内部强制唯一性
HBase 索引本质上是一种全局索引。
- 全局索引: 全局索引在表的所有分区之间强制保证键的唯一性,即保证表中对于给定的记录键恰好存在一条记录。全局索引提供更强的保证,但更新/删除的开销仍可能随表的大小增长,为
O(size of table),因为记录可能属于存储中的任意分区。对于非全局索引,查找只涉及与传入记录相匹配的分区所对应的文件组,因此不受表总大小的影响。这些全局索引(GLOBAL_SIMPLE 或 GLOBAL_BLOOM)对于规模适中的表或许可以接受,但对于大表,0.14.0 版本新增的记录级索引(Record Level Index,RLI)相比其他全局索引(GLOBAL_SIMPLE 或 GLOBAL_BLOOM)或 HBase 能提供相当出色的索引查找性能,同时也避免了维护外部系统的运维开销。 - 非全局索引: 另一方面,默认的索引实现仅在特定分区内强制执行这一约束。可以想见,非全局索引依赖写入方在更新/删除时为给定的记录键提供一致的分区路径,但由于索引查找操作变为
O(number of records updated/deleted),其性能要好得多,并且能很好地随写入量进行扩展。
配置
基于 Spark 的配置
对于 Spark DataSource、Spark SQL、Hudi Streamer 和 Structured Streaming,以下是控制索引行为的关键配置。更多详情请参阅高级配置。所有这些配置均支持上文提到的索引类型。
| 配置名称 | 默认值 | 描述 |
|---|---|---|
| hoodie.index.type | 无 (必填) | org.apache.hudi.index.HoodieIndex$IndexType:决定输入记录如何被索引,即如何基于键在现有表中查找其位置。Spark 引擎上默认为 SIMPLE,Flink 和 Java 引擎上默认为 INMEMORY。可能的取值: - BLOOM - GLOBAL_BLOOM - SIMPLE - GLOBAL_SIMPLE - HBASE - INMEMORY - FLINK_STATE - BUCKET - RECORD_INDEX - RECORD_LEVEL_INDEX - GLOBAL_RECORD_LEVEL_INDEX Config Param: INDEX_TYPE |
| hoodie.index.bucket.engine | SIMPLE(可选) | org.apache.hudi.index.HoodieIndex$BucketIndexEngineType:当 hoodie.index.type 设置为 BUCKET 时,决定使用的分桶或哈希类型。可能的取值:- SIMPLE - CONSISTENT_HASHING Config Param: BUCKET_INDEX_ENGINE_TYPESince Version: 0.11.0 |
| hoodie.index.class | (可选) | 用户自定义索引类的完整路径,必须是 HoodieIndex 类的子类。如果指定了该配置,它将优先于 hoodie.index.type 配置。Config Param: INDEX_CLASS_NAME |
hoodie.simple.index.update.partition.pathtrue(可选)类似于 Key: hoodie.bloom.index.update.partition.path,仅适用于索引类型为 GLOBAL_SIMPLE 时。设置为 true 时,如果更新操作中记录的分区路径与存储中已存在记录的分区路径不同,则会将传入的记录插入到新分区中,并删除旧分区中的原始记录。设置为 false 时,原始记录只会在其所在的旧分区中被更新;当传入记录的分区值与存储中的分区值不一致时,将忽略新传入的分区。
Config Param: SIMPLE_INDEX_UPDATE_PARTITION_PATH_ENABLE
hoodie.hbase.index.update.partition.pathfalse(可选)仅适用于索引类型为 HBASE 时。当已存在的记录被更新(upsert)到与存储中不同的新分区时,设置该配置后,会删除旧分区中的原始记录,并将其作为新记录插入到新分区中。
Config Param: UPDATE_PARTITION_PATH_ENABLE
基于 Flink 的配置
对于 Flink DataStream 和 Flink SQL,支持 Bucket 索引、Flink state 索引以及记录级索引(record-level index)。以下是控制索引行为的基本配置。高级配置请参阅 Flink 配置。
Config NameDefaultDescription
index.typeFLINK_STATE(可选)Flink 写入作业的索引类型,默认使用基于 state 的索引。可能的取值:
- FLINK_STATE
- BUCKET
- GLOBAL_RECORD_LEVEL_INDEX
- RECORD_LEVEL_INDEX
Config Param: INDEX_TYPE
hoodie.index.bucket.engineSIMPLE(可选)org.apache.hudi.index.HoodieIndex$BucketIndexEngineType:当 hoodie.index.type 设置为 BUCKET 时,决定所使用的分桶或哈希方式。可能的取值:
- SIMPLE
- CONSISTENT_HASHING
metadata.enabledtrue(可选)启用 metadata table。Flink 记录级索引查询需要该配置。
index.global.enabledtrue(可选)当相同的 record key 以不同的分区路径到达时,是否更新旧的分区路径。对于 GLOBAL_RECORD_LEVEL_INDEX 必须设置为 true,对于 RECORD_LEVEL_INDEX 则设置为 false。
index.bootstrap.enabledfalse(可选)当 index.type=GLOBAL_RECORD_LEVEL_INDEX 时,控制 Flink 是否将全局索引引导(bootstrap)到本地 RocksDB 后端。如果全局 RLI 未显式设置该配置,Flink 默认会启用 bootstrap。设置为 false 则强制使用原生 metadata table 的 RLI 访问方式。
index.bootstrap.rocksdb.path(可选)当 index.bootstrap.enabled=true 时所使用的 RocksDB 后端的本地目录路径。每个 task manager 会在该路径下创建一个唯一的子目录。
index.rli.cache.size256(可选)每个 bucket-assign 任务为记录级索引缓存分配的最大内存,单位为 MB。适用于原生 metadata table 的 RLI 访问方式以及分区化的 RLI 缓存。
index.rli.cache.concurrent.partitions.num2(可选)预计并发更新其分区式 RLI 缓存的分区数量。在缺少历史缓存使用数据时,用于确定每个分区缓存的大小。
index.rli.lookup.minibatch.size1000(可选)用于小批量记录级索引查找的最大缓冲输入记录数。小批量处理可减少原生全局 RLI 访问时对元数据表的单次查找调用次数。
index.rli.write.buffer.size100(可选)索引记录写入缓冲区的最大内存,单位为 MB。达到该阈值时,Flink 会将索引记录刷写出去,以避免 OOM。
index.write.tasks(无)写入记录级索引记录的任务并行度。未设置时,默认使用执行环境的并行度。
metadata.compaction.schedule.enabledtrue(可选)调度元数据表的压缩计划。
metadata.compaction.async.enabledtrue(可选)在启用记录级索引流式写入时,在 Flink 压缩管道中运行元数据表压缩。
metadata.compaction.delta_commits10(可选)触发元数据压缩之前允许的最大元数据表增量提交数。
hoodie.metadata.record.level.index.defer.initfalse(可选)对全新表延迟初始化 RLI。Flink 摄入不支持延迟 RLI 初始化,因此进行 Flink RLI 写入时请保持该值为 false。
hoodie.metadata.global.record.level.index.min.filegroup.count10(可选)全局记录级索引使用的最小文件组数。
hoodie.metadata.global.record.level.index.max.filegroup.count10000(可选)全局记录级索引使用的最大文件组数。
hoodie.metadata.record.level.index.min.filegroup.count1(可选)分区式记录级索引使用的最小文件组数。新数据分区使用该值作为其初始分区式 RLI 文件组数,动态分桶分配在分区出现在元数据表之前也使用该值。
hoodie.metadata.record.level.index.max.filegroup.count10(可选)分区式记录级索引使用的最大文件组数。
常见的 Flink RLI 配置:
| 使用场景 | 必需设置 | 说明 |
|---|---|---|
| 原生 MDT 访问的 Flink 全局 RLI | index.type=GLOBAL_RECORD_LEVEL_INDEXmetadata.enabled=trueindex.global.enabled=trueindex.bootstrap.enabled=falsehoodie.metadata.record.level.index.defer.init=false |
Flink 直接从元数据表读取全局记录位置,并使用任务内的 RLI 缓存来处理最近访问的键。相比任务本地 RocksDB 状态,更希望共享元数据表索引时使用此方式。 |
| 本地 RocksDB 缓存的 Flink 全局 RLI | index.type=GLOBAL_RECORD_LEVEL_INDEXmetadata.enabled=trueindex.global.enabled=trueindex.bootstrap.enabled=trueindex.bootstrap.rocksdb.path=<local-path>hoodie.metadata.record.level.index.defer.init=false |
Flink 将全局 RLI 引导加载到本地 RocksDB 后端中。这样可以减少对元数据表的重复查找,代价是本地磁盘占用和引导加载时间。 |
带有分区 RLI 的动态桶扩展index.type=RECORD_LEVEL_INDEXmetadata.enabled=trueindex.global.enabled=falsehoodie.metadata.record.level.index.min.filegroup.count=<initial-filegroups-per-partition>hoodie.metadata.record.level.index.max.filegroup.count=<max-filegroups-per-partition>
还可以为分区缓存调整 index.rli.cache.size 和 index.rli.cache.concurrent.partitions.num。Flink 使用分区范围的 RLI 将已有键路由到其记录的文件组,并通过动态桶分配为新键分配文件组。这支持流式 upsert 和 insert overwrite 工作负载。
选择索引策略
由于数据的规模、写入速度各不相同,访问模式也存在差异,因此可以针对不同类型的工作负载使用不同的索引。下面我们将介绍一些典型的工作负载类型,看看如何为这类场景选用合适的 Hudi 索引。这些建议基于我们的实际经验,你需要认真评估这些策略是否同样适用于你的工作负载。
工作负载 1:事实表的延迟更新
许多公司在 NoSQL 存储中保存大量事务数据。例如,网约车的行程表、股票的买卖记录、电商平台的订单表等。这些表通常持续增长,大部分更新发生在最新的数据上,只有少量长尾更新会落在较早的数据上——原因可能是交易延迟结算或后期的数据修正。换句话说,大部分更新进入最新的分区,少量更新进入较旧的分区。
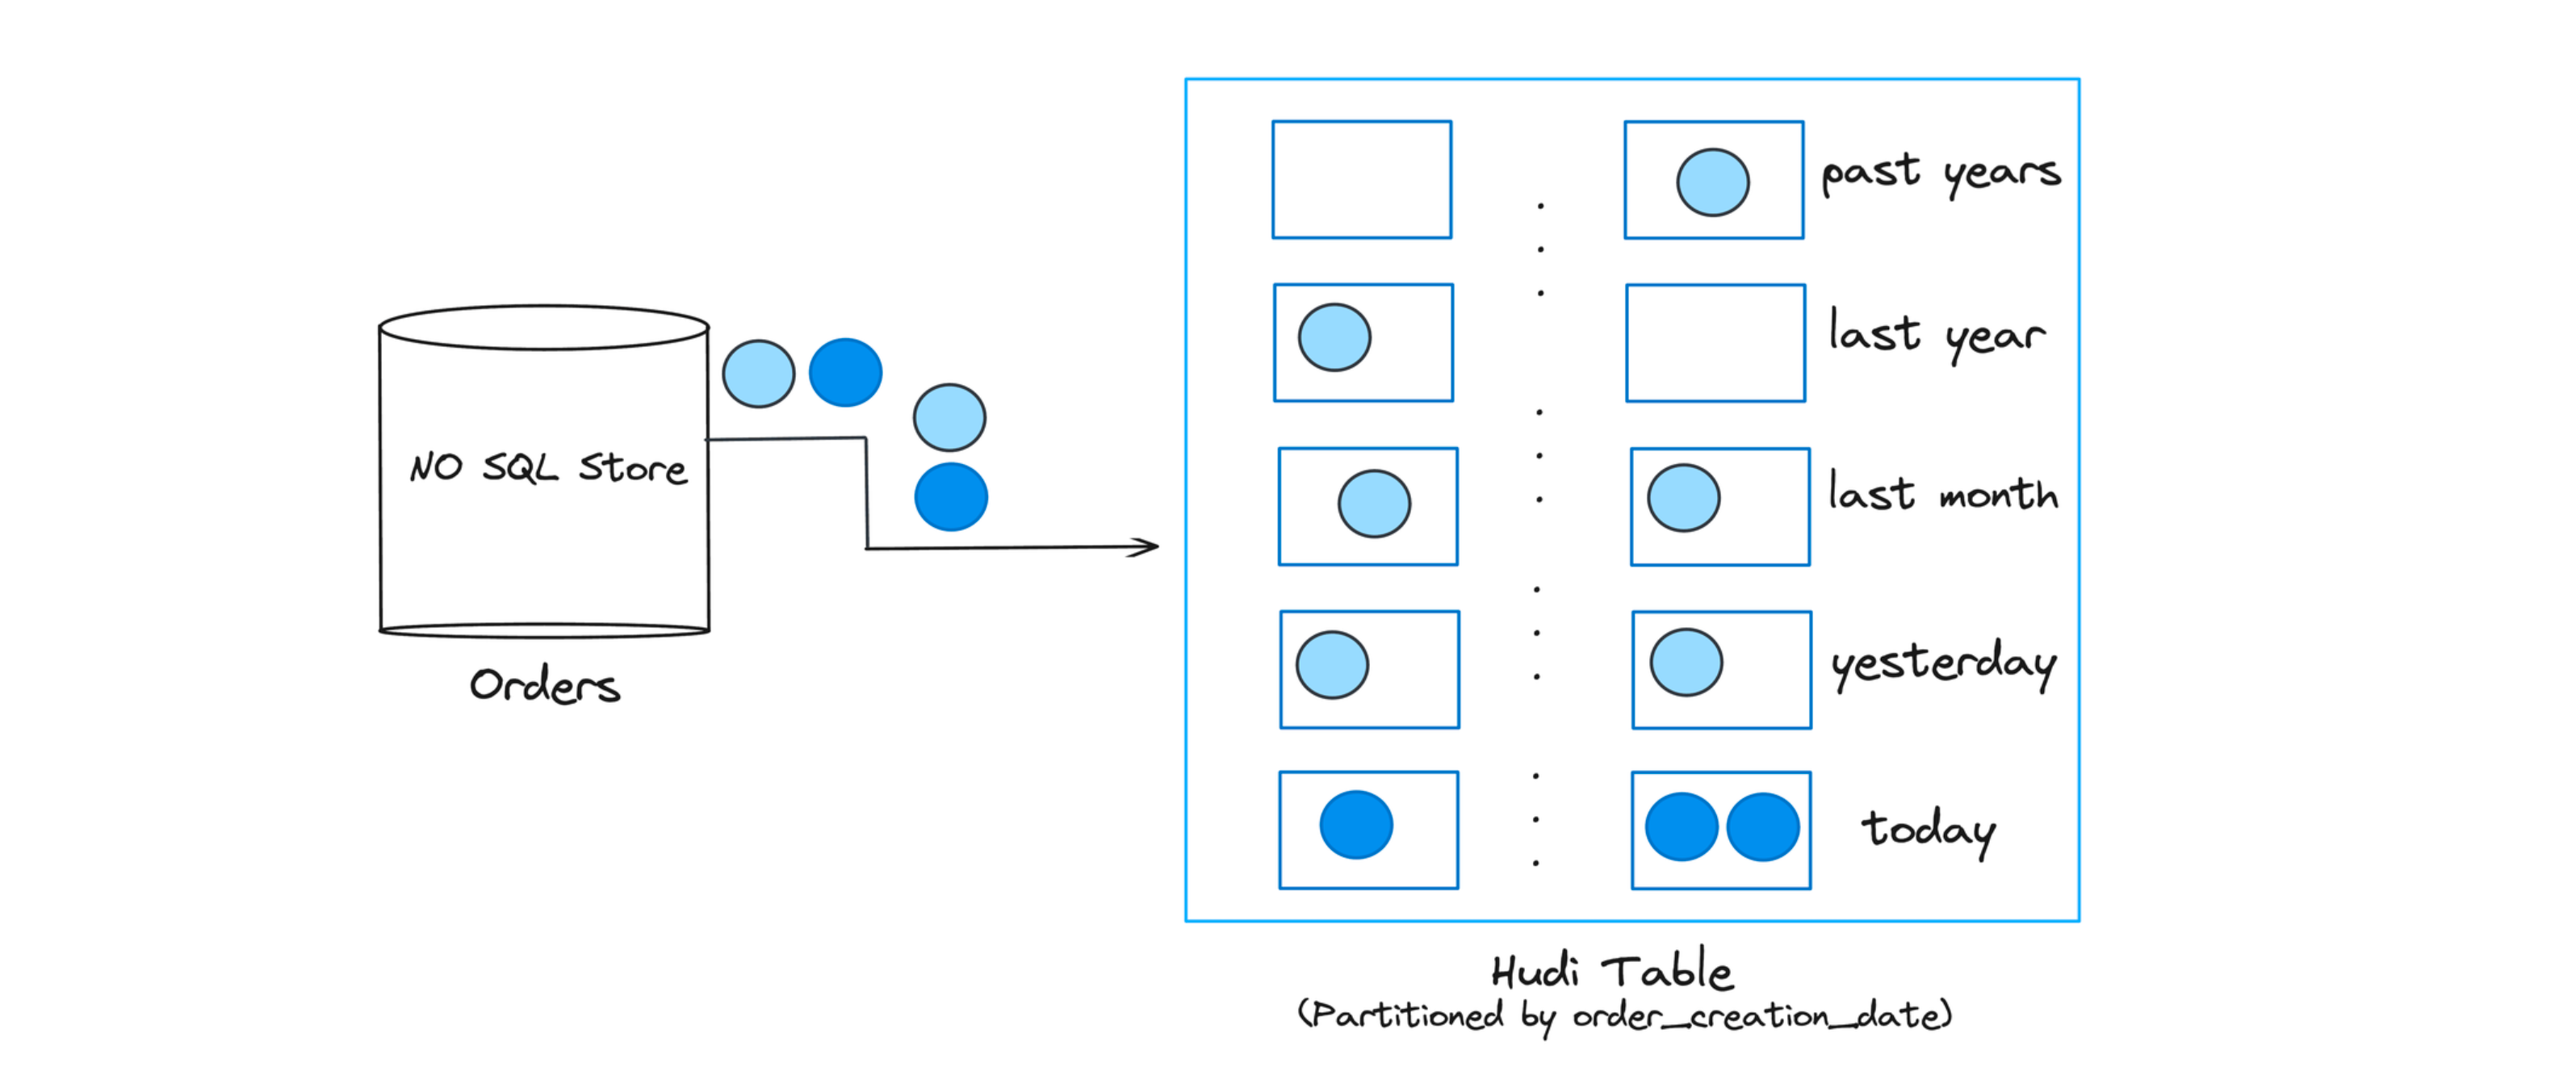
图:事实表的典型更新模式
对于这类工作负载,BLOOM 索引表现良好,因为索引查找会基于大小合适的布隆过滤器过滤掉大量数据文件。此外,如果键的构造具有一定的有序性,还可以通过范围剪枝进一步减少需要比较的文件数量。Hudi 会构建一棵包含所有文件键范围的区间树,从而高效地过滤掉与更新/删除记录中任何键范围都不匹配的文件。
为了高效地将传入记录的键与布隆过滤器进行比对,即以最少的布隆过滤器读取次数、并在各个执行器之间实现均匀的负载分布,Hudi 会对输入记录进行缓存,并采用一个自定义分区器,利用统计数据来消除数据倾斜。有时,如果布隆过滤器的误报率较高,可能会增加执行查找时的数据洗牌量。Hudi 支持动态布隆过滤器(通过 hoodie.bloom.index.filter.type=DYNAMIC_V0 启用),它会根据给定文件中存储的记录数量自动调整自身大小,以达到所配置的误报率。
工作负载 2:事件表的去重
事件流无处不在。来自 Apache Kafka 或类似消息总线的事件,其数据量通常是事实表的 10 到 100 倍,且往往将"时间"(事件到达时间/处理时间)作为一等公民来对待。例如物联网事件流、点击流数据、广告曝光等。插入和更新通常只涉及最近的几个分区,因为这类数据大多是仅追加的。由于重复事件可能在端到端管道的任何环节引入,因此在存入数据湖之前进行去重是一项常见需求。
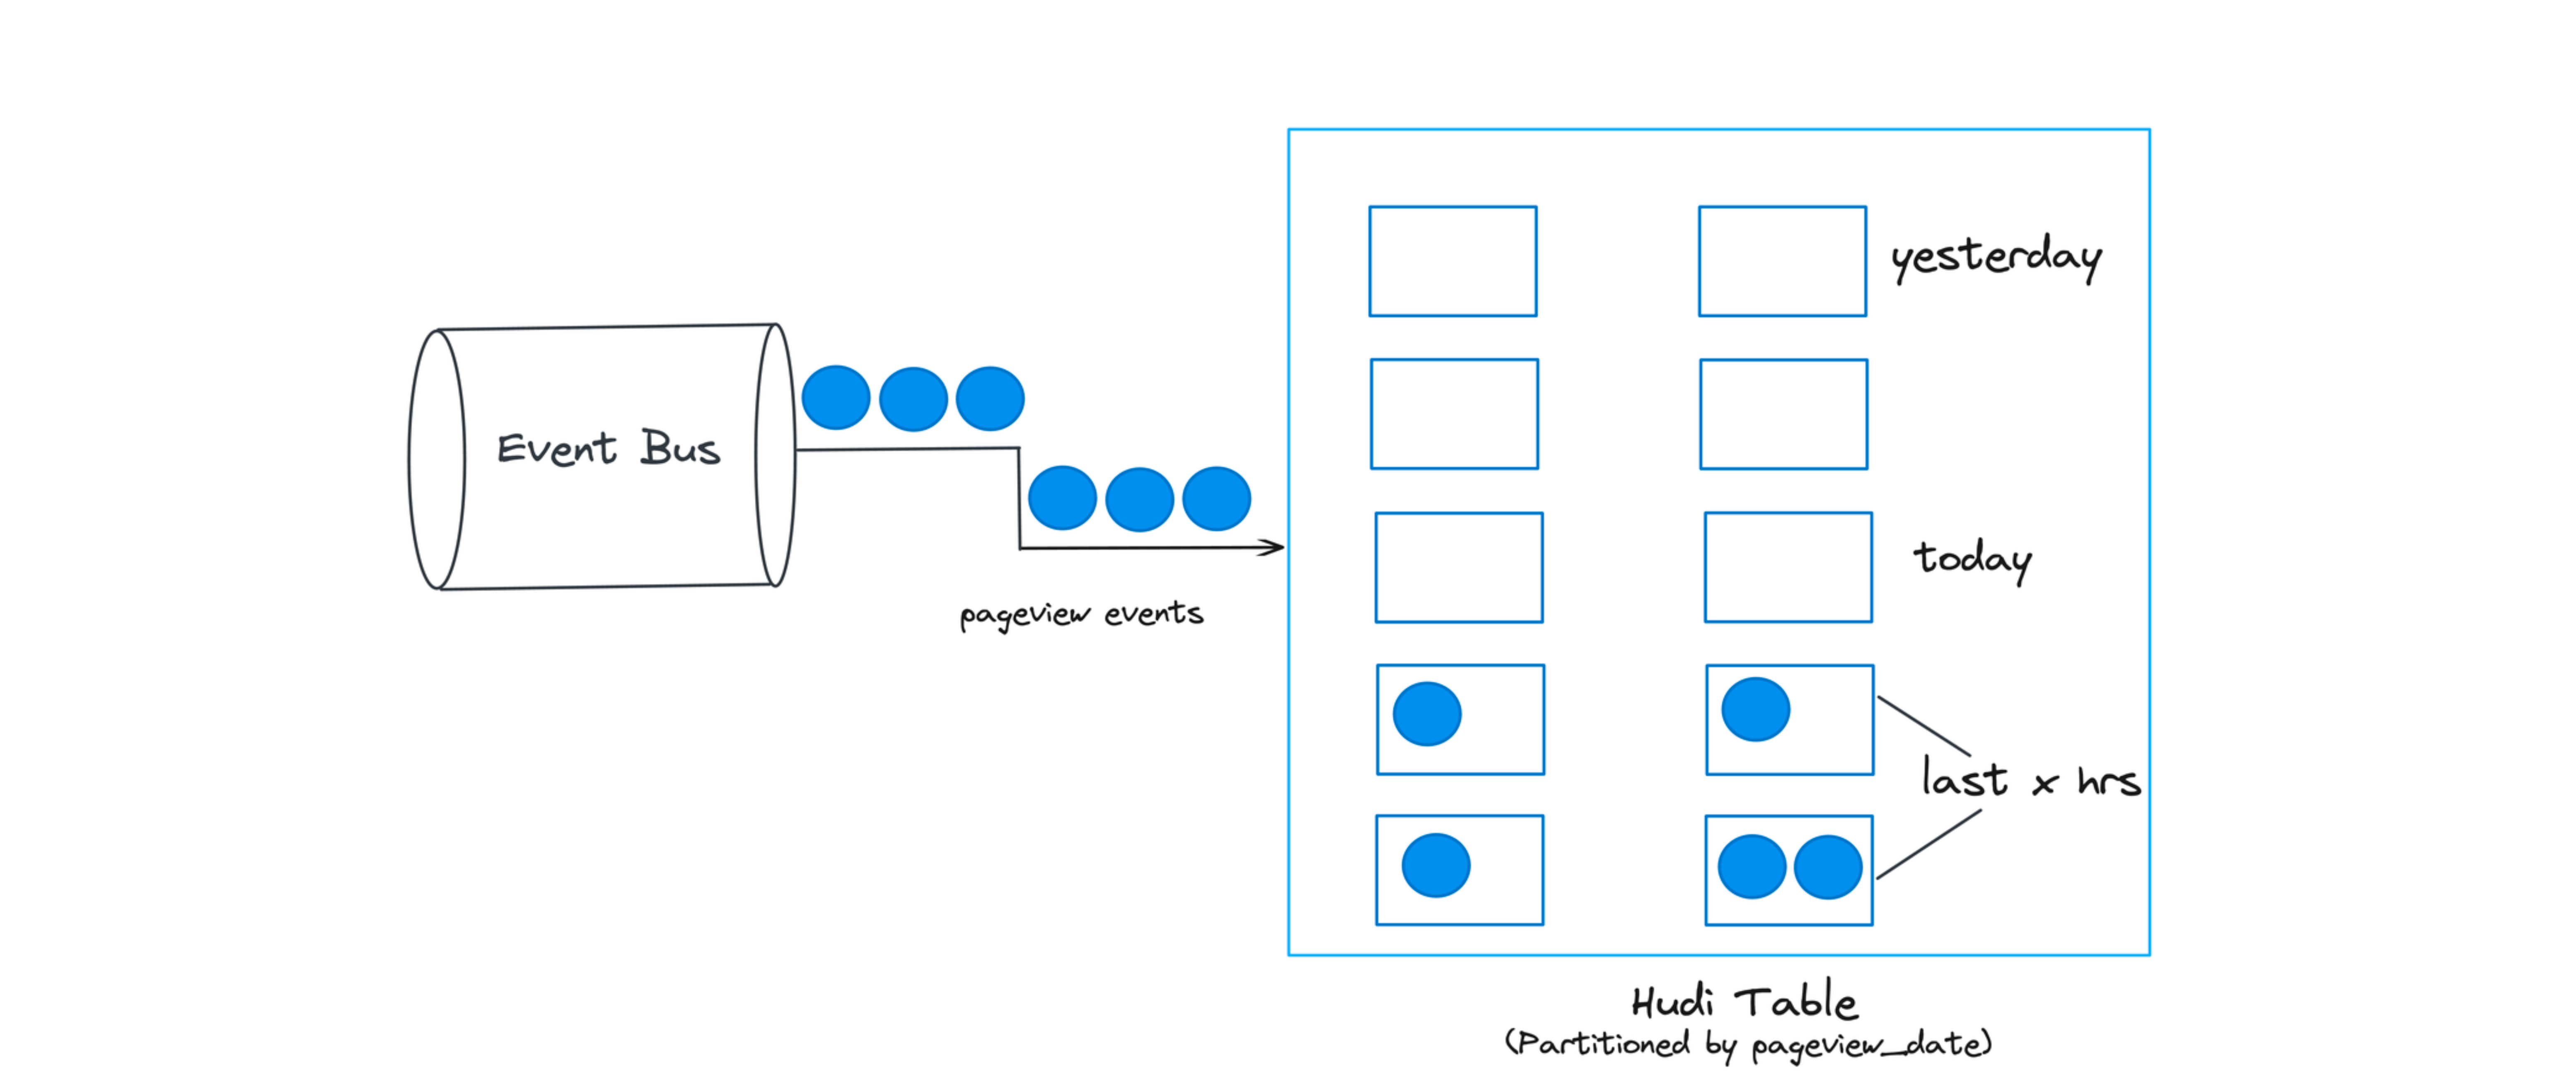
展示事件表更新分布的示意图。
总体而言,以较低成本解决这一问题非常具有挑战性。虽然我们甚至可以借助键值存储配合 HBASE 索引来完成去重,但索引存储成本会随事件数量线性增长,因而可能代价高昂。事实上,配合范围裁剪的 BLOOM 索引才是此处的最优方案。可以利用时间往往作为一等公民这一特点,构造诸如 event_ts + event_id 这样的键,使插入记录的键单调递增。这样即使在最新的表分区中也能裁剪掉大量文件,从而获得显著收益。
工作负载 3:维度表的随机更新/删除
这类表通常包含高维数据,保存参考数据,例如用户画像、商家信息。这些是高保真表,更新通常量不大,但分散在大量分区和数据文件中,覆盖从旧到新的整个数据集。这类表往往也是未分区的,因为也没有好的分区方式。
展示维度表更新分布的示意图。
如前所述,如果无法通过比较范围/过滤器裁剪掉足够多的文件,BLOOM 索引可能不会带来收益。在这种随机写入的工作负载中,更新最终会触及表内的大多数文件,因此布隆过滤器通常会针对某个传入更新对所有文件都返回真阳性。结果就是,我们最终仍然要比较范围/过滤器,只不过最后还是要拿传入更新与所有文件进行核对。SIMPLE 索引会更适合,因为它不做任何前置裁剪,而是直接与每个数据文件中的目标字段进行关联。如果运维开销可以接受,也可以采用 HBASE 索引,它能为这些表提供快得多的查找速度。
使用全局索引时,用户还应考虑设置 hoodie.bloom.index.update.partition.path=true 或 hoodie.simple.index.update.partition.path=true,以处理分区路径值因更新而发生变化的情况。例如:以居住城市为分区的用户表,当用户搬迁到另一个城市时就会出现这种情况。这类表也是 Merge-On-Read 表类型的绝佳选择。
博客
视频
评论
登录后参与评论