 KnowForge
表元数据
 师成· 更新于 2026-09-29· 阅读 17 分钟· 0 次阅读
Hudi 跟踪表的元数据,以消除影响读写性能的瓶颈,尤其是在云存储上。
- 避免为获取表中的文件集合而执行列表操作:任何想要读写 Hudi 表的引擎都需要知道构成该表的所有文件/对象,这通过列出表的分区/文件夹来实现。与许多分布式文件系统不同,这种操作在云存储上的扩展性较差,在大表上可能需要几秒甚至几分钟。当表很大且分区层级很深时,这个问题尤为突出。Hudi 会跟踪文件列表信息,使其对读写器直接可用,无需再去列出包含数据文件的文件夹。
- 暴露列统计信息以实现更好的查询规划和更快的查询:查询引擎依赖分区、数据跳过等技术,以减少查询规划和执行过程中需要扫描的无关数据量。在查询规划阶段,会从所有数据文件中读取文件页脚统计信息(如列值范围、空值计数),以确定是否需要读取某个特定文件来满足查询需求。这种方式开销较大,因为从所有文件读取页脚会增加云存储的 API 调用成本,对于较大的表还可能面临限流问题。Hudi 支持在列统计信息上高效地评估相关查询谓词,从而避免这些开销。
元数据表
Hudi 在每张表内部采用一种特殊的 元数据表 来提供这些能力。元数据表实现为一张内部的 Hudi Merge-On-Read 表,在不同的分区中承载不同类型的表元数据。这与数据库中使用内部表跟踪元数据的常见做法类似。这种方式具有以下优势。
- 可扩展(Scalable):表元数据同样需要能够扩展到很大的规模(参见 Google 的 Big Metadata 论文)。不同类型的索引应当能够轻松集成,以支持各种用例,并对元数据进行统一管理。通过使用与数据相同的存储格式和引擎来实现元数据,Hudi 能够借助内置的表服务来管理元数据,即使元数据规模达到 TB 级也能从容扩展。
- 灵活(Flexible):多模态索引的基础框架支持按需启用或禁用新索引。异步索引协议允许在常规写入方旁边并行构建索引,而不影响写入延迟。
- 事务性更新(Transactional updates):在写入发生或执行表服务时,表的数据、元数据和索引必须保持最新且彼此一致;表元数据必须始终是最新的,并与数据表保持同步。数据表与元数据表的时间线之间存在父子关系,以确保两者始终彼此同步。此外,MoR 表存储有助于吸收来自流式写入的元数据快速变化,而无需在每次写入时重写全部表元数据。
- 快速查找(Fast lookups):通过在元数据表中采用类似 SSTable 的基础文件格式(HFile),查询引擎能够高效地仅扫描所需的特定元数据部分。例如,某查询只访问表 100 个列中的 10 个列,那么在下推规划阶段,它只需读取其关心的这 10 个列的统计信息,从而降低规划时间和开销。此外,这些元数据还可以通过集中式/嵌入式的时间线服务器提供服务,该服务器会缓存元数据,进一步降低执行器端的查找延迟。
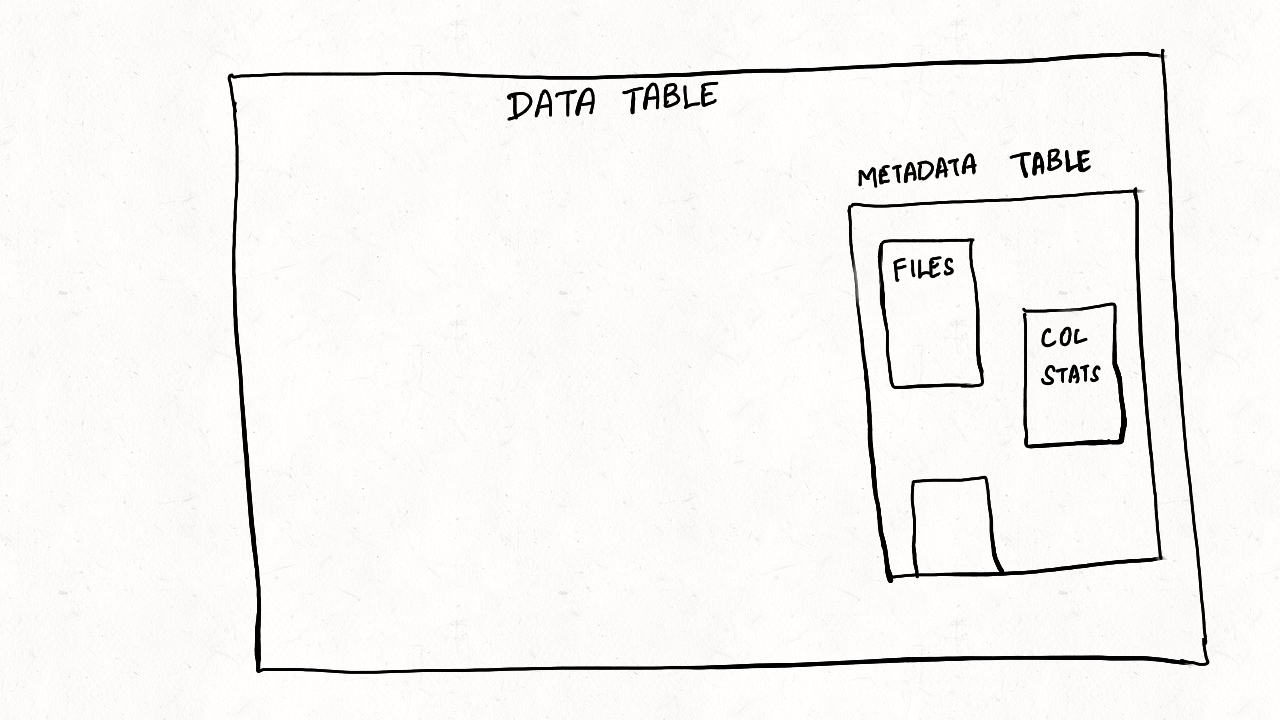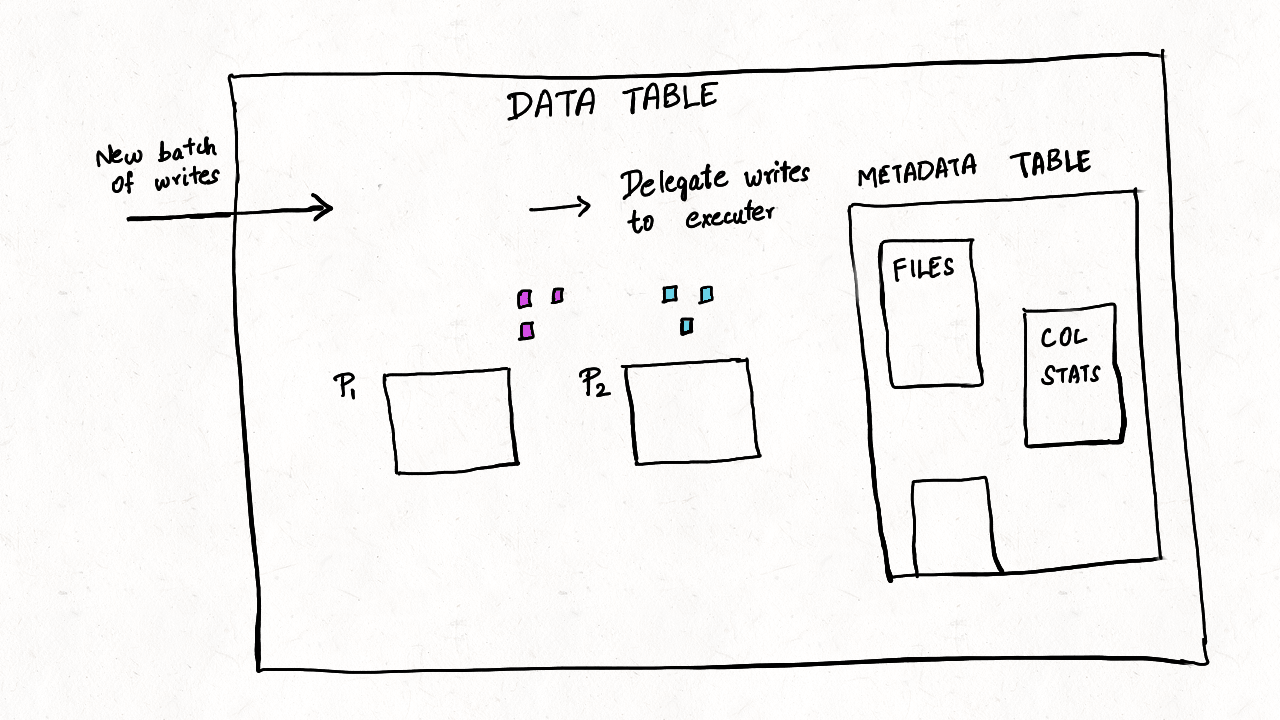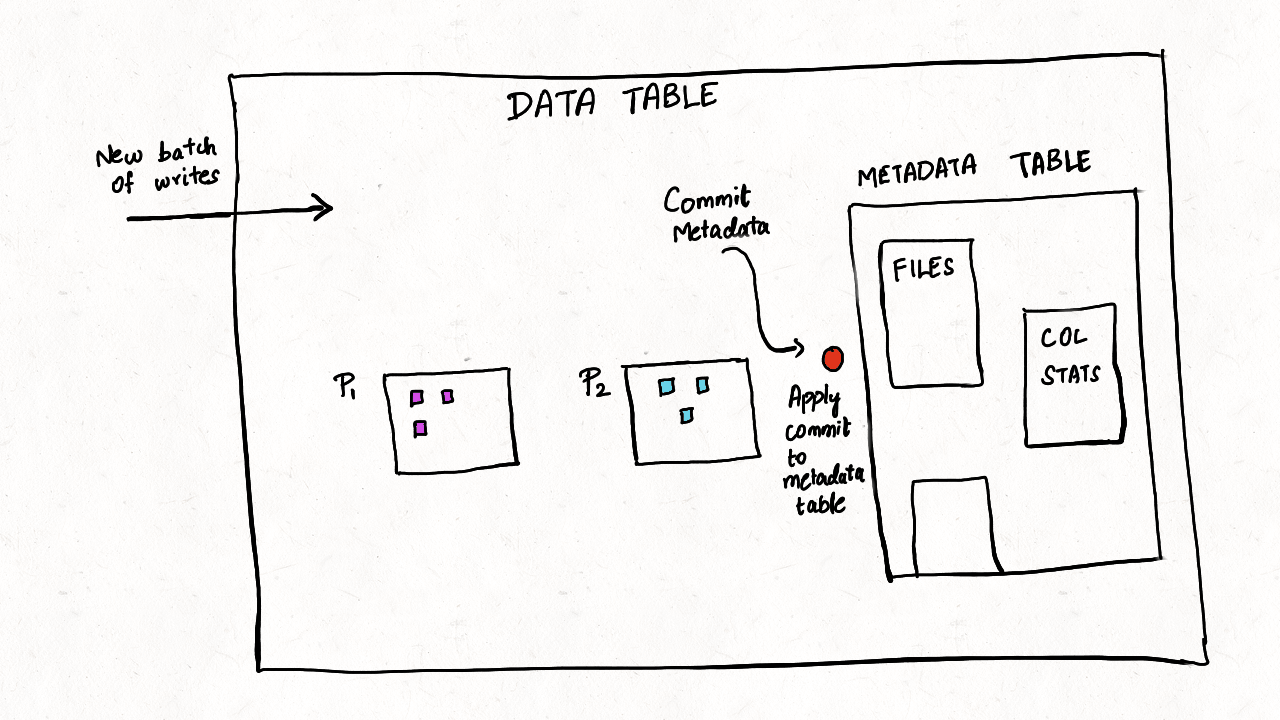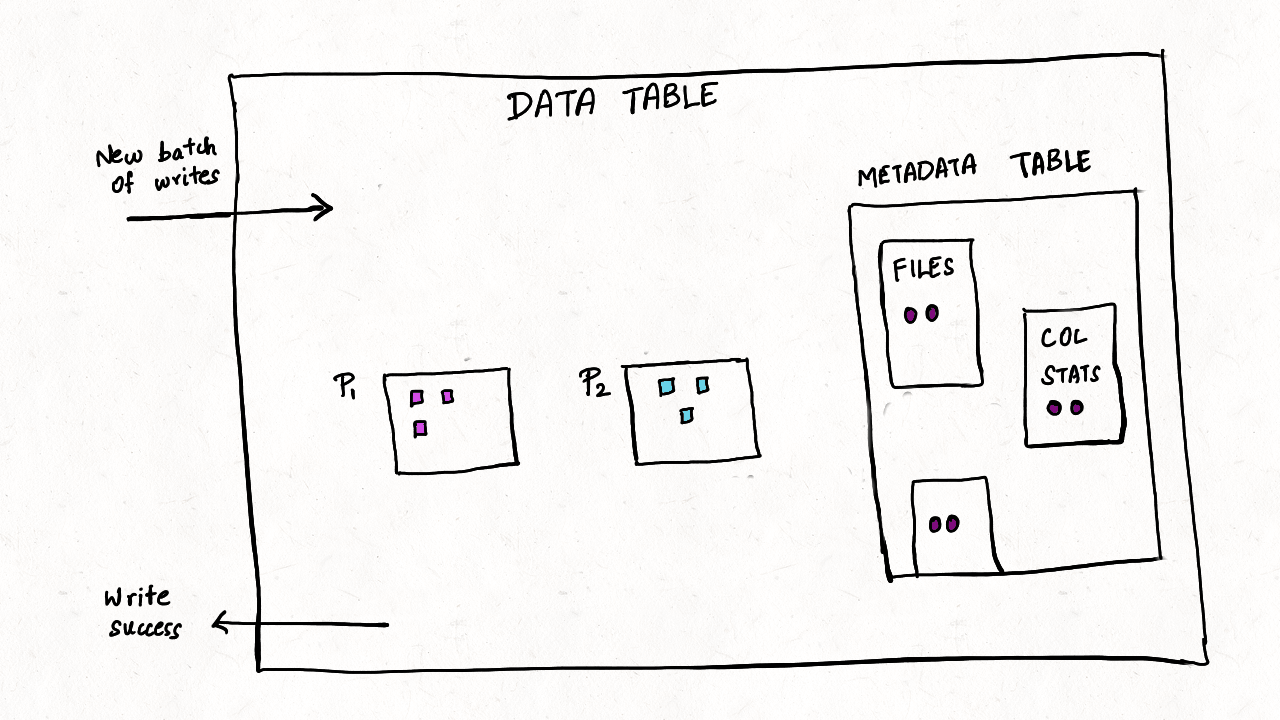
图:Hudi 中元数据表的机制
表元数据的类型
以下是当前支持的不同类型元数据。
- 文件列表:存储在元数据表的 files 分区中。包含数据表中每个分区的文件信息,如文件名、大小和活动状态,以及表中所有分区的列表。通过避免对数据表执行 exists、listStatus 和 listFiles 等直接存储调用,提升了文件列表的查询性能。
- 列统计信息:存储在元数据表的 column_stats 分区中。包含一组受跟踪列的统计信息(例如最小值、最大值、总值数量、空值计数、大小等),涵盖所有数据文件,并在处理谓词涉及这些列的查询时使用。该功能被数据跳过等技术大量使用,通过跳过不相关的文件,将查询速度提升若干个数量级。
- 分区统计信息:分区统计索引会针对启用了列统计信息的受跟踪列,在分区级别聚合统计信息。即使不检查文件级别的列统计信息,也能通过快速跳过整个文件夹来实现高效的分区裁剪。分区统计索引存储在元数据表的 partition_stats 分区中。可以使用以下配置启用分区统计索引(注意需要指定要聚合统计信息的列)。
如需试用这些功能,请参阅 SQL 指南。
写入端的元数据跟踪
以下是启用元数据跟踪所需的基础配置。高级配置请参阅此处。
| 配置名称 | 默认值 | 说明 |
|---|---|---|
| hoodie.metadata.enable | true(可选)在写入端启用 | 启用提供文件列表服务的内部元数据表。对于 0.10.1 及更早版本,元数据表默认禁用,需要显式启用。 |
Config Param: ENABLESince Version: 0.7.0
hoodie.metadata.index.column.stats.enable false(可选)启用元数据表下文件的列统计信息跟踪。启用后,元数据表会包含一个用于存储列值范围的分区,并在数据跳过时用于裁剪文件。
Config Param: ENABLE_METADATA_INDEX_COLUMN_STATSSince Version: 0.11.0
hoodie.metadata.index.column.stats.columns 表中的所有列 以逗号分隔的、需要跟踪列统计信息的列列表。
hoodie.metadata.index.partition.stats.enable false(可选)启用分区统计信息跟踪,所跟踪的列与列统计信息元数据跟踪的列相同。
对于 Flink,以下是启用元数据跟踪的基本配置。高级配置请参阅此处
| 配置名称 | 默认值 | 描述 |
|---|---|---|
metadata.enabled | true(可选) | 启用内部元数据表,该表用于提供层级文件列表等表元数据,默认启用 |
配置参数:METADATA_ENABLED
:::note 注意
如果你在启用后关闭了元数据表,请务必等待若干次提交,以确保元数据表被完全清理,然后再重新启用元数据表。
:::
已禁用 MDT 分区的自动删除
当写入配置中禁用某个索引时,Hudi 会自动删除对应的元数据表分区。该行为自 Hudi 1.2.0 起可用,并且可以进行配置。
| 配置名称 | 默认值 | 描述 |
|---|---|---|
hoodie.metadata.auto.delete.partitions | true | 启用后(默认),写入配置中已禁用的元数据表分区(索引)会被自动删除。设置为 false 可防止在多写入器环境中发生误删除——因为并非所有写入器的配置都相同,此时用户必须通过 Hudi CLI 或 DROP INDEX 显式删除索引。 |
在查询中利用元数据
files index
通过在不同引擎中设置相应的配置/会话属性,可以在读取端利用基于 files_index 的元数据列表,示例如下:
| 读取器 | 配置项 | 说明 |
|---|---|---|
| Spark DataSource、Spark SQL、Structured Streaming | hoodie.metadata.enable | 设置为 true 时启用 Hudi 的 Spark 文件索引实现,从而加快大表的文件列举速度。 |
| Flink DataStream、Flink SQL | metadata.enabled | 在 DDL 中设置为 true 时,使用内部元数据表来提供表元数据,例如 level 文件列举 |
| Presto | hudi.metadata-table-enabled | 设置为 true 时,从 Hudi 的元数据表而非存储中获取文件名和文件大小列表。 |
| Trino | N/A | 从元数据表读取的支持 已在 Trino 419 中移除。 |
| Athena | hudi.metadata-listing-enabled | 将该表属性设置为 TRUE 时,启用 Hudi 元数据表及相关文件列举功能 |
column_stats 索引与数据跳过
启用元数据表和列统计(column stats)索引是开启数据跳过能力的前提条件。以下是 Spark 和 Flink 读取器对应的相关配置。
| 读取器 | 配置项 | 说明 |
|---|---|---|
| Spark DataSource、Spark SQL、Structured Streaming | hoodie.metadata.enable、hoodie.enable.data.skipping | 设置为 true 时,启用 Hudi 的 Spark 文件索引实现,从而加快大表的文件列举速度;设置为 true 时启用数据跳过,允许查询利用索引跳过文件以缩小搜索空间。配置参数:ENABLE_DATA_SKIPPING起始版本:0.10.0 |
| Flink DataStream、Flink SQL | metadata.enabled、read.data.skipping.enabled | 在 DDL 中设置为 true 时,使用内部元数据表来提供表元数据,例如 level 文件列举;设置为 true 时启用数据跳过,允许查询利用索引跳过文件以缩小搜索空间。 |
元数据表的并发控制
为确保元数据表保持最新,并在并发写入与表操作之间安全地追踪表元数据,还需要考虑一些额外因素。如果该表启用了异步表服务(即运行独立的压缩(HoodieCompactor)或聚类(HoodieClusteringJob)作业),即便只有单个写入方,也必须配置锁提供者。详情请参阅并发控制。
首次启用元数据表之前,必须停止同一张表上的所有写入方和表服务。如果你当前的部署模式是多写入方,并且已为每个写入方按如下方式配置了锁提供者及其他必需配置,则无需额外配置。停掉写入方以启用元数据表后,可以依次启动这些写入方。仅对部分写入方或表服务应用这些配置是不安全的,可能导致数据丢失。因此,请确保在所有写入方上都启用元数据表。
元数据表清理器与压缩
Hudi 1.2.0 引入了一项配置,使元数据表的清理器可以直接从数据表派生其保留策略,而无需单独配置。
| 配置名称 | 默认值 | 说明 |
|---|---|---|
hoodie.metadata.derive.from.datatable.clean.policy | true | 启用后,元数据表的清理器将使用与数据表相同的清理策略(保留数量、保留小时数等)。另请参阅清理。 |
元数据表的压缩与日志压缩也可以委托给外部表服务平台执行。完整的配置参考请参阅压缩。
时间线归档控制
Hudi 1.2.0 在 HoodieArchivalConfig 中新增了两个配置项,用于精细调节时间线清单与归档在最近一次清理时的交互行为。
| 配置名称 | 默认值 | 说明 |
|---|---|---|
hoodie.timeline.manifest.retained.versions | 3 | 要保留的时间线清单(timeline manifest)文件版本数。较旧的清单版本会在归档过程中被清理。 |
hoodie.archive.block.on.latest.clean.ectr | false | 启用后,归档将停止在最近一次已完成清理的最早需保留提交(ECTR,Earliest Commit To Retain)处。这可以防止归档那些数据文件仍然存在于存储中的提交,从而避免时间线与实际数据之间的不一致。 |
博客
评论
登录后参与评论