 KnowForge
部署
 师成· 更新于 2026-09-29· 阅读 30 分钟· 0 次阅读
本节提供大规模部署和运维 Hudi 表所需的全部帮助。具体而言,我们将涵盖以下方面。
- 部署模型 :Hudi 各组件的部署与管理方式。
- 版本升级 :采用 Hudi 新版本的指南与通用最佳实践。
- 版本降级 :回退到较旧的 Hudi 版本。
- 迁移到 Hudi :如何将现有表迁移到 Apache Hudi。
部署
总而言之,Hudi 的部署不需要常驻服务器,也不会为你的数据湖带来额外的基础设施成本。事实上,Hudi 开创了利用现有基础设施构建事务性分布式存储层的模式,令人欣慰的是其他系统也在采用类似的方法。Hudi 的写入通过 Spark 作业(Hudi Streamer 或自定义 Spark 数据源作业)完成,按照 Apache Spark 的标准建议进行部署。对 Hudi 表的查询通过安装到 Apache Hive、Apache Spark 或 PrestoDB 中的库实现,因此无需额外的基础设施。
典型的 Hudi 数据摄取可以在两种模式下完成。在单次运行模式下,Hudi 摄取会读取下一批数据,将其写入 Hudi 表后退出。在持续模式下,Hudi 摄取作为长期运行的服务运行,循环执行摄取作业。
对于 Merge_On_Read 表,Hudi 摄取还需要负责合并(compact)增量文件。同样,压缩可以以异步模式执行,即让压缩与摄取并发运行,也可以以串行方式依次执行。
Hudi Streamer
Hudi Streamer 是一个独立工具,用于从 DFS、Kafka 和数据库变更日志(Changelog)等不同来源增量拉取上游变更,并将其摄取到 Hudi 表中。它以 Spark 应用的形式在两种模式下运行。
要在 Spark 中使用 Hudi Streamer,需要 hudi-utilities-slim-bundle 和 Hudi Spark bundle,只需在 spark-submit 命令中添加 --packages org.apache.hudi:hudi-utilities-slim-bundle_2.12:1.2.1,org.apache.hudi:hudi-spark3.5-bundle_2.12:1.2.1 即可。
请选择与你的 Spark 运行时相匹配的 Spark bundle —— 例如 hudi-spark3.3-bundle_2.12、hudi-spark3.4-bundle_2.12、hudi-spark3.5-bundle_2.12(Scala 2.12 或 2.13)、hudi-spark3.5-bundle_2.13、hudi-spark4.0-bundle_2.13 或 hudi-spark4.1-bundle_2.13。Spark 4.0 和 4.1 在运行时需要 Java 17 或更高版本;Spark 3.x 可运行在 Java 8 或更高版本上。
- 单次运行模式(Run Once Mode):在此模式下,Hudi Streamer 执行一轮摄取,包括从上游源增量拉取事件并将其摄取到 Hudi 表中。清理旧文件版本、归档 hoodie 时间线等后台操作会作为该次运行的一部分自动执行。对于 Merge-On-Read 表,Compaction(压缩)也会以内联方式作为摄取的一部分运行,除非通过传入标志
--disable-compaction来禁用。默认情况下,每次摄取运行都会内联执行 Compaction,可通过设置属性hoodie.compact.inline.max.delta.commits来更改该行为。你可以手动运行这个 Spark 应用,也可以使用任何 cron 定时任务或工作流编排工具(最常见的部署方式),例如 Apache Airflow 来启动该应用。有关运行该 Spark 应用的命令行选项,请参见此章节。
以下是一个示例调用,用于在单次运行模式下从 Kafka 主题读取数据,并在 YARN 集群上写入 Merge-On-Read 表类型:
spark-submit \
 --packages org.apache.hudi:hudi-utilities-slim-bundle_2.12:1.2.1,org.apache.hudi:hudi-spark3.5-bundle_2.12:1.2.1 \
 --master yarn \
 --deploy-mode cluster \
 --num-executors 10 \
 --executor-memory 3g \
 --driver-memory 6g \
 --conf spark.driver.extraJavaOptions="-XX:+PrintGCApplicationStoppedTime -XX:+PrintGCApplicationConcurrentTime -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/varadarb_ds_driver.hprof" \
 --conf spark.executor.extraJavaOptions="-XX:+PrintGCApplicationStoppedTime -XX:+PrintGCApplicationConcurrentTime -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/varadarb_ds_executor.hprof" \
 --queue hadoop-platform-queue \
 --conf spark.scheduler.mode=FAIR \
 --conf spark.yarn.executor.memoryOverhead=1072 \
 --conf spark.yarn.driver.memoryOverhead=2048 \
 --conf spark.task.cpus=1 \
 --conf spark.executor.cores=1 \
 --conf spark.task.maxFailures=10 \
 --conf spark.memory.fraction=0.4 \
 --conf spark.rdd.compress=true \
 --conf spark.kryoserializer.buffer.max=200m \
 --conf spark.serializer=org.apache.spark.serializer.KryoSerializer \
 --conf spark.memory.storageFraction=0.1 \
 --conf spark.shuffle.service.enabled=true \
 --conf spark.sql.hive.convertMetastoreParquet=false \
 --conf spark.ui.port=5555 \
 --conf spark.driver.maxResultSize=3g \
 --conf spark.executor.heartbeatInterval=120s \
 --conf spark.network.timeout=600s \
 --conf spark.eventLog.overwrite=true \
 --conf spark.eventLog.enabled=true \
 --conf spark.eventLog.dir=hdfs:///user/spark/applicationHistory \
 --conf spark.yarn.max.executor.failures=10 \
 --conf spark.sql.catalogImplementation=hive \
 --conf spark.sql.shuffle.partitions=100 \
 --driver-class-path $HADOOP_CONF_DIR \
 --class org.apache.hudi.utilities.streamer.HoodieStreamer \
 --table-type MERGE_ON_READ \
 --source-class org.apache.hudi.utilities.sources.JsonKafkaSource \
 --source-ordering-field ts  \
 --target-base-path /user/hive/warehouse/stock_ticks_mor \
 --target-table stock_ticks_mor \
 --props /var/demo/config/kafka-source.properties \
--schemaprovider-class org.apache.hudi.utilities.schema.FilebasedSchemaProvider- Continuous Mode:在此模式下,Hudi Streamer 会运行一个无限循环,每一轮都执行一次 Run Once Mode 中描述的摄取流程。数据摄取的频率可以通过配置项
--min-sync-interval-seconds来控制。对于 Merge-On-Read 表,除非通过传入--disable-compaction标志禁用,否则 Compaction 会以异步方式与摄取并发运行。每次摄取运行都会异步触发一次 compaction 请求,该频率可以通过设置属性hoodie.compact.inline.max.delta.commits来调整。由于摄取和 compaction 运行在同一个 Spark context 中,因此可以使用 Hudi Streamer CLI 中的资源分配配置,例如--delta-sync-scheduling-weight、--compact-scheduling-weight、--delta-sync-scheduling-minshare和--compact-scheduling-minshare,来控制执行器在摄取与 compaction 之间的分配。
以下是一个示例调用,用于以连续模式从 Kafka topic 读取数据,并写入 yarn 集群中的 Merge On Read 表类型:
spark-submit \
 --packages org.apache.hudi:hudi-utilities-slim-bundle_2.12:1.2.1,org.apache.hudi:hudi-spark3.5-bundle_2.12:1.2.1 \
 --master yarn \
 --deploy-mode cluster \
 --num-executors 10 \
 --executor-memory 3g \
 --driver-memory 6g \
 --conf spark.driver.extraJavaOptions="-XX:+PrintGCApplicationStoppedTime -XX:+PrintGCApplicationConcurrentTime -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/varadarb_ds_driver.hprof" \
 --conf spark.executor.extraJavaOptions="-XX:+PrintGCApplicationStoppedTime -XX:+PrintGCApplicationConcurrentTime -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/varadarb_ds_executor.hprof" \
 --queue hadoop-platform-queue \
 --conf spark.scheduler.mode=FAIR \
 --conf spark.yarn.executor.memoryOverhead=1072 \
 --conf spark.yarn.driver.memoryOverhead=2048 \
 --conf spark.task.cpus=1 \
 --conf spark.executor.cores=1 \
 --conf spark.task.maxFailures=10 \
 --conf spark.memory.fraction=0.4 \
 --conf spark.rdd.compress=true \
 --conf spark.kryoserializer.buffer.max=200m \
 --conf spark.serializer=org.apache.spark.serializer.KryoSerializer \
 --conf spark.memory.storageFraction=0.1 \
 --conf spark.shuffle.service.enabled=true \
 --conf spark.sql.hive.convertMetastoreParquet=false \
 --conf spark.ui.port=5555 \
 --conf spark.driver.maxResultSize=3g \
 --conf spark.executor.heartbeatInterval=120s \
 --conf spark.network.timeout=600s \
 --conf spark.eventLog.overwrite=true \
 --conf spark.eventLog.enabled=true \
 --conf spark.eventLog.dir=hdfs:///user/spark/applicationHistory \
 --conf spark.yarn.max.executor.failures=10 \
 --conf spark.sql.catalogImplementation=hive \
 --conf spark.sql.shuffle.partitions=100 \
 --driver-class-path $HADOOP_CONF_DIR \
 --class org.apache.hudi.utilities.streamer.HoodieStreamer \
 --table-type MERGE_ON_READ \
 --source-class org.apache.hudi.utilities.sources.JsonKafkaSource \
 --source-ordering-field ts  \
 --target-base-path /user/hive/warehouse/stock_ticks_mor \
 --target-table stock_ticks_mor \
 --props /var/demo/config/kafka-source.properties \
 --schemaprovider-class org.apache.hudi.utilities.schema.FilebasedSchemaProvider \
 --continuous
Spark 数据源写入作业
如批量写入中所述,你可以使用 Spark 数据源将数据写入 Hudi 表。该机制允许你以 Hudi 格式写入任意 Spark DataFrame。Hudi Spark 数据源还支持通过 Spark Streaming 将流式数据源写入 Hudi 表。对于 Merge On Read 表类型,默认启用内联压缩(inline compaction),该操作会在每次写入任务结束后执行。压缩频率可以通过设置属性 hoodie.compact.inline.max.delta.commits 来调整。
以下是使用 Spark 数据源的调用示例:
inputDF.write()
       .format("org.apache.hudi")
       .options(clientOpts) // any of the Hudi client opts can be passed in as well
       .option("hoodie.datasource.write.recordkey.field", "_row_key")
       .option("hoodie.datasource.write.partitionpath.field", "partition")
       .option("hoodie.table.ordering.fields", "timestamp")
       .option("hoodie.table.name", tableName)
       .mode(SaveMode.Append)
       .save(basePath);
升级
新的 Hudi 版本会在发布页面上列出,其中包含详细说明,列出所有变更以及每个版本的亮点。归根结底,Hudi 是一个存储系统,随之而来的是一系列责任,我们会认真对待。
一般准则:
- 我们力求保持所有变更向后兼容(即新代码可以读取旧的数据/时间线文件),当无法做到时,我们会通过 CLI 提供升级/降级工具。
- 我们无法始终保证向前兼容(即旧代码能够读取更高版本写入的数据/时间线文件)。这通常是常态,因为否则无法构建任何新功能。不过,此类重大变更默认会被关闭,以便顺利过渡到新版本。经过几个版本之后,一旦足够多的用户认为该功能在生产环境中稳定,我们会在后续版本中更改默认值。
- 始终先升级查询端的 bundle(mr-bundle、presto-bundle、spark-bundle),然后再升级写入端(Hudi Streamer、使用 datasource 的 Spark 作业)。这样通常能获得最佳体验,而且通过回滚或推进写入端代码来修复问题也很简单(通常你对写入端拥有更多控制权)。
- 对于体量大、功能丰富的版本,我们建议逐步迁移,先在预发布环境中测试并运行你自己的测试。升级 Hudi 与升级任何数据库系统并无二致。
请注意,发布说明可能会针对具体情况覆盖此信息并给出特定指引。
升级到 1.0.0
1.0.0 是一个包含重大格式变更的主要版本。为确保迁移过程顺利,建议按照以下步骤操作:
- 完全停止 0.x 中的所有异步表服务。
- 将写入端升级到 1.x,使用表版本(tv)6,禁用
autoUpgrade和元数据(这不会自动升级任何内容);0.x 的读取端将继续正常工作;写入端同时也可以作为读取端,并将继续读取 tv=6。
a. 将hoodie.write.auto.upgrade设置为 false。
b. 将hoodie.metadata.enable设置为 false。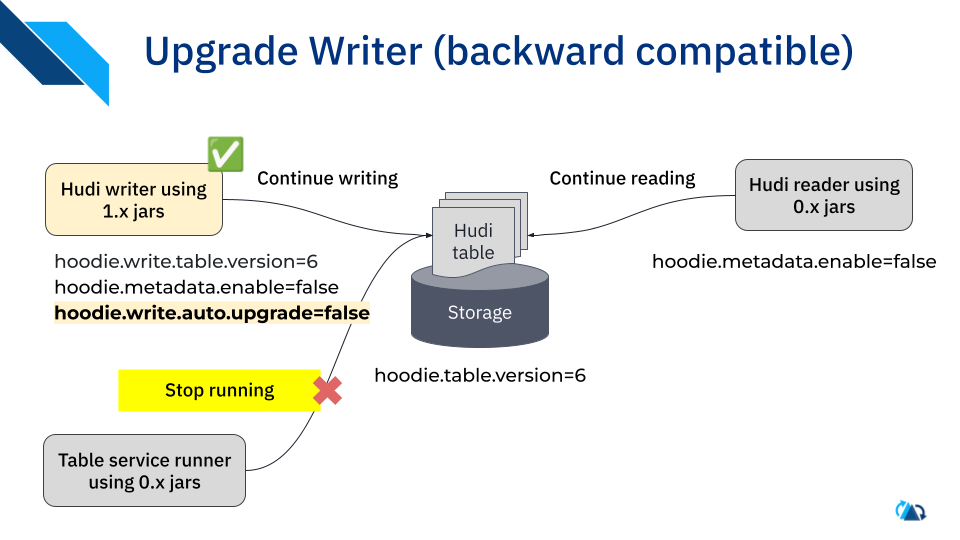
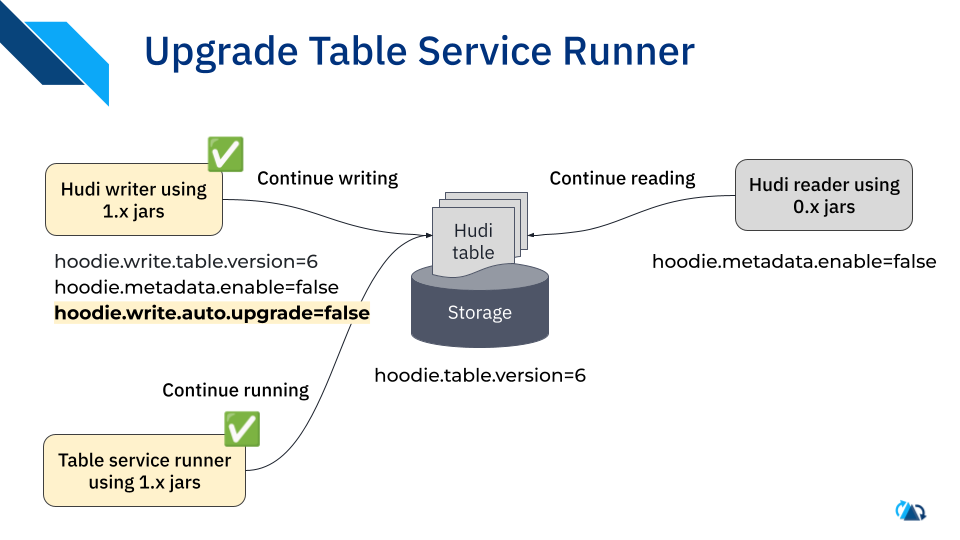
- 将表服务升级到 1.x,使用 tv=6,并恢复其运行。
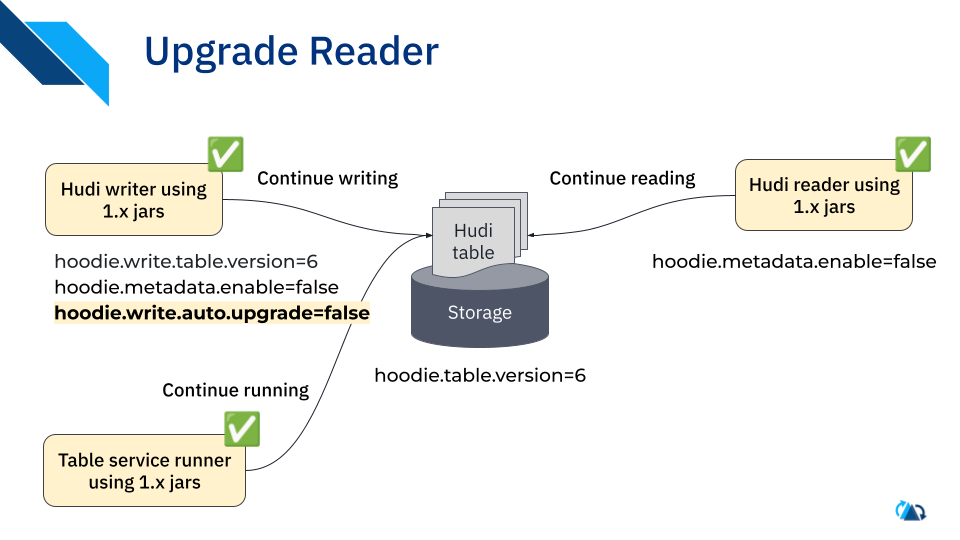
- 将所有剩余的读取端升级到 1.x,使用 tv=6。
- 使用 tv=8 重新部署写入端;表服务和读取端会自适应并动态获取 tv=8。
- 当所有读取端和写入端都升级到 1.x 后,我们就可以在 1.x 表上启用任何新功能了,包括元数据。
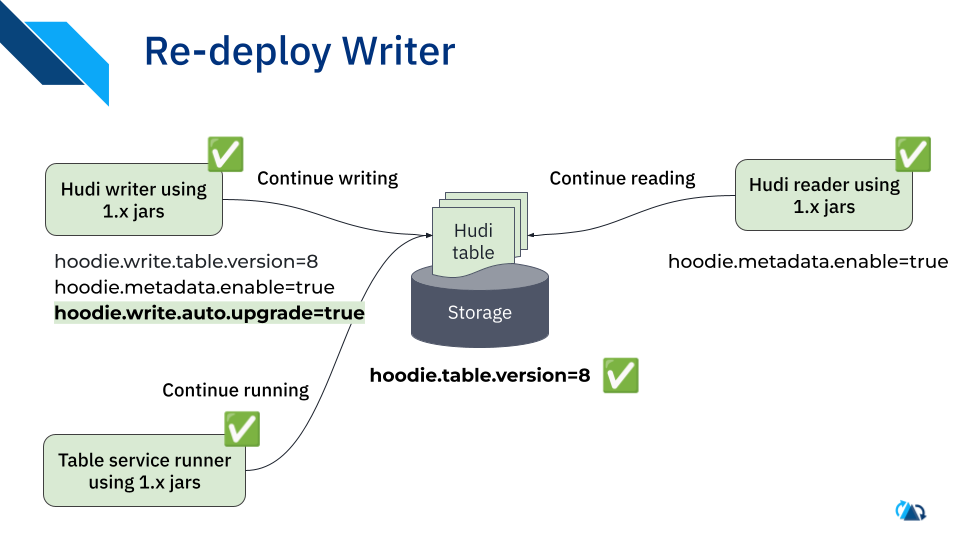
在升级过程中,元数据表不会被更新,因此会落后于数据表。需要注意的是,只有当写入者升级到 tv=8 时,元数据表才会被更新。因此,在滚动升级期间,即使读取者也应保持元数据表功能处于禁用状态,直到所有写入者都升级到 tv=8 为止。
:::caution
大多数情况都会由自动升级过程无缝处理,但仍然存在一些限制。在继续进行迁移之前,请先通读升级与降级过程的限制说明。详情请参阅 RFC-78。
:::
降级
使用新版本 Hudi 时,升级是自动完成的,而降级则是一个手动步骤。我们需要使用 Hudi CLI 将表从较高版本降级到较低版本。下面以一个示例说明:我们先使用 0.12.0 创建一个表,将其升级到 0.13.0,然后通过 Hudi CLI 对其进行降级。
以 Hudi 0.11.0 版本启动 spark shell。
spark-shell \
  --packages org.apache.hudi:hudi-spark3.2-bundle_2.12:0.11.0 \
  --conf 'spark.serializer=org.apache.spark.serializer.KryoSerializer' \
  --conf 'spark.sql.catalog.spark_catalog=org.apache.spark.sql.hudi.catalog.HoodieCatalog' \
  --conf 'spark.sql.extensions=org.apache.spark.sql.hudi.HoodieSparkSessionExtension'
使用下面的 Scala 脚本创建一个 Hudi 表。
import org.apache.hudi.QuickstartUtils._
import scala.collection.JavaConversions._
import org.apache.spark.sql.SaveMode._
import org.apache.hudi.DataSourceReadOptions._
import org.apache.hudi.DataSourceWriteOptions._
import org.apache.hudi.config.HoodieWriteConfig._
import org.apache.hudi.common.model.HoodieRecord
import org.apache.hudi.common.table.timeline.HoodieTimeline
import org.apache.hudi.common.fs.FSUtils
import org.apache.hudi.HoodieDataSourceHelpers

val dataGen = new DataGenerator
val tableType = MOR_TABLE_TYPE_OPT_VAL
val basePath = "file:///tmp/hudi_table"
val tableName = "hudi_table"

val inserts = convertToStringList(dataGen.generateInserts(100)).toList
val insertDf = spark.read.json(spark.sparkContext.parallelize(inserts, 2))
insertDf.write.format("hudi").
        options(getQuickstartWriteConfigs).
        option("hoodie.table.ordering.fields", "ts").
        option("hoodie.datasource.write.recordkey.field", "uuid").
        option("hoodie.datasource.write.partitionpath.field", "partitionpath").
        option("hoodie.table.name", tableName).
        option("hoodie.datasource.write.operation", "insert").
        mode(Append).
        save(basePath)
你将在 hoodie.properties 中看到一个 table version 条目,其中说明表版本为 4。
bash$ cat /tmp/hudi_table/.hoodie/hoodie.properties | grep hoodie.table.version
hoodie.table.version=4
使用 0.13.0 版本启动新的 Spark shell,并使用上面的脚本向同一张表追加数据。请注意,升级会随新版本自动完成。
spark-shell \
  --packages org.apache.hudi:hudi-spark3.2-bundle_2.12:0.13.1 \
  --conf 'spark.serializer=org.apache.spark.serializer.KryoSerializer' \
  --conf 'spark.sql.catalog.spark_catalog=org.apache.spark.sql.hudi.catalog.HoodieCatalog' \
  --conf 'spark.sql.extensions=org.apache.spark.sql.hudi.HoodieSparkSessionExtension'
升级后,表版本会更新为 5。
bash$ cat /tmp/hudi_table/.hoodie/hoodie.properties | grep hoodie.table.version
hoodie.table.version=5
让我们尝试将表降级回版本 4。降级时我们需要使用 Hudi CLI 并执行 downgrade 命令。有关降级的更多详细信息,请参阅此处的文档。
connect --path /tmp/hudi_table
downgrade table --toVersion 4
降级后,表版本将更新为 4。
bash$ cat /tmp/hudi_table/.hoodie/hoodie.properties | grep hoodie.table.version
hoodie.table.version=4
迁移
目前,迁移到 Hudi 有两种方式:
- 将较新的分区转换为 Hudi:该模式适用于大型事件表(例如:点击流、广告曝光),这类表通常也只接收最近几天的写入。你可以将最近 N 个分区转换为 Hudi,然后像操作 Hudi 表一样继续进行写入。Hudi 查询侧的代码能够正确处理 Hudi 与非 Hudi 的数据分区。
- 完全转换为 Hudi:如果你当前每天会对表进行几次批量/全量加载(例如数据库数据摄入),则适合采用该模式。完全转换为 Hudi 只需一次性操作(类似于运行一次现有的作业),即可将所有数据迁移到 Hudi 格式,并为后续写入提供增量更新的能力。
更多详情请参阅详细的迁移指南。未来,我们将支持对现有表进行无缝的零拷贝引导(bootstrap),并完整支持所有更新(upsert)与增量查询能力。
评论
登录后参与评论