 KnowForge
性能
 师成· 更新于 2026-09-29· 阅读 16 分钟· 0 次阅读
优化的 DFS 访问
Hudi 还会对存储在 Hudi 表中的数据执行若干关键的存储管理功能。在 DFS 上存储数据的一个关键方面是管理文件的大小和数量,以及回收存储空间。例如,HDFS 因其对小文件的处理方式而臭名昭著,这会给 NameNode 带来内存/RPC 压力,并可能破坏整个集群的稳定性。一般来说,查询引擎在大小适中的列式文件上能提供好得多的性能,因为它们可以有效地摊销获取列统计信息等操作的成本。即便在某些云数据存储上,列出包含大量小文件的目录通常也需要付出成本。
以下是一些高效管理 Hudi 表存储的方法:
- Hudi 中的小文件处理功能会分析传入的工作负载,并将插入操作分布到现有的文件组中,而不是创建新的文件组,从而避免产生小文件。
- 清理器可以配置为清理较旧的文件切片,其激进程度可根据查询允许运行的最长时间以及增量拉取所需的回溯范围来调整。
- 用户还可以调整基础/Parquet 文件、日志文件的大小以及预期的压缩比,使足够数量的插入被分组到同一个文件组中,最终生成大小合适的基础文件。
- 智能地调整批量插入并行度,同样可以得到大小合适的初始文件组。事实上,正确设置这一参数至关重要,因为文件组一旦创建,除非对表进行重新聚类,否则无法更改。如前所述,写入操作只会通过新的更新/插入来扩展给定的文件组。
- 对于更新密集型的工作负载,MERGE_ON_READ 表提供了一种很好的机制,可以先快速将数据摄取到较小的文件中,随后再通过 compaction 将其合并为更大的基础文件。
性能优化
在本节中,我们将介绍 Hudi 在 upsert 和增量拉取方面的一些真实性能数据,并将它们与实现这些任务的传统替代方案进行对比。
写入路径
批量插入
Hudi 中的写入配置默认是针对增量 upsert 进行优化的。事实上,默认的写操作类型也是 UPSERT。对于需要批量加载数据的简单仅追加(append-only)用例,建议采用以下配置以获得最佳写入性能:
-- Use “bulk-insert” write-operation instead of default “upsert”
hoodie.datasource.write.operation = BULK_INSERT
-- Disable populating meta columns and metadata, and enable virtual keys
hoodie.populate.meta.fields = false
hoodie.metadata.enable = false
-- Enable snappy compression codec for lesser CPU cycles (but more storage overhead)
hoodie.parquet.compression.codec = snappy
通过 spark-sql 进行摄取时
-- Use “bulk-insert” write-operation instead of default “upsert”
hoodie.sql.insert.mode = non-strict,
hoodie.sql.bulk.insert.enable = true,
-- Disable populating meta columns and metadata, and enable virtual keys
hoodie.populate.meta.fields = false
hoodie.metadata.enable = false
-- Enable snappy compression codec for lesser CPU cycles (but more storage overhead)
hoodie.parquet.compression.codec = snappy
我们最近使用 TPC-DS 工作负载对 Hudi 进行了基准测试。详情请参阅我们的博客。
Upsert(更新插入)
下图展示了 NoSQL 数据库摄取的加速效果,即在 copy-on-write 存储上的 Hudi 表中进行增量 upsert(与批量加载表相比),涵盖从小到超大共 5 张表。
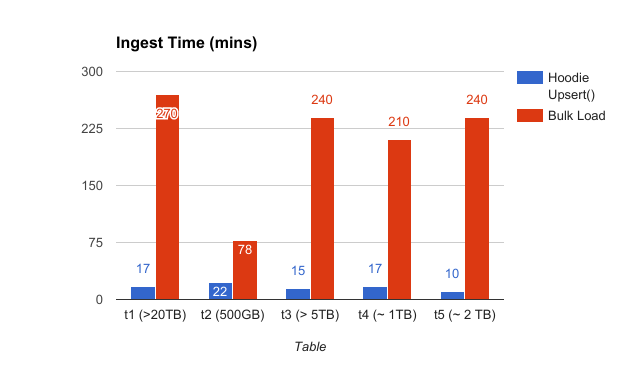
由于 Hudi 可以增量构建表,这就为更频繁地调度数据摄取创造了条件,从而降低延迟,并显著节省整体计算成本。
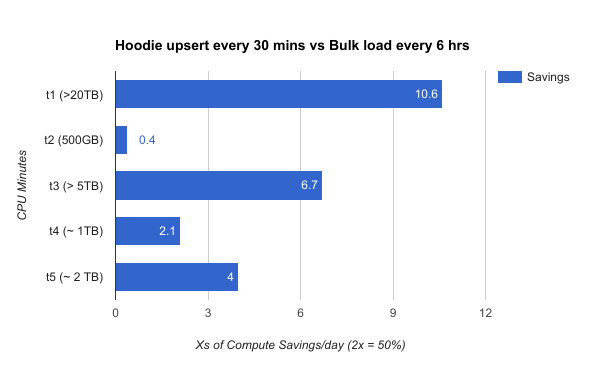
Hudi 的 upsert 已在 t1 表上经过压力测试,单次提交最高可达 4TB。一些调优建议请参见此处。
索引(Indexing)
为了高效地执行 upsert,Hudi 需要将写入批次中的记录分类为插入(insert)和更新(update),并标记更新记录所属的文件组。为了加速这一操作,Hudi 采用可插拔的索引机制,存储 recordKey 与其所属文件组 ID 之间的映射关系。默认情况下,Hudi 使用内置索引,通过文件范围(file range)和布隆过滤器(bloom filter)来完成此工作,其速度比使用 Spark join 实现同样功能快至 10 倍。
当你的 recordKey 建模为单调递增(例如时间戳前缀)时,Hudi 能提供最佳的索引性能,因为范围裁剪可以过滤掉大量需要比较的文件。即使是基于 UUID 的键,也有已知的技术可以实现这一点。例如,在一张拥有 800 亿键/3 个分区/11416 个文件/10TB 数据的事件表上,使用 1 亿个带时间戳前缀的键(5% 更新、95% 插入),Hudi 索引相比原生 Spark join 实现了 约 7 倍的加速(2880 秒 vs 440 秒)。即使对于 "100% 更新" 这样具有挑战性的数据库摄取工作负载——涉及 32.5 亿个 UUID 键/30 个分区/6180 个文件,并使用 300 个核——Hudi 索引仍能提供 80-100% 的加速。
读取路径(Read Path)
数据跳过(Data Skipping)
数据跳过是一种技术(最初在 Hudi 0.10 中引入),它利用元数据非常有效地裁剪查询的搜索空间,排除那些不可能包含符合查询过滤条件数据的文件。Hudi 将这些元数据保存在内部的 Hudi 元数据表中,从而避免读取文件页脚来获取该信息,而对于涉及数万个文件的查询来说,读取页脚的开销可能很大。
数据跳过(Data Skipping)利用元数据表中 col_stats 分区所承载的列级统计信息(例如最小值、最大值、该列的空值数量等),这些信息覆盖 Hudi 表中的每一个文件。借助这些信息,Hudi 在处理每个传入的查询时,无需枚举表中的所有文件并读取各自对应的元数据(例如 Parquet footer)来分析其是否可能包含与查询过滤条件匹配的数据,而只需对元数据表中的列统计索引(Column Stats Index,其本身也是一张 Hudi 表)执行一次查询,即可在数秒内(即使对于 TB 级、拥有数万个文件的表)获得所有可能包含与查询过滤条件相匹配的数据的文件列表;其中关键的特性在于,基于列级统计信息可以排除那些确定不包含此类数据的文件。详细设计参见 RFC-27。
分区可以看作一种粗粒度的索引形式,而基于 col\_stats 分区实现的数据跳过则可视为一种范围索引——数据库正是利用范围索引来识别查询所关注的潜在数据块。与采用物理分区的表的分区裁剪不同(物理分区将数据集中的记录按照某一列的值组织到目录结构中),基于 col\_stats 的数据跳过提供的是逻辑/虚拟分区能力。
对于超大规模的表(1 TB 以上、数万个文件),数据跳过可以:
- 相比在同一数据集上未启用数据跳过时执行的相同查询,将查询运行时间大幅缩短至 10 倍。
- 帮助避免触发云存储的限流限制(例如,AWS 会根据对象前缀限制每秒可发出的请求数量,这对于分区表来说会使问题变得相当复杂)。
要充分发挥数据跳过的能力,你需要:
- 在写入路径上启用元数据表及列统计索引(参见元数据索引),通过设置
hoodie.metadata.enable=true(在写入路径上启用元数据表,默认已启用)。 - 在查询中启用于数据跳过,通过设置
hoodie.metadata.index.column.stats.enable=true(启用写入路径上列统计索引的填充,默认禁用)。
note
如果你计划为已存在的表启用列统计索引,请参阅元数据索引指南,了解如何为已有表构建元数据表索引(例如列统计索引)。
要在查询中启用数据跳过,请确保将以下属性设置为 true(在读取路径上):
hoodie.enable.data.skipping(用于控制数据跳过,默认启用)hoodie.metadata.enable(用于在读取路径上启用元数据表的使用,默认启用)hoodie.metadata.index.column.stats.enable(用于在读取路径上启用列统计索引的使用)
Parquet 布隆过滤器
列统计信息通过范围进行裁剪,因此在最需要它们的地方它们反而帮助最小:当高基数列上的等值谓词所覆盖的 min-max 范围几乎涵盖所有文件时便是如此。Parquet 自带的布隆过滤器正好能覆盖这种情况。它们会被写入 Parquet 文件本身,读取时会查询这些布隆过滤器,从而跳过不可能包含所搜索值的行组。
Hudi 会按列从 Hadoop 配置中将这些设置透传给 Parquet 写入器:
| 配置键 | 含义 |
|---|---|
parquet.bloom.filter.enabled#<column> | 为 <column> 写入布隆过滤器 |
parquet.bloom.filter.expected.ndv#<column> | 预期的不同值数量,用于确定过滤器的大小 |
<column> 可以是任何你按等值条件过滤的数据列——不包括记录键(record key),也与下方注释中讨论的记录键布隆索引无关。请在写入器所使用的 Hadoop 配置上设置这些键;在 Spark 中,spark.hadoop. 前缀会将它们转发过去:
--conf spark.hadoop.parquet.bloom.filter.enabled#session_id=true
--conf spark.hadoop.parquet.bloom.filter.expected.ndv#session_id=100000
为 expected.ndv 给出该列的一个合理估算值。估算过低,过滤器会趋于饱和而不再过滤掉任何数据;估算过高,则白白增大文件体积。
这是一个写入时的决策:只有在你设置它之后写入的文件才会带上这些过滤器,因此已有表需要通过后续的写入、compaction 或 clustering 逐步重写才能获得这些过滤器。
在读取端,Spark 3.x 不需要额外配置。通过 Hudi datasource 读回表时会 consult(参考)这些过滤器,前提是查询带有可下推到 Parquet reader 的等值谓词——如果查询过滤的值在任何 row group 中都不存在,则会完全跳过这些 row group。Parquet 自身读取端的开关 parquet.filter.bloom.enabled 保持默认值,Hudi 从不覆盖它,因此读取端没有需要开启的开关。
note
不要把上面这些配置与 Hudi 自己的 hoodie.parquet.bloom.filter.enabled 混淆,尽管名称几乎相同,但这是另一个功能。该配置控制 Hudi 是否将**记录键(record key)**的布隆过滤器写入文件页脚,供更新(upsert)时的 bloom 索引使用;它的默认值为 true,仅在元字段被填充时生效,并且当 hoodie.index.type 指定为 BLOOM 索引时也会自动启用。它与读取路径上的按列跳过无关,设置它并不会启用本文所述的 Parquet 列过滤器。
caution
Hudi 通过反射应用这些设置,因此如果你类路径上的 Parquet 版本早于 withBloomFilterEnabled / withBloomFilterNDV 这些 builder 方法,这些配置键会被静默忽略而不是报错拒绝。如果你发现文件大小或查询行为没有任何变化,请先检查你的 Parquet 版本。
博客
评论
登录后参与评论