 KnowForge
如何在 Kyuubi 中使用 Spark 自适应查询执行(AQE)
 师成· 更新于 2026-09-29· 阅读 20 分钟· 0 次阅读
AQE 基础知识
Spark 自适应查询执行(Adaptive Query Execution,AQE)是一种在查询执行过程中进行的查询再优化机制。
从技术架构上看,AQE 是一个基于运行时统计信息对查询进行动态规划和重新规划的框架,它支持多种优化能力,例如:
- 动态切换 Join 策略
- 动态合并 Shuffle 分区
- 动态处理数据倾斜的 Join
在 Kyuubi 中,我们强烈建议你默认为 Kyuubi 引擎开启 AQE 的全部功能,无论你运行 Kyuubi 和 Spark 的平台是什么。
动态切换 Join 策略
Spark 支持多种 Join 策略,其中当参与 Join 的任一数据集能很好地放入内存时,BroadcastHash Join 通常是性能最优的。正因如此,当某个 Join 关系的估算大小小于 spark.sql.autoBroadcastJoinThreshold 时,Spark 会规划一个 BroadcastHash Join。
spark.sql.autoBroadcastJoinThreshold=10M没有 AQE 时,连接关系的估算大小来源于原始表的统计信息,这在大多数真实场景中可能会出错。例如,连接关系是一个收敛的复合操作,而非单次表扫描。在这种情况下,Spark 可能无法将连接策略切换为 BroadcastHash Join。而借助 AQE,我们可以在运行时准确计算该复合操作的大小。这样,如果该大小满足 spark.sql.autoBroadcastJoinThreshold,Spark 就能明确无误地重新规划连接策略。
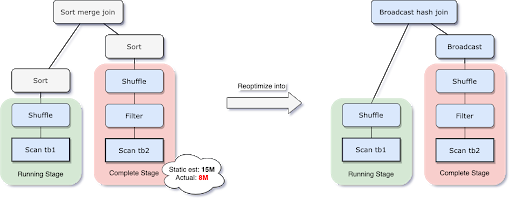
此外,当 spark.sql.adaptive.localShuffleReader.enabled=true 并且 SortMerge Join 已转换为 BroadcastHash Join 后,Spark 还会进一步优化,通过将常规 shuffle 转换为本地化 shuffle 来减少网络流量。
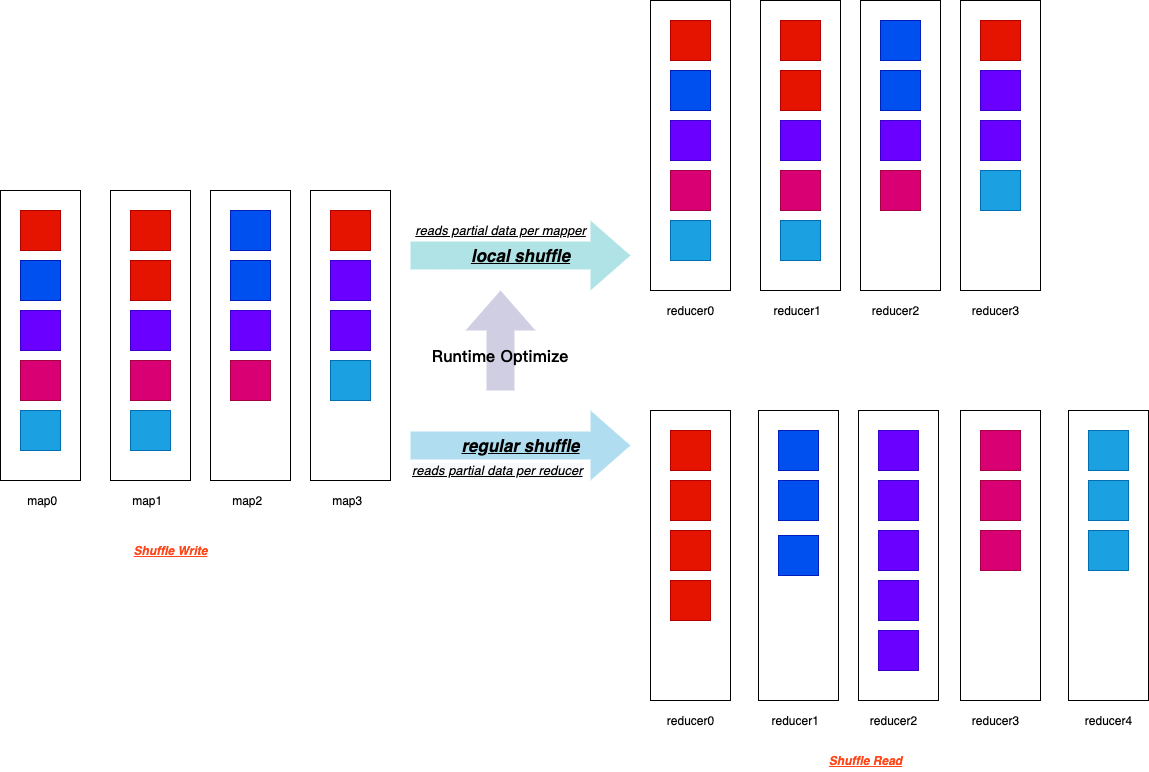
如上图所示,本地 shuffle reader 可以从本地存储中读取所有必需的 shuffle 文件,实际上无需执行跨网络的 shuffle。
本地 shuffle reader 优化的核心在于:当应用 AQE 规则后 SortMerge Join 转换为 BroadcastHash Join 时,避免进行 shuffle。
动态合并 Shuffle 分区
在没有该功能时,Spark 本身有时会成为小文件的制造者,尤其是在像 Kyuubi 那样纯 SQL 的使用方式下,例如:
- 当
spark.sql.shuffle.partitions相对于总输出大小设置得过大时,shuffle 阶段之后会产生非常小或空的文件。 - 当 Spark 将一系列经过优化的
BroadcastHash Join与Union一起执行时,每个分区的最终输出大小可能会因连接条件而减小,但最终输出文件的总数却会激增。 - 一些带有选择性过滤器以生成临时数据的流水线作业。
- 等等。
读取小文件会导致分区或任务非常小。Spark 任务的 I/O 吞吐量会变差,并且更容易受到调度开销和任务启动开销的影响。
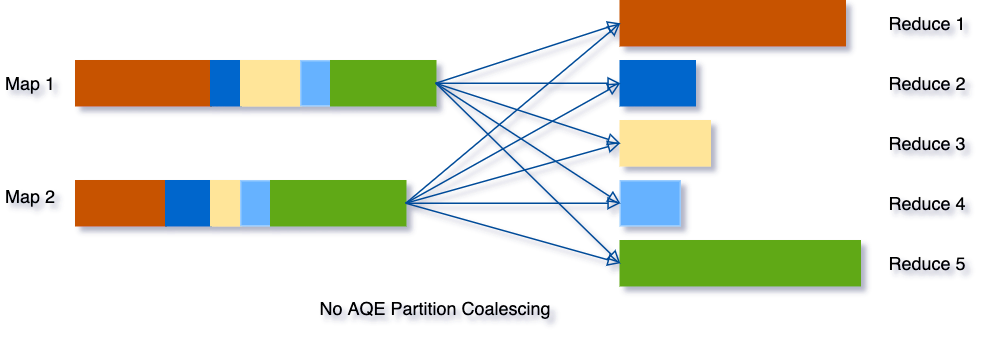
合并小分区可以节省资源并提升集群吞吐量。Spark 提供了多种处理小文件问题的方式,例如使用 distribute by 子句在分区列上追加一次 shuffle 操作,或者使用 HINT[5]。在大多数场景下,你需要充分了解自己的数据、Spark 作业以及相关配置,才能因地制宜地应用这些方案。日常最常用的配置 spark.sql.shuffle.partitions 依赖于数据,且无法在单条 Spark SQL 查询中动态更改。对于包含多个 stage 的真实 Spark 作业而言,不可能有一个放之四海而皆准的取值。
不过,有了 AQE,事情就轻松多了,Spark 会自动完成分区合并。
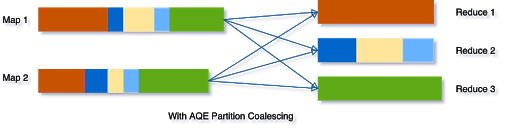
这可以简化 Spark SQL 查询执行时对 shuffle 分区数量的调优,你无需再为了适配数据集而设置一个合适的 shuffle 分区数。
要启用该功能,我们需要将下面两个配置设为 true。
spark.sql.adaptive.enabled=true
spark.sql.adaptive.coalescePartitions.enabled=true
其他最佳实践提示
要使用该功能进一步调优我们的 Spark 作业,我们还需要了解以下这些配置。
spark.sql.adaptive.advisoryPartitionSizeInBytes=128m
spark.sql.adaptive.coalescePartitions.minPartitionNum=1
spark.sql.adaptive.coalescePartitions.initialPartitionNum=200
如何设置 spark.sql.adaptive.advisoryPartitionSizeInBytes?
它表示自适应查询执行期间 shuffle 分区的建议字节大小,在 Spark 合并较小的 shuffle 分区或拆分倾斜的 shuffle 分区时生效。spark.sql.adaptive.advisoryPartitionSizeInBytes 的默认值为 64M。通常,如果我们使用 HDFS 进行数据读写,将其与 HDFS 的块大小相匹配应是最佳选择,即 128MB 或 256MB。
因此,Spark 中所有的块或分区以及 HDFS 中的文件都会被切分为 128MB/256MB 的数据块。试想一下,现在所有用于扫描(scan)、落地(sink)以及中间 shuffle map 的任务处理的都是大小基本均匀的数据分区。这将使我们更容易配置 executor 资源,甚至可以用一种规格通吃。
如何设置 spark.sql.adaptive.coalescePartitions.minPartitionNum?
它表示合并后 shuffle 分区的建议(不保证的)最小数量。若未设置,默认值为 Spark 应用的默认并行度。默认并行度由 spark.default.parallelism 定义,否则为已注册的 CPU 核心总数。我猜 Spark 社区采用这一行为的动机是为了最大化利用应用的资源和并发能力。
但总有例外。将这两个看似无关的参数联系起来对用户来说可能有些棘手。该配置默认是可选的,这意味着在大多数实际场景中用户可能无需调整它。但 spark.default.parallelism 由来已久且广为人知。如果用户意外地将默认并行度过高设置,可能会阻碍 AQE 将分区合并到合理的数量。另一个需要特别注意的场景是数据写入。通常,对于最终输出阶段而言,合并分区以避免小文件问题比任务并发更为重要。更好的数据布局能让众多下游作业受益。在这种情况下,我建议将 spark.sql.adaptive.coalescePartitions.minPartitionNum 设置为 1,因为 Spark 会尽力(但不保证)为输出合并分区。
如何设置 spark.sql.adaptive.coalescePartitions.initialPartitionNum?
它表示合并前 shuffle 分区的初始数量。默认情况下,它等于 spark.sql.shuffle.partitions(200)。首先,最好显式设置它,而不是回退使用 spark.sql.shuffle.partitions。Spark 社区建议将其设置为一个较大的值,因为 Spark 会动态合并 shuffle 分区,我对此完全赞同。
动态处理倾斜 Join
没有 AQE 时,在 shuffle 阶段,map-reduce 计算模型中数据倾斜的问题很可能发生。数据倾斜会导致 Spark 作业出现一个或多个长尾任务,从而严重降低查询性能。该特性会动态处理 SortMerge Join 中的倾斜问题,方法是将倾斜的任务拆分(必要时进行复制)为大小大致均匀的任务。例如,该优化会将过大的分区拆分为子分区,并将其与另一侧连接的对应分区进行连接。
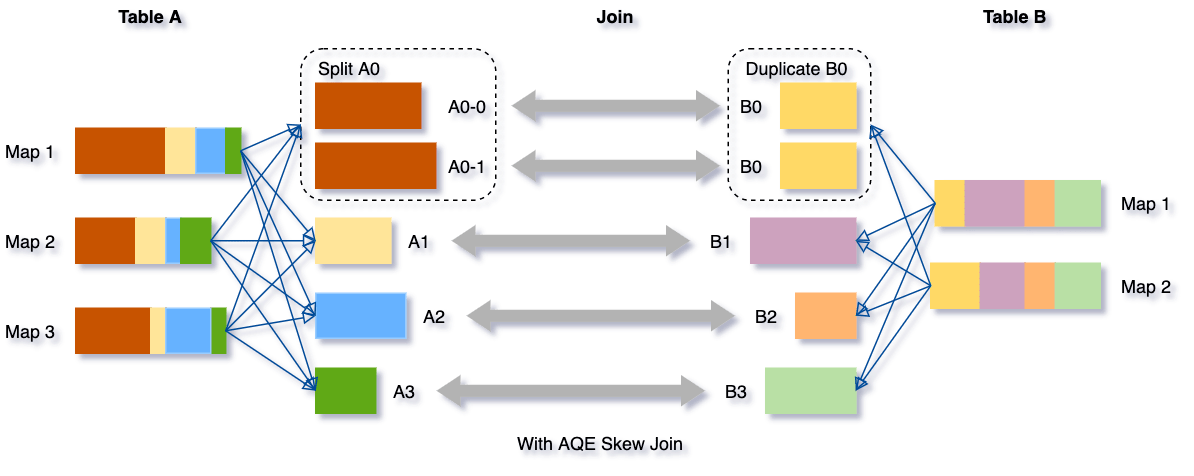
要启用此特性,我们需要将以下两个配置设置为 true。
spark.sql.adaptive.enabled=true
spark.sql.adaptive.skewJoin.enabled=true
其他最佳实践提示
要借助此功能进一步调优我们的 Spark 作业,我们还需要了解以下这些配置项。
spark.sql.adaptive.skewJoin.skewedPartitionFactor=5
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes=256M
spark.sql.adaptive.advisoryPartitionSizeInBytes=64M
如何设置 spark.sql.adaptive.skewJoin.skewedPartitionFactor 和 skewedPartitionThresholdInBytes?
Spark 使用这两个配置项以及分区大小的中位数(不是平均值)来检测是否存在分区倾斜。
partition size > skewedPartitionFactor * the median partition size && \
skewedPartitionThresholdInBytes
当 Spark 拆分倾斜分区以达到 spark.sql.adaptive.advisoryPartitionSizeInBytes 的目标值时,理想情况下 skewedPartitionThresholdInBytes 应当大于 advisoryPartitionSizeInBytes。因此,如果你打算启用该功能,那么每当增大 advisoryPartitionSizeInBytes 时,也应当相应增大 skewedPartitionThresholdInBytes。
隐藏特性
DemoteBroadcastHashJoin
Spark 内部有一条优化规则,用于检测空分区比例较高的 join 子节点,并为其添加不使用 broadcast hash join 的提示,以避免对其进行广播。
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin=0.2默认情况下,如果数据集中包含数据的分区数少于 20%,Spark 将不会对该数据集进行广播。
EliminateJoinToEmptyRelation
此优化规则会检测 Join 并将其转换为空的 LocalRelation。
禁用隐藏特性
如果出现性能回退或 Bug,我们可以排除部分 AQE 的附加规则。例如:
SET spark.sql.adaptive.optimizer.excludedRules=org.apache.spark.sql.execution.adaptive.DemoteBroadcastHashJoin在 Kyuubi 中应用 AQE 的最佳实践
Kyuubi 是一项长期运行的服务,旨在让最终用户无需掌握太多 Spark 基础知识即可轻松使用 Spark SQL。在服务端提供一套适用于大多数场景的基础配置至关重要。
设置默认配置
在引擎侧通过 spark-defaults.conf 进行配置,是为 Kyuubi 启用 AQE 的最佳方式。所有引擎在实例化时都会启用 AQE。
以下是我们平台在部署 Kyuubi 时使用的一项配置设置。
spark.sql.adaptive.enabled=true
spark.sql.adaptive.forceApply=false
spark.sql.adaptive.logLevel=info
spark.sql.adaptive.advisoryPartitionSizeInBytes=256m
spark.sql.adaptive.coalescePartitions.enabled=true
spark.sql.adaptive.coalescePartitions.minPartitionNum=1
spark.sql.adaptive.coalescePartitions.initialPartitionNum=8192
spark.sql.adaptive.fetchShuffleBlocksInBatch=true
spark.sql.adaptive.localShuffleReader.enabled=true
spark.sql.adaptive.skewJoin.enabled=true
spark.sql.adaptive.skewJoin.skewedPartitionFactor=5
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes=400m
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin=0.2
spark.sql.adaptive.optimizer.excludedRules
spark.sql.autoBroadcastJoinThreshold=-1
提示
默认开启 AQE 可以显著提升用户体验。其他子功能均已启用。advisoryPartitionSizeInBytes 以 HDFS 块大小为目标;minPartitionNum 设置为 1 是出于优先进行合并(coalescing)的考虑;initialPartitionNum 的取值较高。由于 AQE 至少需要一次 shuffle,理想情况下我们应将 autoBroadcastJoinThreshold 设置为 -1,以便让所有包含连接的用户查询都参与带 shuffle 的 SortMerge Join。但这样一来,动态切换连接策略(Dynamically Switch Join Strategies)功能似乎就无法在后续生效了。到目前为止,这似乎是 Spark AQE 的一个疑似笔误导致的限制。
动态设置
所有与 AQE 相关的配置都可以在运行时更改,这意味着仍可在客户端通过 SET 语法针对每条 SQL 查询修改特定配置,从而进行更精细的控制。
Spark 已知问题
对于 Spark 版本(<3.1),即使广播的关系数据很小,我们也需要将 spark.sql.broadcastTimeout(300s) 调得更高。
关于 Spark AQE 功能中可能发现的其他潜在问题,可参阅 SPARK-33828: SQL Adaptive Query Execution QA。
参考资料
评论
登录后参与评论