 KnowForge
如何在 Kyuubi 中使用 Spark 动态资源分配(DRA)
 师成· 更新于 2026-09-29· 阅读 14 分钟· 0 次阅读
当我们在生产环境中采用 Kyuubi 时,总是希望更经济高效地使用环境中的计算资源。K8S、YARN 等集群管理器负责管理集群计算资源,这些资源被划分到不同的队列或命名空间中,并配有各自的 ACL 与配额。
在 Kyuubi 中,我们从集群管理器获取计算资源来提交引擎。引擎响应各种类型的客户端请求,其中一些请求需要消耗大量计算资源来处理,而另一些可能只需要很少的资源即可完成。如果引擎的规模是固定的,即 spark.executor.instances 为固定值,那么对于一些轻量级工作负载会造成资源浪费,而对于一些重负载工作负载,并发容量又可能不足,从而导致性能不佳。
当引擎中有执行器空闲时,我们应当及时将其释放回资源池;反之,当引擎正在处理繁重任务时,我们应当能够更高效地获取并使用更多资源。一方面,我们需要依赖资源管理器的能力来实现高效的资源分配、资源隔离与共享;另一方面,我们需要为引擎开启 Spark 的 DRA 特性,以实现引擎执行器的弹性伸缩。
动态资源分配基础
Spark 提供了一种根据工作负载动态调整应用资源的机制,这意味着应用可以在资源不再被使用时将其归还给集群,并在之后有需求时再次申请。当多个应用在 YARN、Kubernetes 及其他平台上共享资源时,该特性非常实用。
对于 Kyuubi 引擎这类典型的 Spark 应用,动态分配允许 Spark 根据工作负载动态伸缩分配给它们的集群资源。启用动态分配后,当引擎存在待处理的任务积压时,可以通过 ExecutorAllocationManager 申请执行器;当引擎中的执行器变为空闲时,这些执行器会被释放,占用的资源归还给集群管理器,随后同一队列中的其他引擎或其他应用便可获取这些资源。
如何启用动态资源分配
启用该特性的前提是,即使生成数据的执行器被回收,下游阶段仍能正常访问 shuffle 数据。
Spark 提供了两种 shuffle 数据跟踪的实现方式。只要启用其中任意一种,我们就能正常使用 DRA 特性。
带外部 Shuffle 服务的动态资源分配
拥有外部 Shuffle 服务(ESS)可以确保所有数据都存储在执行器之外。这一前提是必要的,因为 Spark 需要保证移除执行器不会同时移除 shuffle 数据。当使用提供 ESS 的集群管理器部署 Kyuubi 时,可通过以下配置为所有引擎启用 DRA。
spark.dynamicAllocation.enabled=true
spark.shuffle.service.enabled=true另一件需要确认的事情是,spark.shuffle.service.port 应配置为指向 ESS 运行所在的端口。
不使用外部 Shuffle 服务的动态资源分配
ESS 功能的实现依赖于集群管理器。例如在 Yarn 中,ESS 需要在整个集群范围内部署,并且实际运行在 Yarn 的 NodeManager 组件中。不过,如果在 Kubernetes 上运行 Kyuubi 引擎,ESS 目前还不可用。从 Spark 3.0 开始,DRA 可以在没有 ESS 的情况下运行。相关功能称为 Shuffle Tracking,由 SPARK-27963 引入。
当部署的 Kyuubi 使用的集群管理器没有 ESS,或者 ESS 不太可行时,请改用以下配置,通过 Shuffle Tracking 为所有引擎启用 DRA。
spark.dynamicAllocation.enabled=true
spark.dynamicAllocation.shuffleTracking.enabled=true
当启用 Shuffle Tracking 时,spark.dynamicAllocation.shuffleTracking.timeout(默认值:infinity)用于控制持有 shuffle 数据的 executor 的超时时间。默认情况下,Spark 依赖垃圾回收来释放 shuffle 数据,从而能够释放 executor。当垃圾回收清理 shuffle 的速度不够快时,该超时机制会强制 Spark 删除 executor,即使它们仍在存储 shuffle 数据。
配置启用动态资源分配(DRA)的引擎规格
单个 executor 的资源(如 CPU 和内存)可以是固定大小的。因此,范围 [minExecutors, maxExecutors] 决定了引擎可以从集群管理器获取多少资源。
一方面,minExecutors 告诉 Spark 至少保留多少个 executor。如果将其设置得过于接近 0(默认值),当集群管理器长时间处于繁忙状态时,引擎可能会因资源不足而报错。不过,minExecutors 越大,引擎空闲期间可能浪费的资源就越多。
另一方面,maxExecutors 决定了引擎能够达到的 executor 数量上限。从单个引擎的角度来看,该值越大越好,以便处理更繁重的查询。然而,从整个集群的资源角度考虑,我们必须将其限制在一个合理的范围内。否则,一个大型查询可能会触发其所在引擎从队列/命名空间中占用过多资源,并长时间占用这些资源,这对于高效利用资源而言并非良策。在这种情况下,我们更希望这类庞大任务在有限的并发度下以较慢的速度完成。
以下 Spark 配置项用于设置 DRA 的资源规格。
spark.dynamicAllocation.minExecutors=10
spark.dynamicAllocation.maxExecutors=500
此外,另一个名为 spark.dynamicAllocation.initialExecutors 的配置可用于决定在引擎启动或故障转移期间请求多少 executor。
理想情况下,它们之间的大小关系应为 minExecutors <= initialExecutors <= maxExecutors。
资源分配策略
当 DRA 发现当前资源不足以支撑当前的工作负载时,它会请求更多的 executor。
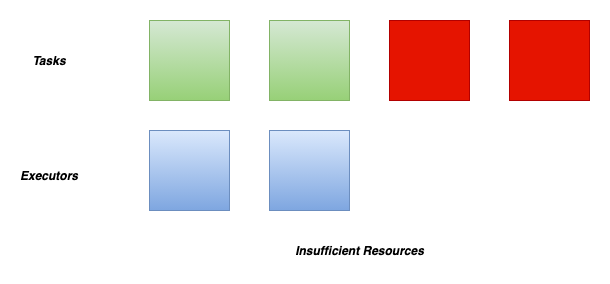
默认情况下,动态分配会根据待处理的任务数量请求足够的 executor,以最大化并行度。
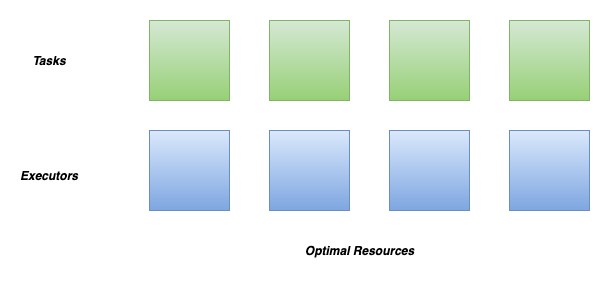
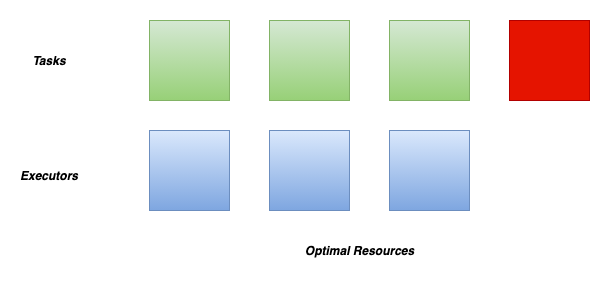
虽然这样可以将作业的延迟降到最低,但对于小任务而言,默认行为可能会因为分配 executor 的开销而浪费大量资源,因为有些 executor 甚至可能完全没有执行任何工作。
在这种情况下,我们可以稍微调低 spark.dynamicAllocation.executorAllocationRatio,以相对于完全并行度减少 executor 的数量。例如,设置为 0.5 会将目标 executor 数量除以 2。
完成一个任务后,Spark Driver 会为拥有可用核心的 executor 调度新的任务。随着待处理的任务越来越少,由于没有新的任务到来,一些 executor 变为空闲状态。
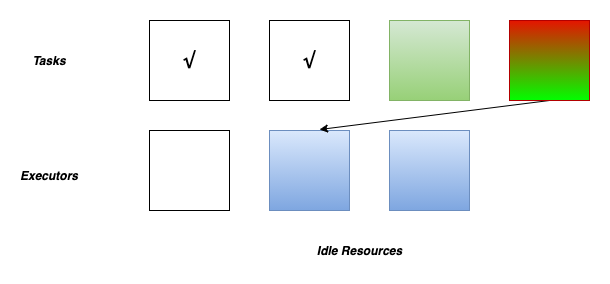
如果某个 executor 达到了最大超时时间,它将被移除。
spark.dynamicAllocation.executorIdleTimeout=60s
spark.dynamicAllocation.cachedExecutorIdleTimeout=infinity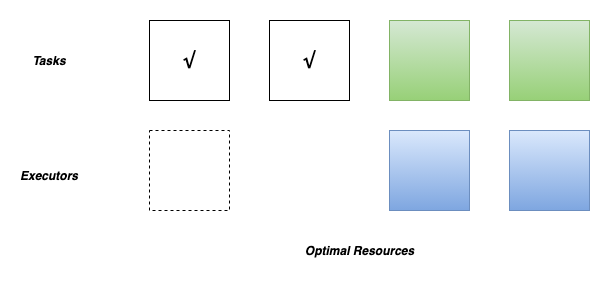
如果 DRA 发现有积压的待处理任务超过了超时时间,将会请求新的执行器(executor),这由以下配置进行控制。
spark.dynamicAllocation.schedulerBacklogTimeout=1s
spark.dynamicAllocation.sustainedSchedulerBacklogTimeout=1s
在 Kyuubi 中应用 DRA 的最佳实践
Kyuubi 是一个长期运行的服务,旨在让最终用户无需掌握太多 Spark 基础知识即可轻松使用 Spark SQL。因此,在服务端进行一套适用于大多数场景的资源管理基础配置至关重要。
设置默认配置
在引擎侧通过 spark-defaults.conf 进行配置是为 Kyuubi 配置 DRA 的最佳方式。所有引擎在实例化时都会启用 DRA。
以下是我们平台在部署 Kyuubi 时使用的一项配置设置。
spark.dynamicAllocation.enabled=true
##false if prefer shuffle tracking than ESS
spark.shuffle.service.enabled=true
spark.dynamicAllocation.initialExecutors=10
spark.dynamicAllocation.minExecutors=10
spark.dynamicAllocation.maxExecutors=500
spark.dynamicAllocation.executorAllocationRatio=0.5
spark.dynamicAllocation.executorIdleTimeout=60s
spark.dynamicAllocation.cachedExecutorIdleTimeout=30min
# true if prefer shuffle tracking than ESS
spark.dynamicAllocation.shuffleTracking.enabled=false
spark.dynamicAllocation.shuffleTracking.timeout=30min
spark.dynamicAllocation.schedulerBacklogTimeout=1s
spark.dynamicAllocation.sustainedSchedulerBacklogTimeout=1s
spark.cleaner.periodicGC.interval=5min
请注意,当启用 spark.dynamicAllocation.shuffleTracking.enabled 时,spark.cleaner.periodicGC.interval=5min 在此非常有用,因为它可以让 Spark 更加积极地对 shuffle 数据进行 GC。
设置用户默认配置
在服务端,不同用户的工作负载可能各不相同。
此时我们可以通过 $KYUUBI_HOME/conf/kyuubi-defaults.conf 中的 用户默认配置 为他们设置不同的默认值。
# For a user named kent
___kent___.spark.dynamicAllocation.maxExecutors=20
# For a user named bob
___bob___.spark.dynamicAllocation.maxExecutors=600
在此场景下,名为 kent 的用户只能为他的引擎使用 20 个 executor,而 bob 则可以使用 600 个 executor,以获得更好的性能或处理繁重的工作负载。
动态设置
与 AQE 相关的所有配置都是 Spark core 的静态配置,在每条 SQL 查询之前无法通过 SET 命令更改。例如:
SET spark.dynamicAllocation.maxExecutors=33;
SELECT * FROM default.tableA;对于上述情况,33 这一数值不会产生影响,因为 Spark 不支持在运行时更改内核相关配置。
相反,在某些特定场景下,最终用户可以通过 JDBC Connection URL 来设置它们。
参考资料
评论
登录后参与评论