 KnowForge
大数据结果集的解决方案
 师成· 更新于 2026-09-29· 阅读 6 分钟· 0 次阅读
大结果集的解决方案
大结果集的解决方案
通常,当用户向 Spark SQL 引擎提交 SELECT 查询时,Driver 会调用 collect 触发计算,并收集所有任务(即 RDD 的分区)的完整数据集;待所有分区的数据到达后,客户端再通过 Kyuubi Server 以小批量方式从 Driver 拉取结果集。
因此,对于结果集较大的查询,瓶颈就在于 Spark Driver。为了避免 OOM,Spark 提供了配置 spark.driver.maxResultSize,其默认值为 1g,如果你的查询结果集达到数 GB,应当同时调大该配置以及 spark.driver.memory。但如果结果集大小达到数十 GB 甚至数百 GB 呢?最好还是有增量收集模式可用。
增量收集
自 v1.4.0-incubating 起,Kyuubi 支持增量收集模式,它是针对大结果集的一种解决方案。该功能默认关闭,你可以通过将配置 kyuubi.operation.incremental.collect 设置为 true 来开启。
增量收集将收集方式从 collect 改为 toLocalIterator。toLocalIterator 是一个 Spark action,它会依次提交 Job 来检索各个分区。每当一个分区被取回,客户端就会通过 Kyuubi Server 以流式方式从 Driver 拉取结果集。这使 Driver 的内存占用从完整结果集的大小显著降低到最大分区的大小。
增量收集并非万能药,你需要谨慎开启,因为它可能会显著影响性能。而且即使在增量收集模式下,当多个查询并发执行时,每个查询仍需要在 Driver 内存中保留一个分区的数据。因此,控制并发查询的数量以避免 OOM 依然非常重要。
在单个连接中使用
如上所述,增量收集模式并不适合通用的查询场景,你可以通过使用
beeline -u 'jdbc:hive2://kyuubi:10009/?spark.driver.maxResultSize=8g;spark.driver.memory=12g#kyuubi.engine.share.level=CONNECTION;kyuubi.operation.incremental.collect=true' \
    --incremental=true \
    -f big_result_query.sql
beeline 客户端需要设置 --incremental=true,否则将获取并缓冲整个结果集后才会显示,这可能导致客户端 OOM。
在会话中更改增量收集模式
配置 kyuubi.operation.incremental.collect 也可以在会话中使用 SET 语句进行修改。
~ beeline -u 'jdbc:hive2://localhost:10009'
Connected to: Apache Kyuubi (Incubating) (version 1.5.0-SNAPSHOT)

0: jdbc:hive2://localhost:10009/> set kyuubi.operation.incremental.collect=true;
+---------------------------------------+--------+
|                  key                  | value  |
+---------------------------------------+--------+
| kyuubi.operation.incremental.collect  | true   |
+---------------------------------------+--------+
1 row selected (0.039 seconds)

0: jdbc:hive2://localhost:10009/> select /*+ REPARTITION(5) */ * from range(1, 10);
+-----+
| id  |
+-----+
| 2   |
| 6   |
| 7   |
| 0   |
| 5   |
| 3   |
| 4   |
| 1   |
| 8   |
| 9   |
+-----+
10 rows selected (1.929 seconds)

0: jdbc:hive2://localhost:10009/> set kyuubi.operation.incremental.collect=false;
+---------------------------------------+--------+
|                  key                  | value  |
+---------------------------------------+--------+
| kyuubi.operation.incremental.collect  | false   |
+---------------------------------------+--------+
1 row selected (0.027 seconds)

0: jdbc:hive2://localhost:10009/> select /*+ REPARTITION(5) */ * from range(1, 10);
+-----+
| id  |
+-----+
| 2   |
| 6   |
| 7   |
| 0   |
| 5   |
| 3   |
| 4   |
| 1   |
| 8   |
| 9   |
+-----+
10 rows selected (0.128 seconds)
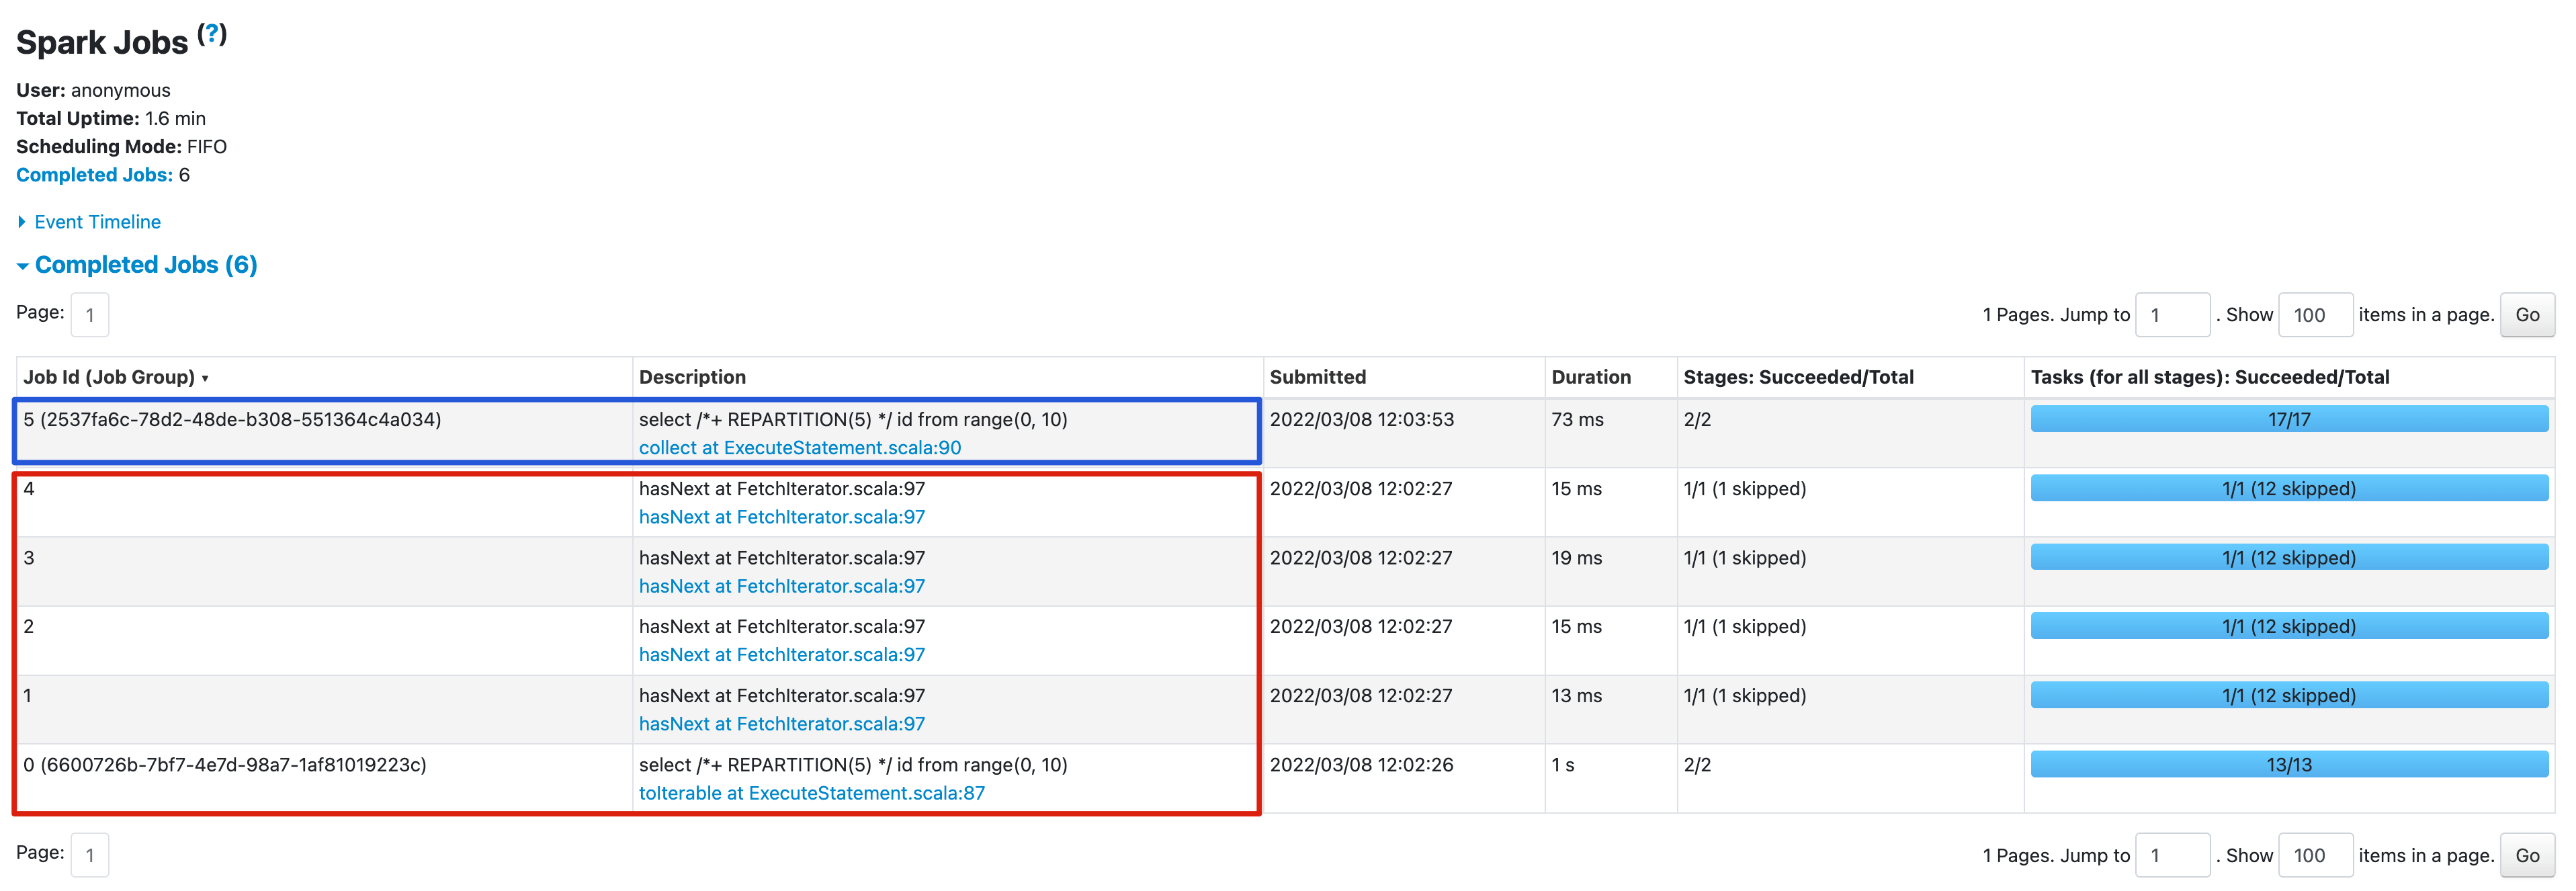
从 Spark UI 中可以看到,在增量收集模式下,该查询产生了 5 个 job(红色方框),而在普通模式下只产生了 1 个 job(蓝色方框)。
评论
登录后参与评论