 KnowForge
使用 Flink
 师成· 更新于 2026-09-29· 阅读 49 分钟· 0 次阅读
CDC 摄入
CDC(change data capture,变更数据捕获)用于跟踪源系统中数据的变更演进,以便下游流程或系统能够针对这些变更采取行动。我们推荐以下两种方式将 CDC 数据同步到 Hudi:
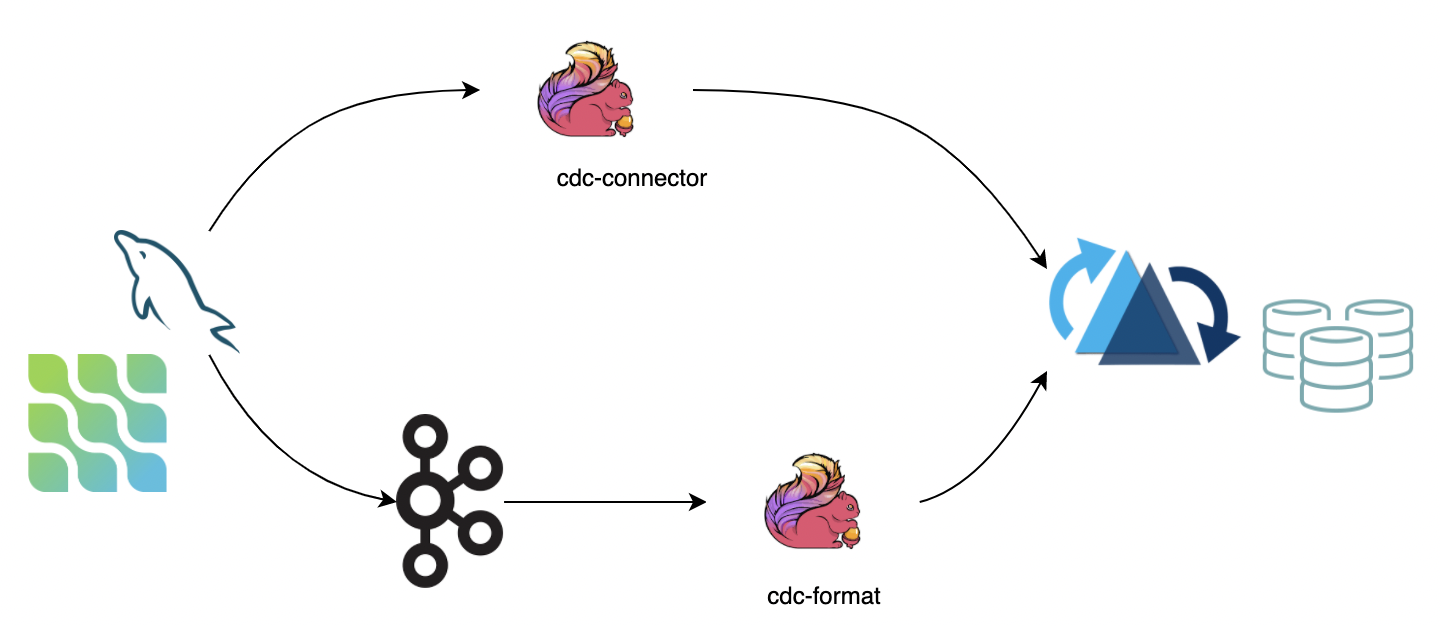
- 使用 Apache Flink-CDC 直接连接数据库服务器,并将 binlog 数据同步到 Hudi。这种方式的优点是不依赖消息队列,缺点是会给数据库服务器带来压力。
- 使用 Flink CDC 格式从消息队列(例如 Kafka)消费数据。这种方式的优点是具有高度的可扩展性,缺点是依赖消息队列。
注意
如果上游数据无法保证有序性,你需要显式指定 ordering.fields 选项。
批量插入
针对快照数据导入需求,如果快照数据来自其他数据源,请使用 bulk_insert 模式,将快照数据快速导入到 Hudi 中。
注意
bulk_insert 会跳过序列化和数据合并。同时也会跳过数据去重,因此需要由用户保证数据的唯一性。
注意
bulk_insert 在 batch execution mode(批处理执行模式)下效率更高。默认情况下,batch execution mode 会按分区路径对输入记录排序,再将这些记录写入 Hudi,从而避免因频繁切换文件句柄导致的写入性能下降。
注意
bulk_insert 的并行度由 write.tasks 指定。并行度会影响小文件的数量。理论上,bulk_insert 的并行度等于 bucket 的数量。(特别是当每个 bucket 写入达到最大文件大小时,会滚动切换到新的文件句柄。)最终的文件数量将大于或等于 write.bucket_assign.tasks。
选项
| 选项名称 | 是否必填 | 默认值 | 说明 |
|---|---|---|---|
write.operation | true | upsert | 设置为 bulk_insert 以启用此功能 |
write.tasks | false | 4 | bulk_insert 的并行度;文件数量 ≥ write.bucket_assign.tasks |
write.bulk_insert.shuffle_input | false | true | 写入前是否按键字段对数据进行 shuffle。启用该选项可减少小文件数量,但可能引入数据倾斜风险 |
write.bulk_insert.sort_input | false | true | 写入前是否按键字段对数据进行排序。当写入任务涉及多个分区时,启用该选项可减少小文件数量 |
write.sort.memory | false | 128 | 排序算符可用的托管内存,默认为 128 MB |
索引引导(Index Bootstrap)
用于同时导入快照数据和增量数据:如果快照数据已经通过 bulk insert 写入 Hudi,用户可以实时写入增量数据,并通过索引引导功能确保数据不重复。
note
如果发现这一过程非常耗时,可以在写入快照数据的同时增加资源以流式模式写入,然后在写入增量数据时减少资源(或启用限速功能)。
选项
| 选项名称 | 是否必填 | 默认值 | 说明 |
|---|---|---|---|
index.bootstrap.enabled | true | false | 启用索引引导后,Hudi 表中的剩余记录将一次性加载到 Flink 状态中 |
index.partition.regex | false | * | 优化选项。设置正则表达式以过滤分区。默认加载所有分区到 Flink 状态 |
使用方法
- 使用
CREATE TABLE创建对应 Hudi 表的语句。注意table.type必须设置正确。 - 设置
index.bootstrap.enabled=true,以启用索引引导功能。 - 在
flink-conf.yaml中设置 Flink checkpoint 的容错次数:execution.checkpointing.tolerable-failed-checkpoints = n(取决于 Flink 的 checkpoint 调度次数)。 - 等待第一个 checkpoint 成功,表示索引引导已完成。
- 索引引导完成后,用户可以退出并保存 savepoint(或直接使用外部化的 checkpoint)。
- 重启作业,并将
index.bootstrap.enable设置为false。
注意
- 索引引导是阻塞式的,因此在索引引导期间无法完成 checkpoint。
- 索引引导由输入数据触发。用户需要确保每个分区中至少有一条记录。
- 索引引导是并发执行的。用户可以在日志中搜索
finish loading the index under partition和Load record from file来观察索引引导的进度。 - 第一个成功的 checkpoint 表示索引引导已完成。从 checkpoint 恢复时无需再次加载索引。
Changelog 模式
Hudi 可以保留消息的所有中间变更(I / -U / U / D),然后通过 Flink 中的有状态计算来消费这些变更,从而构建近实时的数据仓库 ETL 管道(增量计算)。Hudi MOR 表以行的形式存储消息,支持保留所有变更日志(在格式层面的集成)。所有 changelog 记录都可以通过 Flink 流式读取器消费。
选项
| 选项名称 | 必填 | 默认值 | 说明 |
|---|---|---|---|
changelog.enabled | false | false | 默认关闭。关闭时具有 upsert 语义,仅保证保留合并后的消息,中间变更可能被合并。设置为 true 则支持消费所有变更 |
注意
批处理(快照)读取仍然会合并所有中间变更,无论格式是否已存储了中间 changelog 消息。
注意
将 changelog.enable 设置为 true 后,变更日志记录的保留仅为尽力而为:异步压缩任务会将变更日志记录合并为一条记录,因此如果流式数据源没有及时消费,压缩后每个键只能读取到合并后的那条记录。解决办法是通过调整压缩策略来为读取方预留缓冲时间,例如使用压缩选项 compaction.delta_commits 和 compaction.delta_seconds。
追加模式
对于 INSERT 模式写入操作,会直接写入新的 Parquet 文件,并且不启用自动文件大小调整。
追加写入缓冲区
针对仅追加的工作负载,Hudi 支持多种写入缓冲区策略,可以提升 Parquet 的压缩率和写入吞吐量。数据会在写入缓冲区内进行排序或批量聚合,然后再刷新到磁盘,从而将相似的值聚集在一起,以获得更好的列式压缩效果。
缓冲区策略通过 write.buffer.type 选择。在 Hudi 1.2.0 中,该选项取代了已弃用的 write.buffer.sort.enabled 标志。
| 选项名称 | 是否必需 | 默认值 | 说明 |
|---|---|---|---|
write.buffer.type | false | NONE | 追加写入的缓冲类型。取值:NONE(不缓冲)、BOUNDED_IN_MEMORY(配合异步写入的双缓冲)、DISRUPTOR(配合异步写入的环形缓冲,追求更高吞吐量时推荐使用)、CONTINUOUS_SORT(基于 TreeMap 的持续排序并增量排空) |
write.buffer.size | false | 1000 | 触发缓冲刷写的记录数阈值。适用于所有非 NONE 的缓冲类型 |
write.buffer.sort.keys | false | N/A | 以逗号分隔的排序键列(例如 col1,col2)。DISRUPTOR 和 CONTINUOUS_SORT 模式下为必填项 |
write.buffer.sort.continuous.drain.size | false | 1 | CONTINUOUS_SORT 模式下每次刷写周期排空的记录数。默认值 1 可实现平滑的增量排空;如需批量处理,可将其调大(例如 10–100) |
note
自 1.2.0 起,write.buffer.sort.enabled 已废弃。如需获得等效行为,请改用 write.buffer.type=DISRUPTOR。DISRUPTOR 和 CONTINUOUS_SORT 模式要求必须设置 write.buffer.sort.keys。
关于 Disruptor 专属的调优选项,请参阅 flink_tuning.md。
禁用元数据字段
对于不需要 Hudi 元数据字段(例如 _hoodie_commit_time、_hoodie_record_key)的仅追加工作负载,可以禁用这些字段以降低存储开销。当与不要求 Hudi 专属元数据的外部系统集成时,这一做法尤为有用。
| 选项名称 | 必填 | 默认值 | 备注 |
|---|---|---|---|
hoodie.populate.meta.fields | false | true | 是否填充 Hudi 元字段。对于仅追加的工作负载,将其设置为 false 可减少存储开销。注意:禁用后部分 Hudi 功能可能无法正常工作 |
Hudi 支持丰富的聚类策略,用于优化 INSERT 模式下的文件布局:
内联聚类
note
仅支持 Copy-on-Write(写时复制)表。
| 选项名称 | 必填 | 默认值 | 备注 |
|---|---|---|---|
write.insert.cluster | false | false | 摄取时是否合并小文件。对于 COW 表,启用该选项可使用小文件合并策略(不对键进行去重,但会影响吞吐量) |
异步聚类
| 选项名称 | 是否必填 | 默认值 | 说明 |
|---|---|---|---|
clustering.schedule.enabled | false | false | 是否在写入过程中调度聚类计划;默认为 false |
clustering.delta_commits | false | 4 | 调度聚类计划的增量提交次数;仅在 clustering.schedule.enabled 为 true 时有效 |
clustering.async.enabled | false | false | 是否异步执行聚类计划;默认为 false |
clustering.tasks | false | 4 | 聚类任务的并行度 |
clustering.plan.strategy.target.file.max.bytes | false | 1024*1024*1024 | 聚类组的目标文件大小;默认为 1 GB |
clustering.plan.strategy.small.file.limit | false | 600 | 小于该阈值(单位为 MB)的文件将作为聚类的候选对象 |
clustering.plan.strategy.sort.columns | false | N/A | 聚类时用于排序的列 |
聚类计划策略
Hudi 支持自定义聚类策略。Hudi 1.2.0 新增了 FlinkSkipSingleFileClusteringPlanStrategy(org.apache.hudi.client.clustering.plan.strategy.FlinkSkipSingleFileClusteringPlanStrategy),它会跳过已由单个文件构成的文件组,从而减少不必要的重写。
| 选项名称 | 必填 | 默认值 | 说明 |
|---|---|---|---|
clustering.plan.partition.filter.mode | false | NONE | 可选值:1) NONE:不做限制;2) RECENT_DAYS:选择代表最近若干天的分区;3) SELECTED_PARTITIONS:指定特定分区 |
clustering.plan.strategy.daybased.lookback.partitions | false | 2 | 回溯的分区数量;仅在 RECENT_DAYS 模式下生效 |
clustering.plan.strategy.cluster.begin.partition | false | N/A | 仅在 SELECTED_PARTITIONS 模式下生效;指定起始分区(含该分区) |
clustering.plan.strategy.cluster.end.partition | false | N/A | 仅在 SELECTED_PARTITIONS 模式下生效;指定结束分区(含该分区) |
clustering.plan.strategy.partition.regex.pattern | false | N/A | 用于过滤分区的正则表达式 |
clustering.plan.strategy.partition.selected | false | N/A | 特定分区,以逗号分隔 |
使用 Bucket 索引
Hudi Flink writer 支持两种写入索引:
- Flink state(默认)
- Bucket 索引(3 种变体:simple、partition-level、一致哈希)
对比
特性Bucket 索引Flink State 索引
工作原理使用确定的哈希算法将记录洗牌到各个桶中使用 Flink state 后端存储索引数据:记录键到其所在 file group 的文件 ID 的映射
计算/存储成本状态后端索引无需额外成本维护状态会产生计算和存储开销;处理大型 Hudi 表时可能成为瓶颈
性能由于没有状态开销,性能更好性能取决于状态后端的效率
File Group 灵活性Simple:每个分区的桶(file group)数量固定,一旦设定不可更改
Partition-Level:通过正则表达式为不同分区设定不同的固定桶(重新扩容需要 Spark 存储过程)
一致哈希:通过 clustering 自动调整桶大小根据当前表布局动态分配记录到 file group;对 file group 数量没有预先配置的限制
跨分区变更无法处理分区之间的变更(除非输入为 CDC 流)对跨分区变更的处理没有限制
note
桶索引支持在 COW 和 MOR 表上执行 UPSERT 写入操作。从 Hudi 1.2.0 开始,MOR + 桶索引 + upsert 已得到完整支持。桶索引不能与 Flink 中的 append 模式 配合使用。
桶索引示例
简单桶索引
所有分区中桶的数量是固定的:
CREATE TABLE orders_simple_bucket (
  order_id BIGINT,
  customer_id BIGINT,
  amount DOUBLE,
  order_date STRING,
  ts BIGINT,
  PRIMARY KEY (order_id) NOT ENFORCED
) PARTITIONED BY (order_date)
WITH (
  'connector' = 'hudi',
  'path' = 'hdfs:///warehouse/orders_simple',
  'table.type' = 'MERGE_ON_READ',

  -- Bucket Index Configuration
  'index.type' = 'BUCKET',
  'hoodie.bucket.index.engine' = 'SIMPLE',
  'hoodie.bucket.index.hash.field' = 'order_id',
  'hoodie.bucket.index.num.buckets' = '16'  -- Fixed 16 buckets for ALL partitions
);

-- Insert data
INSERT INTO orders_simple_bucket VALUES
  (1, 100, 99.99, '2024-01-15', 1000),
  (2, 101, 49.99, '2024-02-20', 2000);
分区级 Bucket 索引
基于正则表达式模式,为不同分区设置不同的 bucket 数量:
CREATE TABLE orders_partition_bucket (
  order_id BIGINT,
  customer_id BIGINT,
  amount DOUBLE,
  order_date STRING,
  ts BIGINT,
  PRIMARY KEY (order_id) NOT ENFORCED
) PARTITIONED BY (order_date)
WITH (
  'connector' = 'hudi',
  'path' = 'hdfs:///warehouse/orders_partition',
  'table.type' = 'MERGE_ON_READ',

  -- Bucket Index Configuration
  'index.type' = 'BUCKET',
  'hoodie.bucket.index.engine' = 'SIMPLE',
  'hoodie.bucket.index.hash.field' = 'order_id',

  -- Partition-Level Configuration
  'hoodie.bucket.index.num.buckets' = '8',  -- Default for non-matching partitions
  'hoodie.bucket.index.partition.rule.type' = 'regex',
  -- Black Friday (11-24), Cyber Monday (11-27), Christmas (12-25) get 128 buckets
  -- All other dates get 8 buckets (default)
  'hoodie.bucket.index.partition.expressions' = '\\d{4}-(11-(24|27)|12-25),128'
);

-- Insert data - bucket count varies by partition
INSERT INTO orders_partition_bucket VALUES
  (1, 100, 999.99, '2024-11-24', 1000),  -- Black Friday: 128 buckets
  (2, 101, 499.99, '2024-11-27', 2000),  -- Cyber Monday: 128 buckets
  (3, 102, 299.99, '2024-12-25', 3000),  -- Christmas: 128 buckets
  (4, 103, 49.99, '2024-01-15', 4000);   -- Regular day: 8 buckets
note
对于已有的简单桶索引表,可使用 Spark 的 partition_bucket_index_manager 存储过程升级为分区级桶索引。升级后,Flink 写入程序会自动从表元数据中加载相关表达式。
一致性哈希桶索引
通过聚类自动扩展开桶(需要 Spark 执行):
CREATE TABLE orders_consistent_hashing (
  order_id BIGINT,
  customer_id BIGINT,
  amount DOUBLE,
  order_date STRING,
  ts BIGINT,
  PRIMARY KEY (order_id) NOT ENFORCED
) PARTITIONED BY (order_date)
WITH (
  'connector' = 'hudi',
  'path' = 'hdfs:///warehouse/orders_consistent',
  'table.type' = 'MERGE_ON_READ',

  -- Consistent Hashing Bucket Index
  'index.type' = 'BUCKET',
  'hoodie.bucket.index.engine' = 'CONSISTENT_HASHING',
  'hoodie.bucket.index.hash.field' = 'order_id',

  -- Initial and boundary configuration
  'hoodie.bucket.index.num.buckets' = '4',      -- Initial bucket count
  'hoodie.bucket.index.min.num.buckets' = '2',  -- Minimum allowed
  'hoodie.bucket.index.max.num.buckets' = '128', -- Maximum allowed

  -- Clustering configuration (required for auto-resizing)
  'clustering.schedule.enabled' = 'true',
  'clustering.delta_commits' = '5',  -- Schedule clustering every 5 commits
  'clustering.plan.strategy.class' = 'org.apache.hudi.client.clustering.plan.strategy.FlinkConsistentBucketClusteringPlanStrategy',

  -- File size thresholds for bucket resizing
  'hoodie.clustering.plan.strategy.target.file.max.bytes' = '1073741824',  -- 1GB max
  'hoodie.clustering.plan.strategy.small.file.limit' = '314572800'  -- 300MB min
);

-- Insert data - buckets auto-adjust based on file sizes
INSERT INTO orders_consistent_hashing
SELECT * FROM source_stream;
注意
一致性哈希桶索引通过聚类自动调整桶数量。Flink 可以调度聚类计划,但目前执行仍需依赖 Spark。先设置
hoodie.bucket.index.num.buckets,系统会根据文件大小在最小/最大范围内动态调整。
配置参考
| 选项 | 适用范围 | 默认值 | 描述 |
|---|---|---|---|
index.type | 全部 | FLINK_STATE | 设置为 BUCKET 以启用桶索引 |
hoodie.bucket.index.engine | 全部 | SIMPLE | 引擎类型:SIMPLE 或 CONSISTENT_HASHING |
hoodie.bucket.index.hash.field | 全部 | 记录键 | 用于分桶哈希的字段;可以是记录键的子集 |
hoodie.bucket.index.num.buckets | 全部 | 4 | 每个分区的默认桶数量(一致性哈希的初始桶数量) |
hoodie.bucket.index.partition.expressions | 分区级 | 无 | 正则表达式与桶数量:pattern1,count1;pattern2,count2 |
hoodie.bucket.index.partition.rule.type | 分区级 | regex | 规则解析器类型 |
hoodie.bucket.index.min.num.buckets | 一致性哈希 | 无 | 最小桶数量(防止过度合并) |
hoodie.bucket.index.max.num.buckets | 一致性哈希 | 无 | 最大桶数量(防止无限扩张) |
clustering.schedule.enabled | 一致性哈希 | false | 要实现自动调整大小,必须设为 true |
clustering.plan.strategy.class | 一致性哈希 | 无 | 设置为 FlinkConsistentBucketClusteringPlanStrategy |
限流
Hudi 为写入和流式读取都提供了限流能力,用于控制数据流并防止性能下降。
写入限流
在许多场景中,用户会将历史快照数据和实时增量更新同时发布到同一个消息队列,然后使用 Flink 从最早的 offset 开始消费,将所有数据摄取到 Hudi 中。这种回填模式可能导致性能问题:
- 高突发吞吐:整个历史数据集一次性到达,海量记录将写入端压垮。
- 写入散布在表的多个分区:历史记录散布在许多不同的表分区中到达(例如表按日期分区时,记录来自大量不同的日期)。这迫使写入方不断在分区之间切换,同时保持大量文件句柄处于打开状态,造成内存压力,从而降低写入性能并导致吞吐不稳定。
write.rate.limit 选项有助于平滑摄取流程,避免流量抖动,提升回填(backfill)操作期间的稳定性。
流式读取限速
对于 Flink 流式读取,限速有助于在处理大规模负载时避免反压。read.splits.limit 选项控制每个检查间隔内允许读取的最大输入分片数。该特性在以下场景中尤为有用:
- 读取存在大量积压提交(commit)的表
- 防止下游算子被压垮
- 在追赶(catch-up)场景中控制资源消耗
平均读取速率可以这样计算:read.splits.limit / read.streaming.check-interval 个分片每秒。
Hudi 1.2.0 新增了 read.commits.limit,它与 read.splits.limit 互补,用于限制每个检查间隔内消费的提交(instants)数量。当表存在大量小提交时,这很有用——限制提交数即可约束分片数量,无论单个分片的大小如何。
选项
| 选项名称 | 是否必需 | 默认值 | 说明 |
|---|---|---|---|
write.rate.limit | false | 0 | 每秒写入记录数限流,用于防止流量抖动并提升稳定性。默认值为 0(不限流) |
read.splits.limit | false | Integer.MAX_VALUE | 流式读取时,每次 instant 检查允许读取的最大 split 数。平均读取速率 = read.splits.limit / read.streaming.check-interval。默认不限制 |
read.commits.limit | false | (无) | 每个检查间隔内允许读取的最大提交(instant)数,作为 read.splits.limit 的补充。平均速率 = read.commits.limit / read.streaming.check-interval。默认不限制 |
read.streaming.check-interval | false | 60 | 流式读取的检查间隔(秒)。默认为 60 秒(1 分钟) |
Flink Source V2
Hudi 1.2.0 引入了全新的 Flink source 实现(RFC-95),它基于 FLIP-27,可通过 read.source-v2.enabled 标志按需启用。
为什么需要 Source V2?
旧版 Hudi Flink source 基于 Flink 的 SourceFunction API 构建。FLIP-27 的重写带来了以下改进:
- 可恢复的 split 分配 — split 可以独立进行检查点保存,从而实现更细粒度的恢复
- 检查点对齐 — 新 API 参与 Flink 的协调检查点协议,提升端到端一致性
- 下推支持 — 新的 source 接口支持谓词下推、分区裁剪和
LIMIT下推,从而减少源端扫描的数据量
启用 Source V2
CREATE TABLE t1 (
  uuid VARCHAR(20) PRIMARY KEY NOT ENFORCED,
  name VARCHAR(10),
  age INT,
  ts TIMESTAMP(3),
  `partition` VARCHAR(20)
)
PARTITIONED BY (`partition`)
WITH (
  'connector' = 'hudi',
  'path' = '${path}',
  'table.type' = 'MERGE_ON_READ',
  'read.source-v2.enabled' = 'true'  -- enable the FLIP-27 source
);
选项
| 选项名称 | 是否必需 | 默认值 | 备注 |
|---|---|---|---|
read.source-v2.enabled | false | false | 是否使用 FLIP-27 新源(Source V2)来消费数据文件。默认使用旧版源 |
保存点不兼容
警告
使用旧版源(read.source-v2.enabled=false)创建的保存点与 Source V2 源不兼容,反之亦然。从旧版源切换到 Source V2 时,请启动一个全新的作业,而不要从旧版保存点恢复。如果需要保留读取进度,请记录最后提交的 instant 时间,并使用 read.start-commit 从该位置继续读取。
Flink 的记录级索引(RLI)分桶索引
从 Hudi 1.2.0 起,除了现有的 FLINK_STATE 和 BUCKET 索引类型之外,Flink 写入器还支持由元数据表支撑的记录级索引(Record-Level Index,RLI)。RLI 存储在元数据表中,避免了 FLINK_STATE 的状态后端开销,同时支持完全全局或分区范围内的唯一性保证。
通过 index.type 可以使用两种 RLI 变体:
RECORD_LEVEL_INDEX—— 分区级 RLI;针对(分区路径,记录键)组合强制唯一性GLOBAL_RECORD_LEVEL_INDEX—— 全局 RLI;在所有分区之间强制唯一性
引导初始化(Bootstrap)
在已有表上启用 RLI 时,引导初始化过程会在首次写入之前将现有的记录位置加载到 RocksDB 中。通过设置 index.bootstrap.enabled=true 可以触发引导初始化。
CREATE TABLE my_hudi_table (
  id BIGINT,
  name STRING,
  ts BIGINT,
  dt STRING,
  PRIMARY KEY (id) NOT ENFORCED
)
PARTITIONED BY (dt)
WITH (
  'connector' = 'hudi',
  'path' = 'hdfs:///warehouse/my_hudi_table',
  'table.type' = 'MERGE_ON_READ',
  'index.type' = 'RECORD_LEVEL_INDEX',
  'metadata.enabled' = 'true',
  'index.bootstrap.enabled' = 'true',  -- enable bootstrap on first run
  'index.bootstrap.rocksdb.path' = '/tmp/hudi-rli-rocksdb'
);
引导过程完成后(即首次成功检查点之后),你可以选择将作业重启并设置 index.bootstrap.enabled=false,从而跳过引导算子。保持启用也无妨——在后续运行中它们会变成空操作,不会影响写入性能。
流水线内 MDT Compaction
对于 RLI 工作负载,元数据表(MDT)会不断累积日志文件,需要定期进行 compaction。选项 metadata.compaction.async.enabled(默认为 true)会在 Flink 流水线内执行 MDT compaction,每隔 metadata.compaction.delta_commits(默认为 10)次增量提交运行一次。
选项
| 选项名称 | 必填 | 默认值 | 说明 |
|---|---|---|---|
index.type | false | FLINK_STATE | 设置为 RECORD_LEVEL_INDEX 或 GLOBAL_RECORD_LEVEL_INDEX 以使用基于元数据表的 RLI |
index.bootstrap.enabled | false | false | 首次运行时从现有表引导索引。引导期间会阻塞检查点 |
index.bootstrap.rocksdb.path | false | 系统临时目录 | RLI 引导期间 RocksDB 存储的本地路径。每个 TaskManager 会在该路径下创建唯一的子目录 |
index.rli.cache.size | false | 256 | 每个 bucket-assign 任务的 RLI 缓存最大内存(单位 MB)。会根据历史使用情况动态调整 |
index.rli.lookup.minibatch.size | false | 1000 | RLI 查找期间每个 mini-batch 缓冲的最大记录数。mini-batch 可减少单次索引查找。最小有效值为 1000 |
metadata.compaction.async.enabled | false | true | 是否在 Flink 流水线内异步运行 MDT compaction。对于 RLI 工作负载建议保持启用 |
metadata.compaction.delta_commits | false | 10 | 触发流水线内 compaction 的 MDT 增量提交次数 |
note
GLOBAL_RECORD_LEVEL_INDEX 要求 metadata.enabled=true 且 index.global.enabled=true。Flink 表工厂会自动校验这些约束。
Lookup Join
Hudi 1.2.0 为 Flink lookup join 访问 Hudi 维度表新增了基于 RocksDB 的缓存选项,可在维度表较大时避免 JVM 堆内存压力。
选项
| 选项名称 | 是否必须 | 默认值 | 说明 |
|---|---|---|---|
lookup.join.cache.type | false | heap | 联接查找(lookup join)缓存的存储后端。heap(默认)将行数据存储在 JVM 堆中;rocksdb 将行数据存储在嵌入式 RocksDB 实例的堆外内存中 |
lookup.join.rocksdb.path | false | ${java.io.tmpdir}/hudi-lookup-rocksdb | 当 lookup.join.cache.type=rocksdb 时,RocksDB 数据的本地目录。查找函数关闭时会被清理 |
lookup.async | false | false | 是否启用异步联接查找。当查找函数延迟较高时,异步联接可提高吞吐量 |
lookup.async-thread-number | false | 16 | 异步联接查找的线程数 |
示例
-- Streaming fact table with a processing-time attribute
CREATE TABLE orders (
  order_id BIGINT,
  customer_id BIGINT,
  amount DOUBLE,
  proc_time AS PROCTIME(),
  PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
  'connector' = 'hudi',
  'path' = 'hdfs:///warehouse/orders',
  'table.type' = 'MERGE_ON_READ',
  'read.streaming.enabled' = 'true'
);

-- Hudi dimension table with RocksDB-backed lookup cache
CREATE TABLE customers (
  customer_id BIGINT,
  name STRING,
  city STRING,
  PRIMARY KEY (customer_id) NOT ENFORCED
) WITH (
  'connector' = 'hudi',
  'path' = 'hdfs:///warehouse/customers',
  'lookup.join.cache.type' = 'rocksdb',
  'lookup.join.rocksdb.path' = '/tmp/hudi-lookup-rocksdb'
);

-- Lookup join keyed by the fact table's processing-time attribute
SELECT o.order_id, c.name, o.amount
FROM orders AS o
JOIN customers FOR SYSTEM_TIME AS OF o.proc_time AS c
  ON o.customer_id = c.customer_id;
虚拟元数据列
Hudi 元数据字段可以在 Flink DDL 中声明为 METADATA VIRTUAL 列。这样可以在不将系统元数据(例如提交时间、记录键)存储为常规数据列的情况下访问这些字段。
CREATE TABLE events (
  event_id BIGINT,
  payload STRING,
  -- virtual metadata columns (read-only, not persisted as data)
  _hoodie_commit_time     STRING METADATA VIRTUAL,
  _hoodie_record_key      STRING METADATA VIRTUAL,
  _hoodie_partition_path  STRING METADATA VIRTUAL,
  PRIMARY KEY (event_id) NOT ENFORCED
)
WITH (
  'connector' = 'hudi',
  'path' = 'hdfs:///warehouse/events'
);

-- Query metadata alongside data
SELECT event_id, _hoodie_commit_time, payload FROM events;
note
仅支持 VIRTUAL 元数据列。所有有效的虚拟列都对应 Hudi 的内置元字段(_hoodie_commit_time、_hoodie_commit_seqno、_hoodie_record_key、_hoodie_partition_path、_hoodie_file_name、_hoodie_operation)。
各引擎的类型约束
新列类型(VECTOR、BLOB、VARIANT)在 Flink 中的行为与 Spark 在几个方面有所不同:
VECTOR 列以 Parquet FIXED_LEN_BYTE_ARRAY 形式存储,而 Flink 的 Parquet 读取器不会将其转换回带类型的数组。同一张表的其他列读取正常,只有 VECTOR 列本身在 Flink 中无法访问。请使用 Spark 查询 VECTOR 列。
原生 VARIANT 操作需要 Flink 2.1 及以上版本。Flink 低于 2.1 时访问 VARIANT 列会抛出 UnsupportedOperationException。在 Flink 2.1 及以上版本中,VARIANT 列表现为 ROW<metadata BYTES, value BYTES>。Flink 可以读取底层的 struct,但无法将其解码为 variant 值。
read_blob() 是 Spark SQL 函数。在 Flink 中,对 BLOB 列的查询会直接返回底层的 struct。
Lance 基础文件格式仅支持 Spark。在 Flink 中读取基于 Lance 的表会抛出 HoodieValidationException;参见存储布局 → Lance。
高级选项
Hadoop 配置透传
可以使用 properties.hadoop.* 前缀(或直接使用 hadoop.*)将 Hadoop 文件系统配置属性传递给 Flink 写入器。
WITH (
  'connector' = 'hudi',
  'path' = 's3a://my-bucket/my-table',
  'properties.hadoop.fs.s3a.access.key' = 'AKID...',
  'properties.hadoop.fs.s3a.secret.key' = '...'
)
Kafka Offset 追踪
对于高级 Kafka offset 追踪(内部/可选功能),以下 kafka.offset.trace.* 选项用于配置在某些部署环境中所使用的基于检查点服务(checkpoint-service)的 offset 查找机制。这些属于高级选项,对标准的 Hudi 写入没有功能影响:
| 选项名称 | 默认值 | 说明 |
|---|---|---|
kafka.offset.trace.caller.service.name | ingestion-rt | 检查点服务 RPC 请求头中的调用方服务名称 |
kafka.offset.trace.checkpoint.service | athena-job-manager | 检查点服务名称 |
kafka.offset.trace.dc | (none) | 用于检查点 offset 查找的数据中心 |
kafka.offset.trace.env | (none) | 用于检查点 offset 查找的环境 |
kafka.offset.trace.job.name | (none) | 用于检查点 offset 查找的 Flink 作业名称 |
评论
登录后参与评论