 KnowForge
时间线
 师成· 更新于 2026-09-29· 阅读 16 分钟· 0 次阅读
表状态的变更(写入、表服务、模式变更等)会作为 动作(actions) 记录在 Hudi 时间线(timeline) 中。Hudi 时间线是记录表在不同 即时点(instants,即时间点) 上所执行全部动作的日志。它是 Hudi 架构中的关键组件,充当表状态的事实来源。时间线上使用的所有即时时间均遵循 TrueTime 语义,并在涉及的各个进程之间全局单调递增。有关更多细节,请参见下文的 TrueTime 一节。
每个动作都具有以下相关属性。
- requested instant(请求即时时间):表示该动作在时间线上被请求的即时时间,并充当事务 ID。在请求该动作之前,应先生成该动作的不可变计划。
- completed instant(完成即时时间):表示该动作在时间线上完成的即时时间。在动作完成之前,应对表数据/元数据做出所有相关变更。
- state(状态):动作的状态。在一个动作的生命周期中,有效状态包括
REQUESTED、INFLIGHT和COMPLETED。 - type(类型):所执行动作的种类。完整的动作列表见下文。
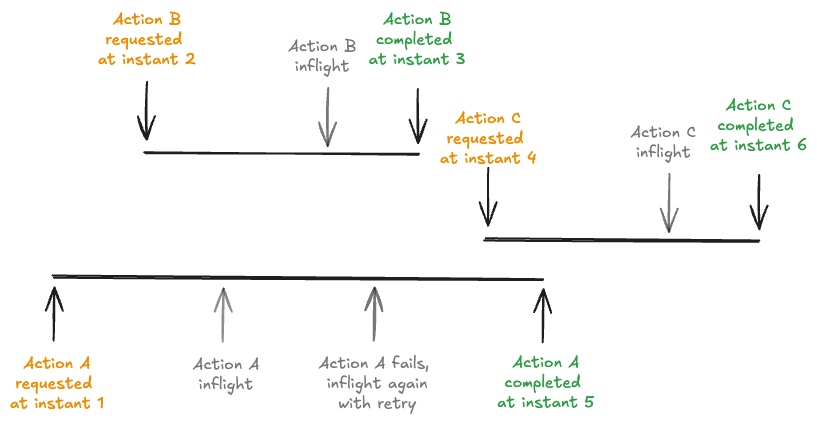
图:时间线中的动作
动作类型
以下是有效的动作类型。
- COMMIT - 写操作,表示将一批记录原子性地写入表中的基础文件(base files)。
- DELTA_COMMIT - 写操作,表示将一批记录原子性地写入合并读(merge-on-read)类型的表,其中部分或全部数据可能只写入增量日志(delta logs)。
- REPLACE_COMMIT - 写操作,以原子方式用另一组文件组替换表中的一组文件组。用于实现 insert_overwrite、delete_partition 等批量写操作,以及聚类(clustering)等表服务。
- CLEANS - 表服务,通过删除文件的方式,从表中移除不再需要的较旧文件切片(file slices)。
- COMPACTION - 表服务,通过将增量文件(delta files)合并到基础文件中,来调和基础文件与增量文件之间的数据差异。
- LOGCOMPACTION - 表服务,将同一文件切片中的多个小日志文件合并为一个更大的日志文件。参见日志压缩。
- CLUSTERING - 表服务,以优化后的排序顺序或存储布局重写现有的文件组,生成表中的新文件组。
- INDEXING - 表服务,在表的某一列上构建指定类型的索引;在持续写入的情况下,索引与该完成瞬时(instant)时的表状态保持一致。
- ROLLBACK - 表示一次未成功的写操作已被回滚,将该次写操作期间产生的所有部分写入/未提交文件从存储中移除。
- SAVEPOINT - 将某些文件切片标记为“已保存”,使清理器(cleaner)不会删除它们。它有助于在灾难/数据恢复场景下将表恢复到时间线上的某个点,或针对这些瞬时执行时间旅行查询。
- RESTORE - 在灾难/数据恢复场景下,将表恢复到时间线上给定的保存点(savepoint)。
在某些情况下,已完成(completed)状态下的动作类型可能与请求(requested)/进行中(inflight)状态不同,但仍由同一个请求瞬时(requested instant)来跟踪。例如,CLUSTERING 在请求/进行中状态下,在已完成状态下变为 REPLACE_COMMIT。压缩(Compaction)在时间线上以 COMMIT 动作完成,并生成新的基础文件。通常,来自存储引擎的多个写操作可能映射到时间线上的同一个动作。
状态转换
动作在时间线上经历状态转换,每次转换都由符合 <requested instant>.<action>.<state> 模式(针对其他状态)或 <requested instant>_<completed instant>.<action> 模式(针对 COMPLETED 状态)的文件记录。Hudi 保证状态转换是原子的,并且基于瞬时时间保持时间线一致性。原子性通过依赖底层存储的原子操作来实现(例如对 S3/云存储的 PUT 调用)。
有效的状态转换如下:
[ ] -> REQUESTED— 表示一个操作已被调度,但尚未由任何进程启动。请注意,请求该操作的进程可能不同于执行/完成该操作的进程。REQUESTED -> INFLIGHT— 表示该操作正由某个进程执行中。INFLIGHT -> REQUESTED或INFLIGHT -> INFLIGHT— 进程在执行该操作的过程中可以安全地失败多次。INFLIGHT -> COMPLETED— 表示该操作已成功完成。
时间线上某个操作的当前状态是该操作在时间线上记录到的最高状态,状态的排序为 REQUESTED < INFLIGHT < COMPLETED。
TrueTime 生成机制
分布式系统中的时间问题已经被研究了数十年。Google Spanner 的 TrueTime API 通过提供一个具有不确定性上界的全局同步时钟,来应对分布式系统中的时间管理挑战。传统系统在时钟漂移和缺乏统一时间线方面举步维艰,而 TrueTime 确保所有节点基于一个共同的时间概念运作,该概念由一个严格的不确定性区间来定义。这使得 Spanner 能够在分布式事务中实现外部一致性,使其能够放心地分配时间戳,确信过去或将来的任何其他操作都不会与之冲突,从而解决了时钟同步与因果关系这一由来已久的问题。Spanner、CockroachDB 等多个 OLTP 数据库都依赖于 TrueTime。
Hudi 在时间线的即时时间(instant time)上采用了这些语义,以提供唯一的、单调递增的即时值。TrueTime 可以由一个共享的时间生成器进程生成,也可以让每个进程各自生成时间,并在分布式锁内等待时间 >= 所有进程中最大预期时钟漂移量。加锁确保同一时刻只有一个进程在生成时间,而等待则确保经过足够的时间,从而保证新生成的时间必然大于之前的时间。
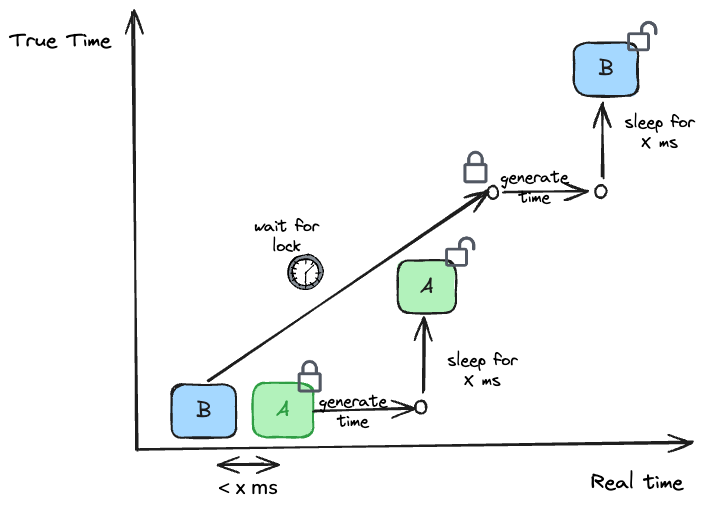
图:进程 A 和 B 的 TrueTime 生成过程
上图展示了进程 A 和 B 生成的时间是如何单调递增的:尽管进程 B 在开始时的本地时钟低于 A,但通过等待 x 毫秒的不确定性窗口过去后,两者的时间仍然保持单调递增。
事实上,鉴于 Hudi 面向的事务持续时间大于 1 秒,我们可以承受高得多的不确定性上界(大于 100 毫秒),从而保证极高精度的时间生成。
操作的排序
因此,操作在时间线上表现为一个区间,起始于被请求的时刻,结束于完成的时刻。这类操作可以按完成时间排序,以便
- 提交时间排序(Commit time ordering):为了获得与典型关系数据库一致的、可序列化的写入执行顺序,可以按照完成实例(completed instant)对动作进行排序。
- 事件时间排序(Event time ordering):数据湖仓最终处理的是数据流(CDC、事件、缓慢变化数据等),其顺序取决于数据中的业务字段。在这种情况下,可以按照提交时间对动作进行排序,而记录本身则按照指定的事件时间字段进一步合并。
Hudi 依赖于将某些动作的请求实例(requested instants)与其它动作的完成实例(completed instants)进行排序,以实现非阻塞的表服务操作,或支持带事件时间排序的并发流式模型写入。
时间线组件
活跃时间线(Active Timeline)
Hudi 在 .hoodie/timeline 目录下以日志结构合并(LSM)树的形式实现时间线。与典型的 LSM 实现不同,Hudi 将内存组件和预写日志一并替换为 avro 序列化文件,其中包含各个动作(即 活跃时间线),从而获得更高的持久性和跨进程协调能力。Hudi 表上的所有动作都会在活跃时间线中创建一个新条目,并且会周期性地将动作从活跃时间线归档到 LSM 结构(时间线历史)中。顾名思义,活跃时间线始终被查询以构建一致的数据视图;而对已完成动作进行归档,则可确保随着时间线增长,时间线上的读取不会产生不必要的延迟。此类归档的关键不变条件是:在归档之前,任何来自已完成/待处理动作的副作用(例如未提交的文件)都必须先从存储中清除。
LSM 时间线历史
如上所述,活跃时间线的日志历史有限,以保证其快速;而归档后的时间线在读取或写入时访问代价较高,尤其是在高写入吞吐量的情况下。为克服这一局限,Hudi 引入了基于 LSM(日志结构合并)树的时间线。已完成的动作、其执行计划以及完成元数据,被存储在可扩展性更强的、基于 LSM 树的归档时间线中;该时间线以 history 存储文件夹的形式组织在 .hoodie/timeline 元数据路径下。它由包含动作实例数据的 Apache Parquet 文件和用于记账的元数据文件组成,组织方式如下。
/.hoodie/timeline/history/
├── _version_      					        <-- stores the manifest version that is current
├── manifest_1                              <-- manifests store list of files in timeline
├── manifest_2                              <-- compactions, cleaning, writes produce new manifest files
├── ...
├── manifest_<N>                            <-- there can be many manifest files at any given time
├── <min_time>_<max_time>_<level>.parquet   <-- files storing actual action details
关于 LSM 时间线的更多细节可以参阅 Hudi 1.0 规范。为了更好地理解它,下面给出一个示例。
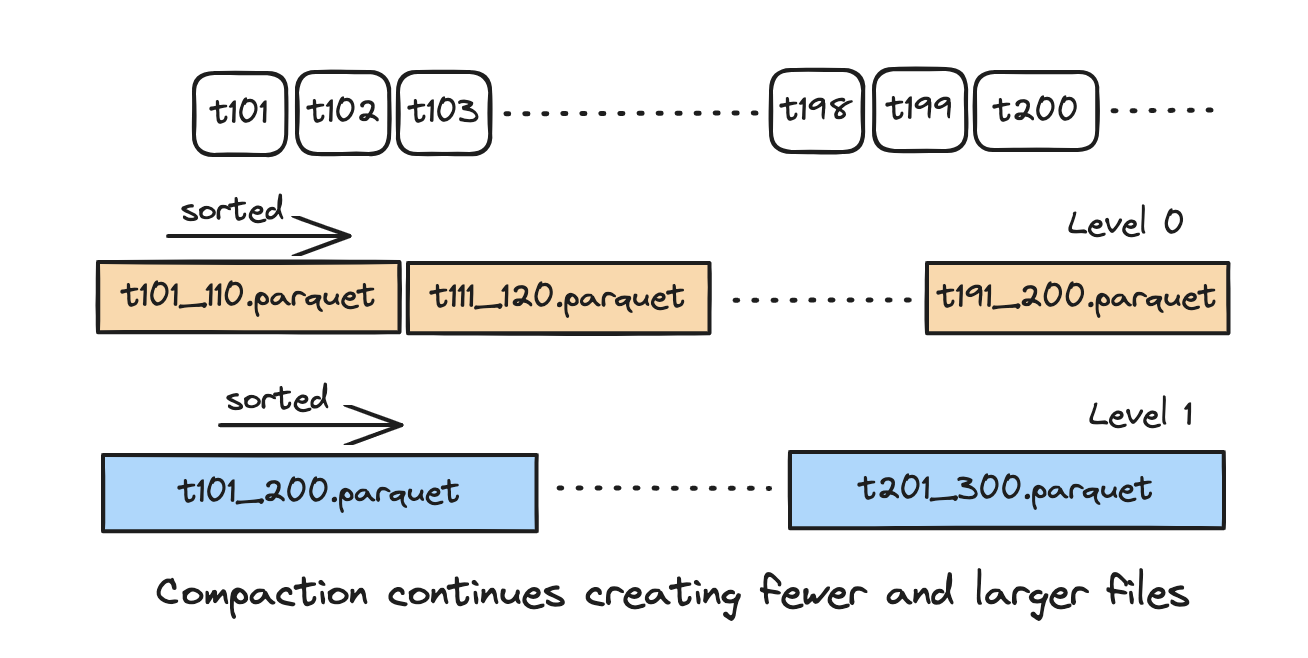
在上图中,每一层都是一个按即时时间(instant time)排序的树。我们可以看到,一批提交的元数据被存储在一个 parquet 文件中。随着更多提交的不断累积,它们会被压缩并下沉到树的更底层。对时间线的每次新操作都会产生一个新的快照版本。这种结构的优势在于,我们可以按需将顶层保留在内存中,同时在需要回溯更长的历史时,仍能高效地从磁盘加载其余各层。LSM 时间线的压缩频率由 hoodie.timeline.compaction.batch.size 控制,即当前层级中每积累 N 个 parquet 文件,它们就会被合并并作为一个压缩文件刷新到下一层级。
时间线归档配置
控制归档的基础配置。
Spark 配置
| 配置名称 | 默认值 | 描述 |
|---|---|---|
| hoodie.keep.max.commits | 30(可选) | 归档服务在每次写入后将时间线中较旧的条目移动到归档日志中,从而在表规模不断增长的同时保持元数据开销恒定。此配置控制活跃时间线中保留的最大即时时间数量。 |
| hoodie.keep.min.commits | 20(可选) | 与 hoodie.keep.max.commits 类似,但控制活跃时间线中保留的最小即时时间数量。 |
| hoodie.timeline.compaction.batch.size | 10(可选) | 控制在 LSM 树当前层级上单次压缩运行中要压缩的 parquet 文件数量。 |
更多高级配置请参考此处。
Flink 选项
使用 SQL 的 Flink 作业可以通过 WITH 子句中的选项进行配置。实际的数据源级别配置如下所列。
配置名称默认值描述
archive.max_commits50(可选)在将较旧的提交归档到顺序日志之前保留的最大提交数,默认为 50
Config Param: ARCHIVE_MAX_COMMITS
archive.min_commits40(可选)在将较旧的提交归档到顺序日志之前需要保留的最少提交数,默认为 40
Config Param: ARCHIVE_MIN_COMMITS
hoodie.timeline.compaction.batch.size10(可选)控制在 LSM 树当前层级的一次压缩(compaction)运行中需要压缩的 parquet 文件数量。
更多详情请参阅此处。
博客
评论
登录后参与评论