 KnowForge
SQL 查询
 师成· 更新于 2026-09-29· 阅读 75 分钟· 0 次阅读
Hudi 将数据存储并组织在存储层上,同时提供多种查询方式,可与众多查询引擎配合使用。本页将介绍如何发起不同的查询,并讨论各查询引擎的相关注意事项。
Spark SQL
Spark 快速入门指南很好地概述了如何使用 Spark SQL 查询 Hudi 表。本节将介绍更高级的配置与功能。
在会话级别设置 Hudi 读取选项
Hudi 1.2.0 支持使用 spark.hoodie.* 前缀在 Spark 会话级别设置读取选项。通过 spark.conf.set 或 --conf 设置的任何 spark.hoodie.X 配置,都会被视为等同于 hoodie.X。
配置优先级(低 → 高):
- 全局 DFS 属性
spark.hoodie.*会话级配置(规范化为hoodie.*)- 显式的
hoodie.*数据源选项或按表执行的SET命令
-- Apply a Hudi read option for the entire session
SET spark.hoodie.metadata.column.stats.enable = true;
SELECT * FROM hudi_table WHERE price BETWEEN 10.0 AND 50.0;
如果同时设置了 spark.hoodie.X 和 hoodie.X,则显式的 hoodie.X 值优先。
快照查询
快照查询是 Hudi 表最常见的查询类型。Spark SQL 支持对 COPY_ON_WRITE 和 MERGE_ON_READ 表执行快照查询。通过会话属性,可以指定与索引相关的选项以优化查询性能,如下所示。
-- You can turn on relevant options for indexing.

-- Turn on use of column stat index, to perform range queries.
SET hoodie.metadata.column.stats.enable=true;
SELECT * FROM hudi_table
WHERE price > 1.0 and price < 10.0

-- Turn on use of record level index, to perform point queries.
SET hoodie.metadata.record.index.enable=true;
SELECT * FROM hudi_table
WHERE uuid = 'c8abbe79-8d89-47ea-b4ce-4d224bae5bfa'
与 Spark 集成
为了获得最佳的 Spark 使用体验,建议用户迁移到 Hudi 0.12.x 以上版本,并不建议再使用任何基于路径过滤的旧方式。我们预计,在这些版本中,借助 Spark 优化的原生表读取器与 Hudi 的自动表管理相结合,将带来显著的性能提升。
使用索引加速的快照查询
本节将介绍 Hudi 中的各种索引,以及它们如何帮助实现数据跳过。我们首先创建一个不带任何索引的 Hudi 表。
-- Create a table with primary key
CREATE TABLE hudi_indexed_table (
    ts BIGINT,
    uuid STRING,
    rider STRING,
    driver STRING,
    fare DOUBLE,
    city STRING
) USING HUDI
options(
    primaryKey ='uuid',
    hoodie.write.record.merge.mode = "COMMIT_TIME_ORDERING"
)
PARTITIONED BY (city);

INSERT INTO hudi_indexed_table
VALUES
(1695159649,'334e26e9-8355-45cc-97c6-c31daf0df330','rider-A','driver-K',19.10,'san_francisco'),
(1695091554,'e96c4396-3fad-413a-a942-4cb36106d721','rider-C','driver-M',27.70 ,'san_francisco'),
(1695046462,'9909a8b1-2d15-4d3d-8ec9-efc48c536a00','rider-D','driver-L',33.90 ,'san_francisco'),
(1695332066,'1dced545-862b-4ceb-8b43-d2a568f6616b','rider-E','driver-O',93.50,'san_francisco'),
(1695516137,'e3cf430c-889d-4015-bc98-59bdce1e530c','rider-F','driver-P',34.15,'sao_paulo'    ),
(1695376420,'7a84095f-737f-40bc-b62f-6b69664712d2','rider-G','driver-Q',43.40 ,'sao_paulo'    ),
(1695173887,'3eeb61f7-c2b0-4636-99bd-5d7a5a1d2c04','rider-I','driver-S',41.06 ,'chennai'      ),
(1695115999,'c8abbe79-8d89-47ea-b4ce-4d224bae5bfa','rider-J','driver-T',17.85,'chennai');
UPDATE hudi_indexed_table SET rider = 'rider-B', driver = 'driver-N', ts = '1697516137' WHERE rider = 'rider-A';
运行下面的查询,可以看到没有任何数据跳过或裁剪,因为该表尚未创建索引(如下图所示)。系统会扫描表中的所有文件来获取数据。现在我们在 rider 列上创建一个二级索引。
SHOW INDEXES FROM hudi_indexed_table;
SELECT * FROM hudi_indexed_table WHERE rider = 'rider-B';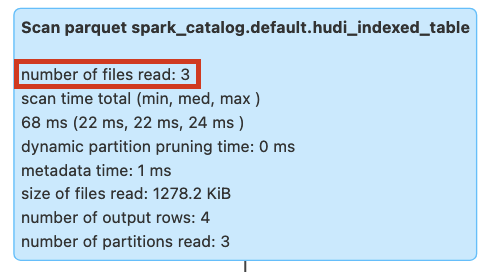
图:无二级索引时的查询剪枝
使用二级索引进行查询
在 rider 列上创建二级索引后,我们将再次运行该查询。此时查询显示扫描的文件数为 1,而在没有索引的情况下扫描了 3 个文件。
note
请注意,创建二级索引需要满足以下条件:
- 表必须具有主键,且合并模式应为 COMMIT_TIME_ORDERING。
- 必须启用记录索引(record index)。可以通过设置
hoodie.metadata.record.index.enable=true并随后创建record_index来实现。请参见下方示例。
-- We will first create a record index since secondary index is dependent upon it
CREATE INDEX record_index ON hudi_indexed_table (uuid);
-- We create a secondary index on rider column
CREATE INDEX idx_rider ON hudi_indexed_table (rider);
-- We run the same query again
SELECT * FROM hudi_indexed_table WHERE rider = 'rider-B';
DROP INDEX record_index on hudi_indexed_table;
DROP INDEX secondary_index_idx_rider on hudi_indexed_table;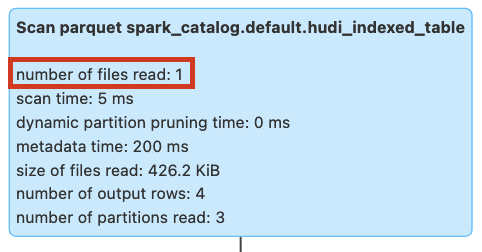
图:使用二级索引进行查询裁剪
使用布隆过滤器表达式索引进行查询
执行下面的查询,由于 driver 列上尚未创建索引,因此不会发生任何数据跳过或裁剪。表中的所有文件都会被扫描以获取数据。
SHOW INDEXES FROM hudi_indexed_table;
SELECT * FROM hudi_indexed_table WHERE driver = 'driver-N';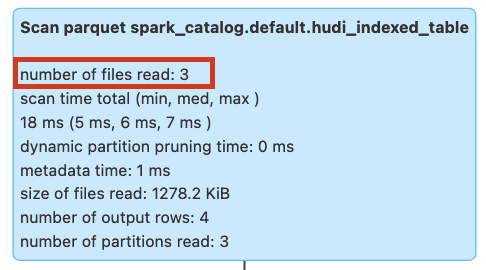
图:没有布隆过滤器表达式索引时的查询裁剪
在 rider 列上创建布隆过滤器表达式索引后,我们将再次运行该查询。此时查询扫描的文件数将显示为 1,而在没有索引的情况下需要扫描 3 个文件。
-- We create a bloom filter expression index on driver column
CREATE INDEX idx_bloom_driver ON hudi_indexed_table USING bloom_filters(driver) OPTIONS(expr='identity');
-- We run the same query again
SELECT * FROM hudi_indexed_table WHERE driver = 'driver-N';
DROP INDEX expr_index_idx_bloom_driver on hudi_indexed_table;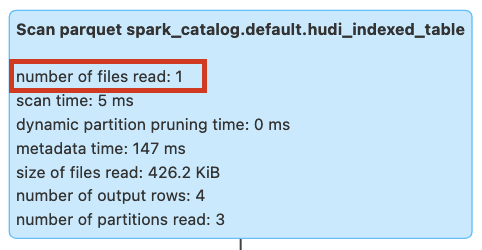
图:使用布隆过滤器表达式索引进行查询剪枝
使用列统计信息表达式索引进行查询
执行以下查询时,由于表中尚未创建任何索引,我们将看不到任何数据跳过或剪枝,如上图所示。表中的所有文件都会被扫描以获取数据。
SHOW INDEXES FROM hudi_indexed_table;
SELECT uuid, rider FROM hudi_indexed_table WHERE from_unixtime(ts, 'yyyy-MM-dd') = '2023-10-17';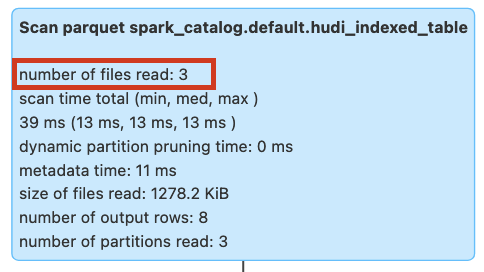
图:没有列统计表达式索引时的查询剪枝
在 ts 列上创建列统计表达式索引后,我们将再次运行该查询。此时查询显示扫描的文件数为 1,而未建立索引时扫描的文件数为 3。
-- We create a column stat expression index on ts column
CREATE INDEX idx_column_ts ON hudi_indexed_table USING column_stats(ts) OPTIONS(expr='from_unixtime', format = 'yyyy-MM-dd');
-- We run the same query again
SELECT uuid, rider FROM hudi_indexed_table WHERE from_unixtime(ts, 'yyyy-MM-dd') = '2023-10-17';
DROP INDEX expr_index_idx_column_ts on hudi_indexed_table;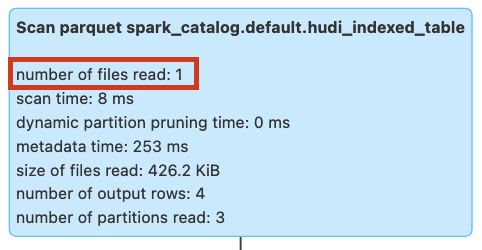
图:使用列统计表达式索引进行查询裁剪
使用分区统计索引进行查询
运行下面的查询时,我们不会看到任何数据跳过或裁剪,因为该表中尚未创建分区统计索引,这一点可以从下图中看出。表中的所有分区都会被扫描以获取数据。
SHOW INDEXES FROM hudi_indexed_table;
SELECT * FROM hudi_indexed_table WHERE rider >= 'rider-H';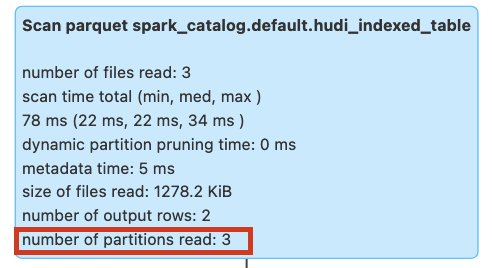
图:未使用分区统计索引时的查询裁剪
在创建分区统计索引后,我们将再次运行该查询。此时查询显示的扫描分区数为 1,而不使用索引时扫描的分区数为 3。
-- We will need to enable column stats as well since partition stats index leverages it
SET hoodie.metadata.index.partition.stats.enable=true;
SET hoodie.metadata.index.column.stats.enable=true;
INSERT INTO hudi_indexed_table
VALUES
(1695159649,'854g46e0-8355-45cc-97c6-c31daf0df330','rider-H','driver-T',19.10,'chennai');
-- Run the query again on the table with partition stats index
SELECT * FROM hudi_indexed_table WHERE rider >= 'rider-H';
DROP INDEX column_stats on hudi_indexed_table;
DROP INDEX partition_stats on hudi_indexed_table;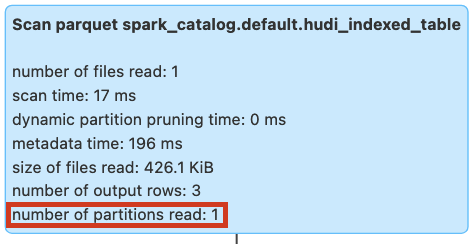
图:使用分区统计索引进行查询裁剪
基于事件时间排序的快照查询
Hudi 支持不同的记录合并模式来合并来自同一键的记录。事件时间排序是其中一种合并模式,它基于事件时间来合并记录。下面我们创建一个使用事件时间排序合并模式的表。
CREATE TABLE IF NOT EXISTS hudi_table_merge_mode (
  id INT,
  name STRING,
  ts LONG,
  price DOUBLE
) USING hudi
TBLPROPERTIES (
  type = 'mor',
  primaryKey = 'id',
  orderingFields = 'ts',
  recordMergeMode = 'EVENT_TIME_ORDERING'
)
LOCATION 'file:///tmp/hudi_table_merge_mode/';

-- insert a record
INSERT INTO hudi_table_merge_mode VALUES (1, 'a1', 1000, 10.0);

-- another record with the same key but lower ts
INSERT INTO hudi_table_merge_mode VALUES (1, 'a1', 900, 20.0);

-- query the table, result should be id=1, name=a1, ts=1000, price=10.0
SELECT id, name, ts, price FROM hudi_table_merge_mode;
使用 EVENT_TIME_ORDERING 时,事件时间较大(通过 orderingFields 指定)的记录会覆盖相同键上事件时间较小的记录,而与事务时间无关。
自定义合并模式的快照查询
用户可以设置 CUSTOM 模式来提供自己的合并逻辑。使用 CUSTOM 合并模式时,还需要提供实现了合并逻辑的 payload 类。例如,可以使用 PartialUpdateAvroPayload 按如下方式合并记录。
CREATE TABLE IF NOT EXISTS hudi_table_merge_mode_custom (
  id INT,
  name STRING,
  ts LONG,
  price DOUBLE
) USING hudi
TBLPROPERTIES (
  type = 'mor',
  primaryKey = 'id',
  orderingFields = 'ts',
  recordMergeMode = 'CUSTOM',
  'hoodie.datasource.write.payload.class' = 'org.apache.hudi.common.model.PartialUpdateAvroPayload'
)
LOCATION 'file:///tmp/hudi_table_merge_mode_custom/';

-- insert a record
INSERT INTO hudi_table_merge_mode_custom VALUES (1, 'a1', 1000, 10.0);

-- another record with the same key but set higher ts and name as null to show partial update
INSERT INTO hudi_table_merge_mode_custom VALUES (1, null, 2000, 20.0);

-- query the table, result should be id=1, name=a1, ts=2000, price=20.0
SELECT id, name, ts, price FROM hudi_table_merge_mode_custom;如你所见,不仅排序字段值更高的记录会覆盖排序值更低的记录,name 字段也会被部分更新。
时间旅行查询
你还可以使用 AS OF 语法查询特定提交时间点的表数据。这在调试和审计场景中非常有用,也适用于希望在特定时间点上训练模型的机器学习管道。
SELECT * FROM <table name>
TIMESTAMP AS OF '<timestamp in yyyy-MM-dd HH:mm:ss.SSS or yyyy-MM-dd or yyyyMMddHHmmssSSS>'
WHERE <filter conditions>
变更数据捕获
当你希望获取 Hudi 表在给定时间窗口内的所有变更(包括变更记录的前镜像/后镜像以及变更操作类型)时,变更数据捕获(Change Data Capture,CDC)查询非常有用。与许多关系数据库的同类功能类似,Hudi 提供了灵活的方式来控制补充日志级别,通过 hoodie.table.cdc.supplemental.logging.mode 配置项,在物化更多数据以降低实时计算变更的计算成本之间进行权衡,从而平衡存储/日志成本与计算成本。
-- Supported through the hudi_table_changes TVF
SELECT *
FROM hudi_table_changes(
  <pathToTable | tableName>,
  'cdc',
  <'earliest' | <time to capture from>>
  [, <time to capture to>]
)
关于 0.x 到 1.x 检查点转换的说明(在下方的增量查询中同样适用)
Hudi 0.x 与 1.x 之间 CDC 查询的检查点
在 Hudi 1.0 中,增量查询和 CDC 查询改用完成时间(completion time)而非请求实例时间(requested instant time)来确定需要增量拉取的提交范围。Hudi 增量源及相关源所存储的检查点也随之改为使用完成时间。为了实现无需停机、也不会产生数据重复的平滑迁移,Hudi 会根据源表的版本,自动将检查点从请求实例时间转换为完成时间。
增量查询
当您希望获取某个给定提交时间之后所有已变更记录的最新值时,增量查询非常有用。它只处理发生变化的记录,从而帮助构建增量数据管道,效率比批处理方式高出几个数量级。Hudi 用户正是通过这种方式使用增量查询,在查询效率上取得了大幅提升。Hudi 在 COPY_ON_WRITE 和 MERGE_ON_READ 两种表上都支持增量查询。
-- Supported through the hudi_table_changes TVF
SELECT *
FROM hudi_table_changes(
  <pathToTable | tableName>,
  'latest_state',
  <'earliest' | <time to capture from>>
  [, <time to capture to>]
)
增量查询与 CDC 查询
增量查询的查询效率甚至优于上述 CDC 查询,因为它将压缩(compaction)的成本分摊到了整个数据湖上。例如,某张表在一个时间窗口内对 100 万条记录共产生了 1000 万次修改,增量查询可以借助 Hudi 的记录级元数据直接获取这 100 万条记录的最新值。另一方面,CDC 查询会处理这 1000 万条记录,它适用于需要查看某个时间窗口内的全部变更、而不仅仅是最新值的场景。
请参阅配置章节,了解重要的配置选项。
Hudi 0.x 与 1.0 之间的增量查询检查点(Checkpoint)
在 Hudi 1.0 中,增量查询和 CDC 查询改用完成时间(completion time)而非即时时间(instant time)来确定需要增量拉取的提交范围。Hudi 增量数据源及相关数据源所存储的检查点也改为使用完成时间。为保证兼容性,Hudi 会根据源表版本,将检查点从请求的即时时间转换为完成时间。
向量相似性搜索
hudi_vector_search 表值函数(TVF)会对 VECTOR 列执行 Top-K 相似性搜索。它会在所选的距离度量下,返回 VECTOR 列与查询向量最接近的 top_k 行。
SELECT *
FROM hudi_vector_search(
    table_name,        -- STRING: registered table name or path
    vector_column,     -- STRING: VECTOR column name
    query_vector,      -- ARRAY: query embedding
    top_k,             -- INT: number of nearest neighbors
    [distance_metric], -- STRING: 'cosine' (default), 'l2', 'dot_product'
    [algorithm]        -- STRING: 'brute_force' (default)
)
参数:
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
table_name | STRING | (必填) | 已注册的表名或表路径。 |
vector_column | STRING | (必填) | VECTOR 列的名称。 |
query_vector | ARRAY<FLOAT> | (必填) | 查询向量;必须与该列的维度和元素类型匹配。 |
top_k | INT | (必填) | 最近邻的数量。 |
distance_metric | STRING | 'cosine' | 取值为 'cosine'、'l2'、'dot_product' 之一。 |
algorithm | STRING | 'brute_force' | 当前仅支持 'brute_force'。 |
返回模式:源表的所有列(不包括嵌入列)外加 _hudi_distance DOUBLE。结果按 _hudi_distance 升序排列,因此最匹配的结果排在最前。
距离度量:
| 度量 | 公式 | 取值范围 | 说明 |
|---|---|---|---|
cosine | 1 − cos(a, b),截断到 [0, 2] | [0, 2] | 零向量返回 1.0。 |
l2 | sqrt(sum((a[i] − b[i])²)) | [0, +∞) | |
dot_product | −(a · b) | (−∞, +∞) | 取负值,以便升序排序时最相似的行排在最前。 |
-- Find the 10 nearest neighbors to a query embedding
SELECT product_id, name, _hudi_distance
FROM hudi_vector_search('products', 'embedding',
                        ARRAY(0.12, -0.03, 0.87, /* ... */),
                        10, 'cosine')
ORDER BY _hudi_distance;
RAG 上下文检索,以便应用距离阈值来丢弃弱匹配:
-- Retrieve the 5 most relevant document chunks for an LLM prompt
SELECT chunk_id, text_content, _hudi_distance
FROM hudi_vector_search(
    'document_chunks', 'embedding',
    ARRAY(/* embedding of the user's question */),
    5, 'cosine'
)
WHERE _hudi_distance < 0.3;
跨模态搜索:使用文本嵌入(例如 CLIP)检索图像嵌入语料库:
SELECT image_id, caption, _hudi_distance
FROM hudi_vector_search(
    'image_catalog', 'clip_embedding',
    ARRAY(/* text embedding from CLIP */),
    20, 'cosine'
);
该 TVF 同样适用于以 Lance 为存储的表。在建表时设置 hoodie.table.base.file.format=lance(参见存储布局 → Lance);调用方式保持不变。
note
cosine 距离计算的是 1 − cos(a, b)。如果向量在写入前未进行 L2 归一化,结果将同时受向量方向和模长影响。
hudi_vector_search_batch
批量变体可一次运行多个查询向量:
SELECT *
FROM hudi_vector_search_batch(
    corpus_table,           -- STRING
    corpus_embedding_col,   -- STRING
    query_table,            -- STRING: table holding query vectors
    query_embedding_col,    -- STRING: VECTOR column in query table
    top_k,                  -- INT: neighbors per query
    [distance_metric],
    [algorithm]
)
返回 schema:语料列 + 查询列 + _hudi_distance DOUBLE + _hudi_query_index LONG(标识产生该行的查询)。如果语料与查询存在同名列,查询列会加上 _hudi_query_ 前缀。
读取 BLOB 列
read_blob() SQL 函数用于从 BLOB 列中物化原始字节。它对两种存储模式的处理是一致的:对于 INLINE,提取内嵌的字节;对于 OUT_OF_LINE,则从 reference.external_path 中的 reference.offset 位置开始读取 reference.length 个字节。
SELECT asset_id, read_blob(content) AS raw_bytes
FROM media_assets
WHERE asset_id = 'asset_001';
对 BLOB 列执行标准查询时,返回的是底层的结构体(描述符 + 字节),而非原始字节:
SELECT asset_id, content.type, content.reference.external_path
FROM media_assets;
内联读取模式
| 属性 | 默认值 | 说明 |
|---|---|---|
hoodie.read.blob.inline.mode | DESCRIPTOR | 控制 INLINE BLOB 在读取时的呈现方式。DESCRIPTOR(默认)会返回一个脱机式(out-of-line)的引用,指向字节在文件内的坐标,不会物化任何字节。CONTENT 则会在每次读取时,将原始内联字节物化到 data 字段中。 |
hoodie.blob.batching.max.gap.bytes | 4096 | 相邻字节范围在被合并为单次读取之前允许的最大间隔。取值越大,可减少 I/O 调用次数,但代价是会读取到一些未使用的字节。 |
hoodie.blob.batching.lookahead.size | 50 | 用于批量读取检测的缓冲行数。取值越大,对有序数据的批处理效果越好,但内存占用也会增加。 |
无论此设置如何,内部操作(压缩、合并、日志回放)始终使用 CONTENT 模式。
在 DESCRIPTOR 模式下调用 INLINE 列的 read_blob()
在默认的 DESCRIPTOR 模式下,对 INLINE BLOB 列调用 read_blob() 会抛出异常。因为扫描阶段不会物化原始字节,read_blob() 没有内容可以返回。若要使用 read_blob() 读取内联字节,请先切换到 CONTENT 模式:
SET hoodie.read.blob.inline.mode=CONTENT;
SELECT asset_id, read_blob(content) AS raw_bytes
FROM media_assets WHERE asset_id = 'asset_001';
此设置仅影响 INLINE 列;OUT_OF_LINE 始终从外部路径获取。
read_blob() 是一个 Spark SQL 函数;Hive、BigQuery 及其他直接读取底层 struct 的引擎并不提供该函数。请在调用 read_blob() 之前应用谓词,以限制每行解析的字节数。
查询 VARIANT 列
VARIANT 列保存半结构化(类 JSON)数据。若需输出 JSON,请强制转换为 STRING:
SELECT event_id, cast(payload as STRING) AS payload_json FROM events;VARIANT 列在 COW 和 MOR 表上均支持 UPDATE、DELETE 和 MERGE 操作。
Spark 3.x(3.4 / 3.5)
parse_json()、variant_get() 和 cast(... as STRING) 需要 Spark 4.0+。在 Spark 3.x 上,请通过向后兼容的 DDL 读取原始二进制缓冲区;不支持将谓词下推到 VARIANT 字段。
端到端示例
hudi_vector_search 与 read_blob() 可以在单个查询中组合使用,该查询既返回匹配的行,也返回每一行对应的具体字节内容:
SELECT image_id, category,
       read_blob(image_bytes) AS resolved_bytes,
       _hudi_distance
FROM hudi_vector_search(
    '/tmp/hudi_pets', 'embedding',
    ARRAY(0.12, -0.03, /* ... */),
    5, 'cosine'
)
ORDER BY _hudi_distance;完整的端到端操作流程请参阅非结构化数据快速入门指南。
查询索引和时间线
Hudi 还允许用户直接查询元数据分区,检查表及各类索引对应的元数据。本节将介绍可用于此目的的各种查询。
首先,我们创建一个包含各类索引的表。
-- Create a table with primary key
CREATE TABLE hudi_indexed_table (
    ts BIGINT,
    uuid STRING,
    rider STRING,
    driver STRING,
    fare DOUBLE,
    city STRING
) USING HUDI
options(
    primaryKey ='uuid',
    hoodie.write.record.merge.mode = "COMMIT_TIME_ORDERING"
)
PARTITIONED BY (city);

-- Create partition stat index
SET hoodie.metadata.index.partition.stats.enable=true;
SET hoodie.metadata.index.column.stats.enable=true;

INSERT INTO hudi_indexed_table
VALUES
(1695159649,'334e26e9-8355-45cc-97c6-c31daf0df330','rider-A','driver-K',19.10,'san_francisco'),
(1695091554,'e96c4396-3fad-413a-a942-4cb36106d721','rider-C','driver-M',27.70 ,'san_francisco'),
(1695046462,'9909a8b1-2d15-4d3d-8ec9-efc48c536a00','rider-D','driver-L',33.90 ,'san_francisco'),
(1695332066,'1dced545-862b-4ceb-8b43-d2a568f6616b','rider-E','driver-O',93.50,'san_francisco'),
(1695516137,'e3cf430c-889d-4015-bc98-59bdce1e530c','rider-F','driver-P',34.15,'sao_paulo'    ),
(1695376420,'7a84095f-737f-40bc-b62f-6b69664712d2','rider-G','driver-Q',43.40 ,'sao_paulo'    ),
(1695173887,'3eeb61f7-c2b0-4636-99bd-5d7a5a1d2c04','rider-I','driver-S',41.06 ,'chennai'      ),
(1695115999,'c8abbe79-8d89-47ea-b4ce-4d224bae5bfa','rider-J','driver-T',17.85,'chennai');

-- Create column stat expression index on ts column
CREATE INDEX idx_column_ts ON hudi_indexed_table USING column_stats(ts) OPTIONS(expr='from_unixtime', format = 'yyyy-MM-dd');
-- Create secondary index on rider column
CREATE INDEX record_index ON hudi_indexed_table (uuid);
CREATE INDEX idx_rider ON hudi_indexed_table (rider);
SET hoodie.metadata.record.index.enable=true;
-- Query the secondary keys stores in the secondary index partition
SELECT key FROM hudi_metadata('hudi_indexed_table') WHERE type=7;
-- Query the column stat records stored in the column stat indexes or column stat expression index
select ColumnStatsMetadata.columnName, ColumnStatsMetadata.minValue, ColumnStatsMetadata.maxValue from hudi_metadata('hudi_indexed_table') where type=3;
-- Query can be further refined to get nested fields and exact values for a particular partition.
-- Below query fetches the column stats metadata for column stat expression index on ts column.
select ColumnStatsMetadata.columnName, ColumnStatsMetadata.minValue.member6.value, ColumnStatsMetadata.maxValue.member6.value from hudi_metadata('hudi_indexed_table') where type=3 AND ColumnStatsMetadata.columnName='ts';
-- Query the partition stat index records for rider column. Partition stat index records use the same schema as column stat index records
select ColumnStatsMetadata.columnName, ColumnStatsMetadata.minValue.member6.value, ColumnStatsMetadata.maxValue.member6.value from hudi_metadata('hudi_indexed_table') where type=6 AND ColumnStatsMetadata.columnName='rider';所有不同的索引类型都可以通过指定该索引的 type 列来查询。以下是元数据分区及其对应的 type 列取值。
| 元数据分区 | type 列取值 |
|---|---|
| Files | 2 |
| Column Stat | 3 |
| Bloom Filters | 4 |
| Record Index | 5 |
| Secondary Index | 7 |
| Partition Stats | 6 |
Flink SQL
一旦 Flink Hudi 表被注册到 Flink catalog 中,就可以使用 Flink SQL 对其进行查询。它支持两种 Hudi 表类型的所有查询类型,依赖于与 Hive 类似的自定义 Hudi 输入格式。通常,Notebook 用户和 Flink SQL CLI 用户会使用 Flink SQL 来查询 Hudi 表。请按照 Flink 快速入门中的说明添加 hudi-flink-bundle。
快照查询
默认情况下,Flink SQL 会尝试使用其优化的原生读取器(例如读取 Parquet 文件)而非 Hive SerDes。此外,如果过滤条件中指定了分区谓词,Flink 会应用分区裁剪。谓词下推可能尚不支持(请查阅 Flink 路线图)。
select * from hudi_table/*+ OPTIONS('metadata.enabled'='true', 'read.data.skipping.enabled'='false','hoodie.metadata.index.column.stats.enable'='true')*/;选项
| 选项名称 | 是否必需 | 默认值 | 说明 |
|---|---|---|---|
metadata.enabled | false | false | 设置为 true 以启用 |
read.data.skipping.enabled | false | false | 是否为批量快照读取启用数据跳过,默认禁用 |
hoodie.metadata.index.column.stats.enable | false | false | 是否启用列统计信息(最大值/最小值) |
hoodie.metadata.index.column.stats.column.list | false | 无 | 需要收集列统计信息的列(以逗号分隔) |
流式查询
默认情况下,hoodie 表以批处理方式读取,即读取最新的快照数据集并返回。将选项 read.streaming.enabled 设置为 true 可开启流式读取模式。通过设置选项 read.start-commit 来指定读取的起始偏移量,若要消费全部历史数据集,请将其值指定为 earliest。
select * from hudi_table/*+ OPTIONS('read.streaming.enabled'='true', 'read.start-commit'='earliest')*/;选项
| 选项名称 | 是否必需 | 默认值 | 说明 |
|---|---|---|---|
read.streaming.enabled | 否 | false | 指定为 true 表示以流式方式读取 |
read.start-commit | 否 | 最新的 commit | 起始 commit 时间,格式为 'yyyyMMddHHmmss',使用 earliest 表示从起始 commit 开始消费 |
read.streaming.skip_compaction | 否 | false | 流式读取时是否跳过 compaction instants,通常有两个目的:1) 对于由 Hudi 0.11.0 之前版本创建的表,或当 hoodie.compaction.preserve.commit.metadata 被禁用时,避免从 compaction instants 中消费到重复数据;2) 当启用 changelog 模式时,仅消费变更以获得正确的语义。 |
clean.retain_commits | 否 | 10 | 清理前保留的最大 commit 数量;当启用 changelog 模式时,可通过调整该选项来改变 changelog 的存活时间。例如,如果检查点间隔设置为 5 分钟,默认策略会保留 50 分钟的 changelog。 |
注意
建议用户使用 Hudi 0.12.3 之后的版本以获得最佳体验,并避免使用任何更旧的版本。具体来说,只有当 MOR 表是由 Hudi < 0.11.0 版本完成 compaction 时,才应启用 read.streaming.skip_compaction。这是因为 hoodie.compaction.preserve.commit.metadata 功能是在 Hudi >=0.11.0 版本中引入的。更旧的版本会用 compaction 计划的 instant 时间覆盖每行原始的 commit 时间,从而导致行级别的 instant 范围检查无法正常工作。
增量查询
增量查询有 3 种使用场景:
- 流式查询:通过选项
read.start-commit指定起始 commit; - 批量查询:通过选项
read.start-commit指定起始 commit,通过选项read.end-commit指定结束 commit,区间为闭区间:起始 commit 和结束 commit 均包含在内; - 时间旅行:针对某个 instant time 以批量方式消费,只需指定
read.end-commit即可,因为默认情况下起始 commit 为最新 commit。
select * from hudi_table/*+ OPTIONS('read.start-commit'='earliest', 'read.end-commit'='20231122155636355')*/;选项
| 选项名称 | 是否必填 | 默认值 | 备注 |
|---|---|---|---|
read.start-commit | false | the latest commit | Specify earliest to consume from the start commit |
read.end-commit | false | the latest commit | -- |
Catalog
Hudi catalog 可以管理由 Flink 创建的表,表元数据会被持久化,以避免重复创建表。hms 模式下的 catalog 会自动补充 Hive 同步参数。
hms 模式下 Catalog SQL 的示例:
CREATE CATALOG hoodie_catalog
WITH (
  'type'='hudi',
  'catalog.path' = '${catalog root path}', -- only valid if the table options has no explicit declaration of table path
  'hive.conf.dir' = '${dir path where hive-site.xml is located}',
  'mode'='hms' -- also support 'dfs' mode so that all the table metadata are stored with the filesystem
);
选项
| 选项名称 | 必填 | 默认值 | 说明 |
|---|---|---|---|
catalog.path | true | -- | 默认的 catalog 根路径,用于推导格式为 ${catalog.path}/${db_name}/${table_name} 的完整表路径 |
default-database | false | default | 默认数据库名称 |
hive.conf.dir | false | -- | hive-site.xml 所在的目录,仅在 hms 模式下有效 |
mode | false | dfs | 指定为 hms 可将表元数据保存到 Hive metastore |
table.external | false | false | 是否创建外部表,仅在 hms 模式下有效 |
查询元数据列
Flink SQL 现已支持查询 Hudi 表中的虚拟元数据列。这些特殊列可用于访问 Hudi 的内部元数据,例如提交时间、记录键和分区路径。支持的虚拟元数据列如下:
| 元数据列名称 | 说明 |
|---|---|
_hoodie_commit_time | 记录被提交时的提交时间 |
_hoodie_commit_seqno | 该记录的提交序号 |
_hoodie_record_key | 该记录的记录键 |
_hoodie_partition_path | 该记录所属的分区路径 |
_hoodie_file_name | 存储该记录的文件名 |
_hoodie_operation | 该记录的 changelog 操作,需要通过 'changelog.enabled' = 'true' 启用 |
在 SQL 查询中选择这些列之前,你需要先在 DDL 中通过 Flink SQL 的虚拟元数据列语法对它们进行定义。
使用示例:
CREATE TABLE hudi_table(
    _hoodie_commit_time STRING METADATA VIRTUAL,
    _hoodie_record_key STRING METADATA VIRTUAL,
    ts BIGINT,
    uuid VARCHAR(40) PRIMARY KEY NOT ENFORCED,
    rider VARCHAR(20),
    driver VARCHAR(20),
    fare DOUBLE,
    city VARCHAR(20)
)
PARTITIONED BY (`city`)
WITH (
  'connector' = 'hudi',
  'path' = 'file:///tmp/hudi_table',
  'table.type' = 'MERGE_ON_READ'
);

-- Insert some records into the table
INSERT INTO hudi_table
VALUES
(1695159649087,'334e26e9-8355-45cc-97c6-c31daf0df330','rider-A','driver-K',19.10,'san_francisco'),
(1695091554788,'e96c4396-3fad-413a-a942-4cb36106d721','rider-C','driver-M',27.70 ,'san_francisco'),
(1695046462179,'9909a8b1-2d15-4d3d-8ec9-efc48c536a00','rider-D','driver-L',33.90 ,'san_francisco'),
(1695332066204,'1dced545-862b-4ceb-8b43-d2a568f6616b','rider-E','driver-O',93.50,'san_francisco'),
(1695516137016,'e3cf430c-889d-4015-bc98-59bdce1e530c','rider-F','driver-P',34.15,'sao_paulo'),
(1695376420876,'7a84095f-737f-40bc-b62f-6b69664712d2','rider-G','driver-Q',43.40 ,'sao_paulo'),
(1695173887231,'3eeb61f7-c2b0-4636-99bd-5d7a5a1d2c04','rider-I','driver-S',41.06 ,'chennai'),
(1695115999911,'c8abbe79-8d89-47ea-b4ce-4d224bae5bfa','rider-J','driver-T',17.85,'chennai');

-- Query a Hudi table with virtual metadata columns
SELECT
    _hoodie_commit_time,
    _hoodie_record_key,
    uuid,
    rider,
    fare
FROM hudi_table;
note
虚拟元数据列是只读的,因此在 INSERT 语句中可以直接忽略它们,只需为常规数据列提供值即可。
Hive
Hive 支持对 Hudi 表进行快照查询和增量查询(存在限制)。
为了让 Hive 能够识别 Hudi 表并正确查询,需要将 hudi-hadoop-mr-bundle-<hudi.version>.jar 提供给 Hive2Server 的 aux jars path,此外还需要将该 bundle 放置到集群中各节点的 hadoop/hive 安装目录下。除了上述配置之外,对于 beeline cli 访问,还需要将 hive.input.format 变量设置为 inputformat 的全限定类名 org.apache.hadoop.hive.ql.io.HoodieParquetInputFormat。对于 Tez,还需要将 hive.tez.input.format 设置为 org.apache.hadoop.hive.ql.io.HiveInputFormat。
完成以上配置后,用户就可以像查询其他 Hive 表一样,对该表发起快照查询。
增量查询
# set hive session properties for incremental querying like below
# type of query on the table
set hoodie.<table_name>.consume.mode=INCREMENTAL;
# Specify start timestamp to fetch first commit after this timestamp.
set hoodie.<table_name>.consume.start.timestamp=20180924064621;
# Max number of commits to consume from the start commit. Set this to -1 to get all commits after the starting commit.
set hoodie.<table_name>.consume.max.commits=3;

# usual hive query on hoodie table
select `_hoodie_commit_time`, col_1, col_2, col_4  from hudi_table where  col_1 = 'XYZ' and `_hoodie_commit_time` > '20180924064621';
使用 Fetch 任务执行的 Hive 增量查询
由于 Hive Fetch 任务会对每个分区调用 InputFormat.listStatus(),因此元数据会在每次这样的 listStatus() 调用中被列出。为避免这种情况,可以在增量查询中使用 Hive 会话属性禁用 fetch 任务:set hive.fetch.task.conversion=none; 这样可以确保 Hive 查询采用 Map Reduce 执行方式,将各个分区(以逗号分隔)合并,并且只对所有这些分区调用一次 InputFormat.listStatus()。
AWS Athena
AWS Athena 是一项交互式查询服务,可使用标准 SQL 轻松分析 Amazon S3 中的数据。它通过 Hive 连接器支持查询 Hudi 表。目前,它支持对 COPY_ON_WRITE 表执行快照查询,以及对 MERGE_ON_READ Hudi 表执行快照查询和读优化查询。
Presto
Presto 是一款广受欢迎的交互式查询性能查询引擎。通过两种连接器——Hive 连接器和 Hudi 连接器(Presto 0.275 及更高版本)——可以使用 PrestoDB 查询 Hudi 表。目前,这两种连接器都支持对 COPY_ON_WRITE 表执行快照查询,以及对 MERGE_ON_READ Hudi 表执行快照查询和读优化查询。
由于 Presto-Hudi 集成随着时间不断发展,PrestoDB 的安装说明会因版本而异。请查看下表了解支持的查询类型和安装说明。
| PrestoDB 版本 | 安装说明 | 支持的查询类型 |
|---|---|---|
| < 0.233 | 需要将 hudi-presto-bundle jar 放置到 <presto_install>/plugin/hive-hadoop2/ 目录下,适用于整个安装。 | COW 表的快照查询。MOR 表的读优化查询。 |
| > = 0.233 | 无需任何操作。Hudi(0.5.1-incubating)是编译时依赖。 | COW 表的快照查询。MOR 表的读优化查询。 |
| > = 0.240 | 无需任何操作。Hudi 0.5.3 版本是编译时依赖。 | COW 和 MOR 表的快照查询。 |
| > = 0.268 | 无需任何操作。Hudi 0.9.0 版本是编译时依赖。 | bootstrap 表的快照查询。 |
| > = 0.272 | 无需任何操作。Hudi 0.10.1 版本是编译时依赖。 | 文件列表优化。查询性能提升。 |
| > = 0.275 | 无需任何操作。Hudi 0.11.0 版本是编译时依赖。 | 以上全部功能。与 Hive 连接器同等能力的原生 Hudi 连接器。 |
:::note
无论通过 Hive 连接器还是 Hudi 连接器,目前都不支持增量查询和时间点查询。不过,这已列入我们的路线图,你可以在该 GitHub issue下跟踪开发进展。
:::
要使用 Hudi 连接器,请在 /presto-server-0.2xxx/etc/catalog/hudi.properties 中按如下方式配置 hudi catalog:
connector.name=hudi
hive.metastore.uri=thrift://xxx.xxx.xxx.xxx:9083
hive.config.resources=.../hadoop-2.x/etc/hadoop/core-site.xml,.../hadoop-2.x/etc/hadoop/hdfs-site.xml
欲了解 Hudi 连接器的更多用法,请参阅 prestodb 文档。
Trino
与 PrestoDB 类似,Trino 支持通过 Hive 连接器或原生 Hudi 连接器(在 398 版本中引入)查询 Hudi 表。对于 Trino 411 及更高版本,Hive 连接器在读取 Hudi 表时会重定向到 Hudi catalog。在这些版本中使用 Hive 连接器时,请确保配置好表重定向所需的设置。
hive.hudi-catalog-name=hudi安装说明
我们建议使用 hudi-trino-bundle 0.12.2 或更高版本,以便与 Hive 连接器配合获得最佳查询性能。下表总结了 Trino 各版本对 Hudi 的支持情况。
| Trino 版本 | 安装说明 | 支持的查询类型 |
|---|---|---|
| < 398 | 不适用 —— 只能使用 Hive 连接器查询 Hudi 表 | 与 Hive 连接器版本 < 406 相同。 |
| > = 398 | 不适用 —— 无需手动放置 bundle jar,因为它们是编译时依赖项 | 对 COW 表进行快照查询,对 MOR 表进行读优化查询。 |
| < 406 | 将 hudi-trino-bundle jar 放入 <trino_install>/plugin/hive | 对 COW 表进行快照查询,对 MOR 表进行读优化查询。 |
| > = 406 | 将 hudi-trino-bundle jar 放入 <trino_install>/plugin/hive | 对 COW 表进行快照查询,对 MOR 表进行读优化查询。同时支持重定向到 Hudi catalog。 |
| > = 411 | 不适用 | 对 COW 表进行快照查询,对 MOR 表进行读优化查询。Hudi 表只能通过表重定向进行查询。 |
有关 Hudi 连接器的详细信息,请参阅连接器文档。两种连接器都对 COW 表提供「快照」查询,对 MOR 表提供「读优化」查询。MOR 表快照查询的支持预计很快推出。
Impala
Impala(版本 > 3.4)能够以外部表的形式查询 Hudi Copy-on-write 表。
在 Impala 上创建 Hudi 读优化表的方法如下:
CREATE EXTERNAL TABLE database.table_name
LIKE PARQUET '/path/to/load/xxx.parquet'
STORED AS HUDIPARQUET
LOCATION '/path/to/load';
Impala 能够利用分区裁剪来提升查询性能,使用的是传统的 Hive 风格分区方式。要创建分区表,文件夹应遵循类似 year=2020/month=1 的命名约定。
在 Impala 上创建分区 Hudi 表:
CREATE EXTERNAL TABLE database.table_name
LIKE PARQUET '/path/to/load/xxx.parquet'
PARTITION BY (year int, month int, day int)
STORED AS HUDIPARQUET
LOCATION '/path/to/load';
ALTER TABLE database.table_name RECOVER PARTITIONS;
Hudi 完成新的提交后,刷新 Impala 表,以获取对外暴露的最新快照供查询使用。
REFRESH database.table_nameRedshift Spectrum
Apache Hudi 0.5.2、0.6.0、0.7.0、0.8.0、0.9.0、0.10.x 和 0.11.x 版本的写时复制(Copy on Write)表可以通过 Amazon Redshift Spectrum 外部表进行查询。若要查询 Hudi 0.10.0 及以上版本,请尝试使用最新版本的 Redshift。
note
只有在使用 AWS Glue Data Catalog 时才支持 Hudi 表。使用 Apache Hive 元存储作为外部目录时则不支持。
更多详情请参阅 Redshift Spectrum 与 Apache Hudi 的集成。
Doris
Doris 集成目前支持 Hudi 0.10.0 及以上版本的写时复制(Copy on Write)表和读时合并(Merge On Read)表。你可以从 Doris 2.0 开始通过 Doris 查询 Hudi 表。Doris 提供了多目录(multi-catalog)功能,旨在更方便地连接外部数据目录,从而增强 Doris 的数据湖分析和联邦数据查询能力。有关配置的更多详情,请参阅 Doris Hudi Catalog。
note
当前默认支持的 Hudi 版本为 0.10.0 ~ 0.13.1,尚未在其他版本上进行测试。未来将支持更多版本。
StarRocks
对于写时复制(Copy-on-Write)表,StarRocks 提供快照(Snapshot)查询支持;对于读时合并(Merge-on-Read)表,StarRocks 提供快照(Snapshot)和读优化(Read Optimized)查询支持。更多详情请参阅 StarRocks 文档。
ClickHouse
ClickHouse 是一个面向联机分析处理(OLAP)的列式数据库。它提供了对写时复制(Copy on Write)Hudi 表的只读集成。要查询此类 Hudi 表,首先需要在 ClickHouse 中使用 Hudi 表函数创建一张表。
CREATE TABLE hudi_table
    ENGINE = Hudi(s3_base_path, [aws_access_key_id, aws_secret_access_key,])
有关更多详情,请参阅 ClickHouse 文档。
支持矩阵
以下表格展示了在特定查询引擎上是否支持给定的查询。
Copy-On-Write 表
| 查询引擎 | 快照查询 | 增量查询 |
|---|---|---|
| Hive | Y | Y |
| Spark SQL | Y | Y |
| Flink SQL | Y | N |
| PrestoDB | Y | N |
| Trino | Y | N |
| AWS Athena | Y | N |
| BigQuery | Y | N |
| Impala | Y | N |
| Redshift Spectrum | Y | N |
| Doris | Y | N |
| StarRocks | Y | N |
| ClickHouse | Y | N |
Merge-On-Read 表
| 查询引擎 | 快照查询 | 增量查询 | 读优化查询 |
|---|---|---|---|
| Hive | Y | Y | Y |
| Spark SQL | Y | Y | Y |
| Spark Datasource | Y | Y | Y |
| Flink SQL | Y | Y | Y |
| PrestoDB | Y | N | Y |
| AWS Athena | Y | N | Y |
| Big Query | Y | N | Y |
| Trino | N | N | Y |
| Impala | N | N | Y |
| Redshift Spectrum | N | N | Y |
| Doris | Y | N | Y |
| StarRocks | Y | N | Y |
| ClickHouse | N | N | N |
评论
登录后参与评论