 KnowForge
Spark 调优指南
 师成· 更新于 2026-09-29· 阅读 12 分钟· 0 次阅读
::: tip
性能分析建议
要更好地了解 Hudi 作业的时间消耗在哪里,可以使用 YourKit Java Profiler 等工具获取堆转储/火焰图。
:::
写入
通用建议
通过 Hudi 写入数据是以 Spark 作业的形式执行的,因此 Spark 调试的一般规则同样适用。如果你希望提升性能或可靠性,以下是需要牢记的几点:
输入并行度:默认情况下,Hudi 遵循输入数据的并行度。如果输入数据量较大、可能导致更多的 shuffle,请相应提高该并行度。我们建议调整 shuffle 并行度 hoodie.[insert|upsert|bulkinsert].shuffle.parallelism,使其至少为 input_data_size/500MB。
堆外内存:Hudi 在写入 Parquet 文件时需要与 schema 宽度成比例的大量堆外内存。如果遇到此类失败,请考虑设置 spark.executor.memoryOverhead 或 spark.driver.memoryOverhead 等参数。
Spark 内存:通常情况下,Hudi 需要能够将单个文件读入内存以执行合并或压缩操作,因此执行器内存应足以容纳这一操作。此外,Hudi 会缓存输入数据以便智能地放置数据,因此保留一定的 spark.memory.storageFraction 通常有助于提升性能。
文件大小:审慎设置目标文件大小,以在摄取/写入延迟与文件数量(以及由此带来的元数据开销)之间取得平衡。
时序/日志数据:默认配置是针对单条记录较大的数据库/NoSQL 变更日志调优的。另一类非常流行的数据是时序/事件/日志数据,这类数据通常体量更大,每个分区包含的记录数更多。在这种情况下,可以考虑调整布隆过滤器的精度以达到目标索引查找时间,或使用分桶索引配置。同时,建议将键设置为以事件时间作为前缀,这样可以启用范围裁剪并显著加快索引查找速度。
Spark 失败
典型的 upsert() DAG 如下所示。注意,Hudi 客户端还会缓存中间 RDD,以便智能地分析工作负载并确定文件大小和 Spark 并行度。另外,由于探测作业也会显示在 Spark UI 中,因此 Spark UI 中会显示两次 sortByKey,但实际上只执行了一次排序。
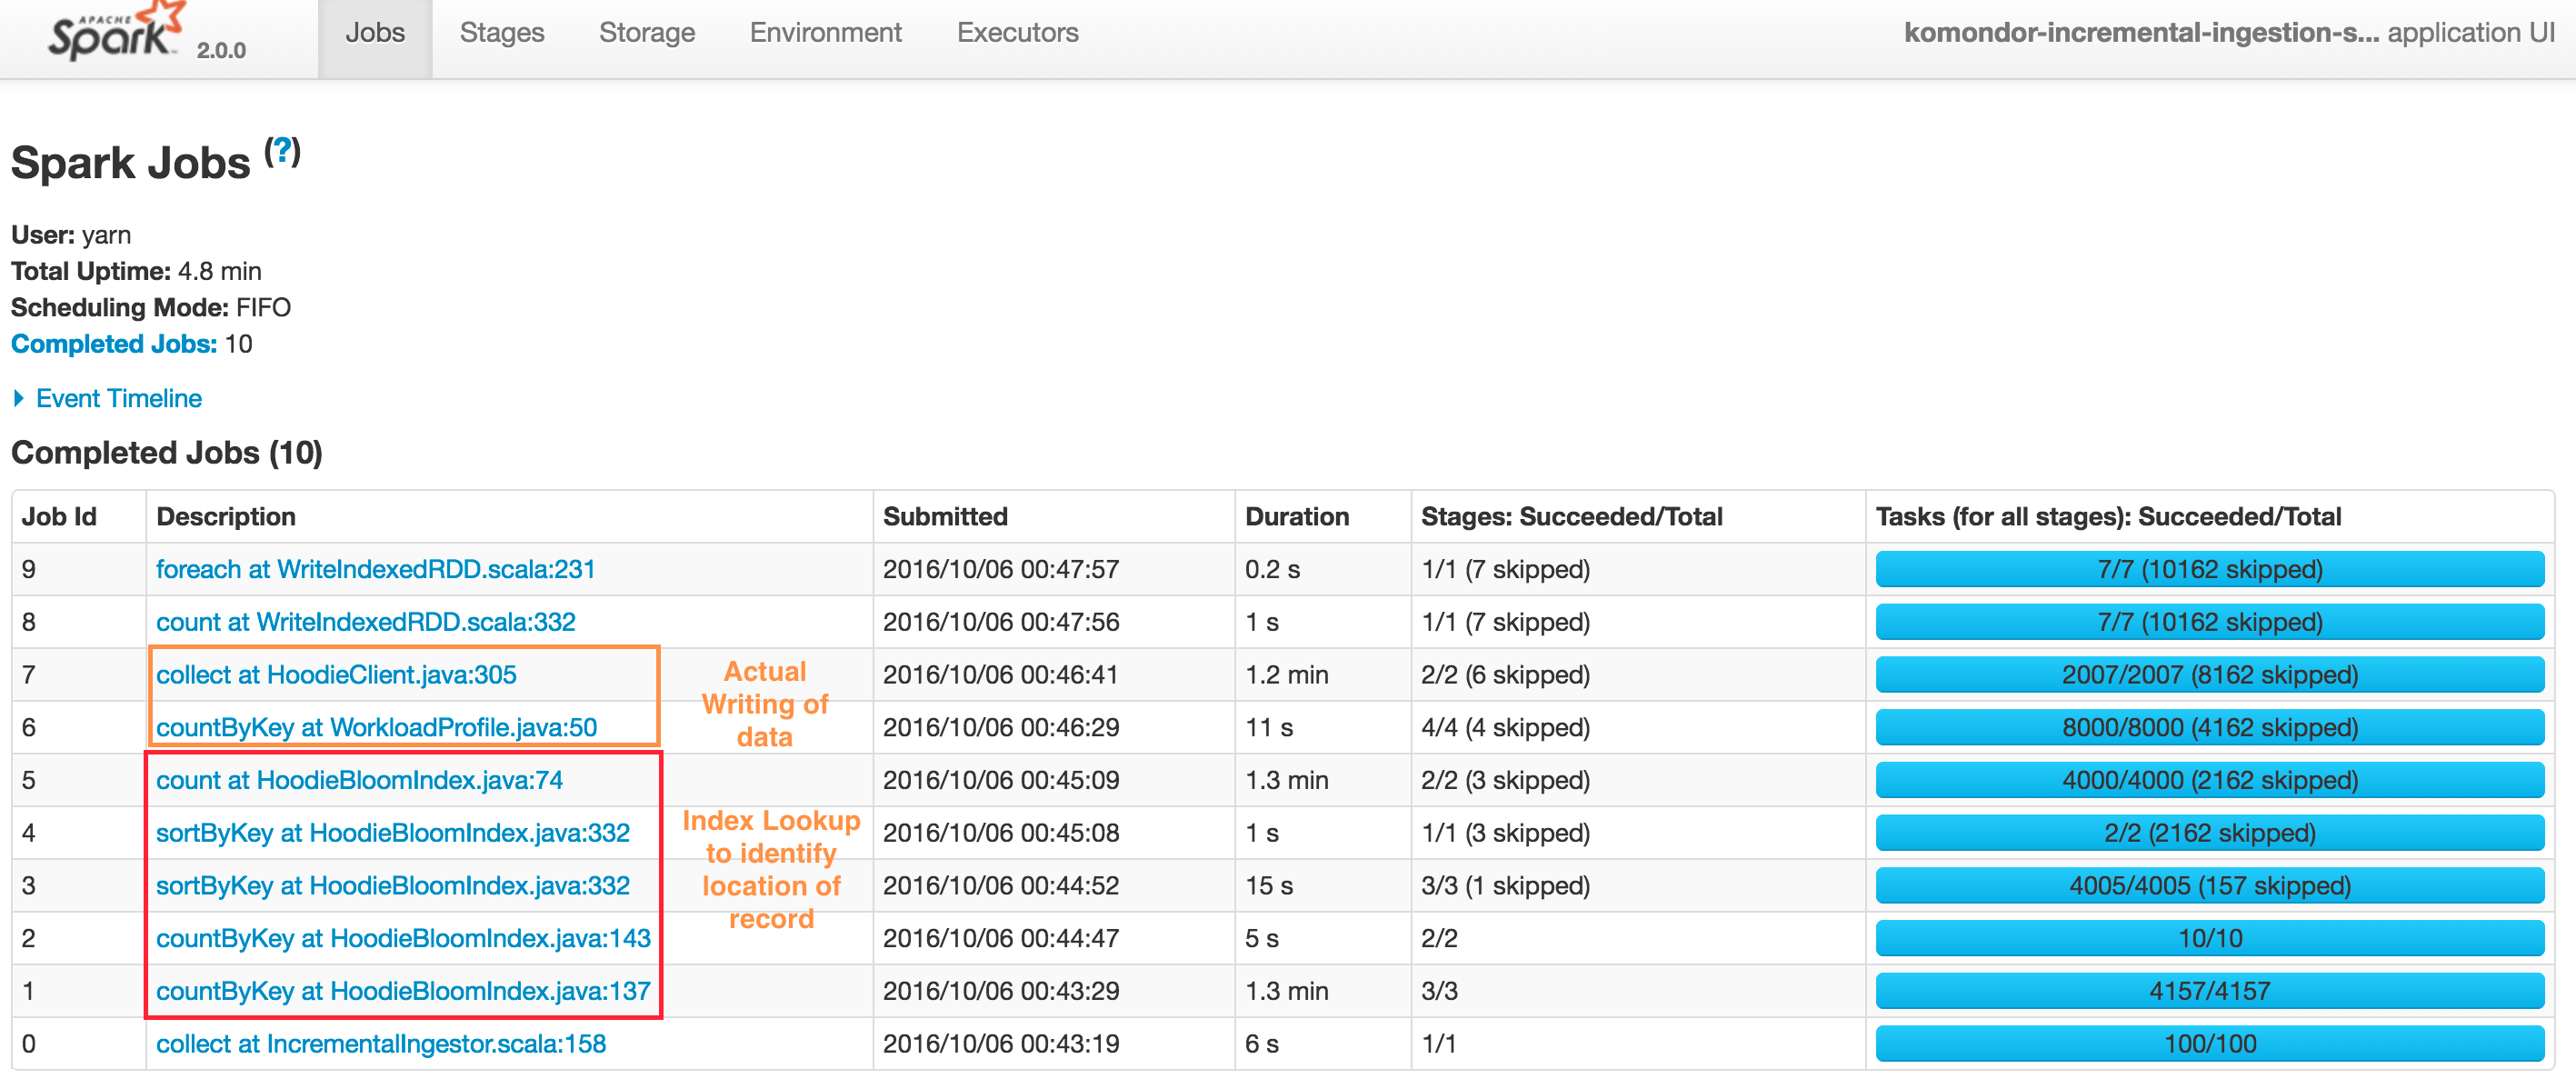
总体而言,分为两个步骤:
索引查找以确定需要更改的文件
- 作业 1:触发输入数据读取,转换为 HoodieRecord 对象,然后在获取输入记录到目标分区路径的分布后停止
- 作业 2:加载需要检查的文件名集合
- 作业 3 和 4:在智能调整 Spark join 并行度后执行实际查找,通过 join 上述 1 和 2 中的 RDD 实现
- 作业 5:生成带有位置信息的 recordKeys 标签化 RDD
执行实际的数据写入
- 作业 6:将传入记录与 recordKey、location 进行惰性连接,以生成最终的 HoodieRecord 集合,这些记录现在包含了它们所在文件/分区路径的信息(如果是插入则为 null)。然后再次对工作负载进行分析,以确定文件的大小。
- 作业 7:实际写入数据(更新 + 插入 + 插入转为更新,以维持文件大小)
根据异常的来源(Hudi/Spark),上述关于 DAG 的知识可用于精确定位实际问题。最常见的失败通常由 YARN/DFS 的临时故障引起。未来,项目中将加入更完善的调试/管理 UI,以帮助自动化部分调试工作。
Hudi 在 upsert 时临时文件夹占用空间过大
在 upsert 大量输入数据时,如果合并达到最大内存限制,Hudi 会将部分输入数据溢写到磁盘。如果内存充足,请增加 Spark executor 的内存以及 hoodie.memory.merge.fraction 选项,例如 option("hoodie.memory.merge.fraction", "0.8")。
如何调优 Hudi 作业的 shuffle 并行度?
首先,让我们理解在 Hudi 作业的语境下"并行度"这一术语的含义。对于任何使用 Spark 的 Hudi 作业,并行度等于 DAG 中某个特定 stage 应生成的 Spark partition 数量。要了解更多关于 Spark partition 的知识,请阅读这篇文章。在 Spark 中,每个 Spark partition 都会映射到一个可在 executor 上执行的 Spark task。通常,对于一个 Spark 应用,以下层级关系成立:
(Spark 应用 → N 个 Spark Job → M 个 Spark Stage → T 个 Spark Task)运行在(E 个 executor,每个具有 C 个 core)之上
一个 Spark 应用可以被分配 E 个 executor 来运行。每个 executor 可能拥有 1 个或多个 Spark core。每个 Spark task 至少需要 1 个 core 来执行,因此可以这样理解:T 个任务需要在 Z 时间内完成,这取决于 C 个 core。C 越高,Z 就越小。
基于这一理解,如果你想让 DAG 的某个 stage 运行得更快,就要让 T 接近甚至超过 C。此外,这个并行度最终也控制着你使用 Hudi 作业写入的输出文件数量。让我们来了解可用的各种调节参数:
BulkInsertParallelism → 用于控制 Hudi 作业创建输出文件时的并行度。并行度越高,创建的 task 就越多,最终生成的输出文件也就越多。即使你将 parquet-max-file-size 设置为较大的值,如果并行度设得非常高,由于 Spark task 处理的数据量较小,最大文件大小的设置也无法得到保证。
Upsert / Insert Parallelism → 用于控制读取数据到作业时的读取速度。更多详情请见此处。
垃圾回收(GC)调优
请务必遵循 Spark 调优指南中的垃圾回收调优建议,以避免 OutOfMemory 错误。必须使用 G1/CMS 收集器。可添加到 spark.executor.extraJavaOptions 的 CMS 参数示例如下:
-XX:NewSize=1g -XX:SurvivorRatio=2 -XX:+UseCompressedOops -XX:+UseConcMarkSweepGC -XX:+UseParNewGC -XX:CMSInitiatingOccupancyFraction=70 -XX:+PrintGCDetails -XX:+PrintGCTimeStamps -XX:+PrintGCDateStamps -XX:+PrintGCApplicationStoppedTime -XX:+PrintGCApplicationConcurrentTime -XX:+PrintTenuringDistribution -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/hoodie-heapdump.hprof内存溢出(OOM)错误:如果仍然不断发生 OOM,请保守地调低 Spark 内存比例:spark.memory.fraction=0.2、spark.memory.storageFraction=0.2,让其将数据溢写到磁盘,而不是直接 OOM。(稳定但缓慢 vs 间歇性崩溃)
下面是 Uber(HDFS/Yarn)在其数据摄取平台上实际使用的一份完整可用的生产环境配置。
spark.driver.extraClassPath /etc/hive/conf
spark.driver.extraJavaOptions -XX:+PrintTenuringDistribution -XX:+PrintGCDetails -XX:+PrintGCDateStamps -XX:+PrintGCApplicationStoppedTime -XX:+PrintGCApplicationConcurrentTime -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/hoodie-heapdump.hprof
spark.driver.maxResultSize 2g
spark.driver.memory 4g
spark.executor.cores 1
spark.executor.extraJavaOptions -XX:+PrintFlagsFinal -XX:+PrintReferenceGC -verbose:gc -XX:+PrintGCDetails -XX:+PrintGCTimeStamps -XX:+PrintAdaptiveSizePolicy -XX:+UnlockDiagnosticVMOptions -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/hoodie-heapdump.hprof
spark.executor.id driver
spark.executor.instances 300
spark.executor.memory 6g
spark.rdd.compress true

spark.kryoserializer.buffer.max 512m
spark.serializer org.apache.spark.serializer.KryoSerializer
spark.shuffle.service.enabled true
spark.submit.deployMode cluster
spark.task.cpus 1
spark.task.maxFailures 4

spark.driver.memoryOverhead 1024
spark.executor.memoryOverhead 3072
spark.yarn.max.executor.failures 100
评论
登录后参与评论