 KnowForge
自动回滚
 师成· 更新于 2026-09-29· 阅读 5 分钟· 0 次阅读
你的管道可能会因为众多原因而失败,例如崩溃、代码中真实存在的缺陷、任何外部第三方系统不可用(比如锁服务提供者),或者用户在中途终止作业以便修改某些属性。一个设计良好的系统应当能够检测出这类部分失败的提交,确保脏数据不会暴露给查询,并将其清理干净。Hudi 的回滚机制正是负责清理这类失败写入的。
Hudi 的 timeline 构成了读写隔离的核心。按照 Hudi timeline,如果某次提交尚未转变为完成状态,读取方就会忽略相应写入产生的数据。因此,部分失败的写入永远不会被任何读取方读取(对所有查询类型均是如此)。但令人好奇的问题是:那部分写入的数据最终是如何被删除的?是否需要不时地手动执行命令,还是应当由系统自动处理?本页介绍了 Hudi 中的"回滚(rollback)"如何在无需用户手动介入的情况下,自动清理部分失败的写入。
处理部分失败的提交
Hudi 内置了大量平台化能力,以简化 lakehouse 表的运维。其中一项特性就是自动清理部分失败的提交。用户无需运行任何额外命令来清理脏数据或失败提交所产生的数据。只要你继续向 Hudi 表写入,你未来的某次提交就会负责清理那些在写入/提交过程中中途失败的旧数据。我们将这种对失败提交的清理称为"回滚"。回滚会撤销某次提交的一切,包括删除数据以及从 timeline 中移除该提交。此外,restore 操作通过执行一系列回滚来撤销已完成的提交。
让我们进一步深入,了解此类清理是如何发生的,以及在涉及多写入方时此类清理面临的挑战。
单写入方的部分失败提交回滚
在单写入方模式下,回滚逻辑相当直接。Hudi timeline 中的每个动作都会经历 3 个状态,即 requested(已请求)、inflight(进行中)和 completed(已完成)。每当新的提交开始时,hudi 会检查 timeline 中是否存在尚未完成的动作/提交,即部分失败的提交。此时会立即触发回滚,清理所有脏数据,随后清理 timeline 中的提交 instants。
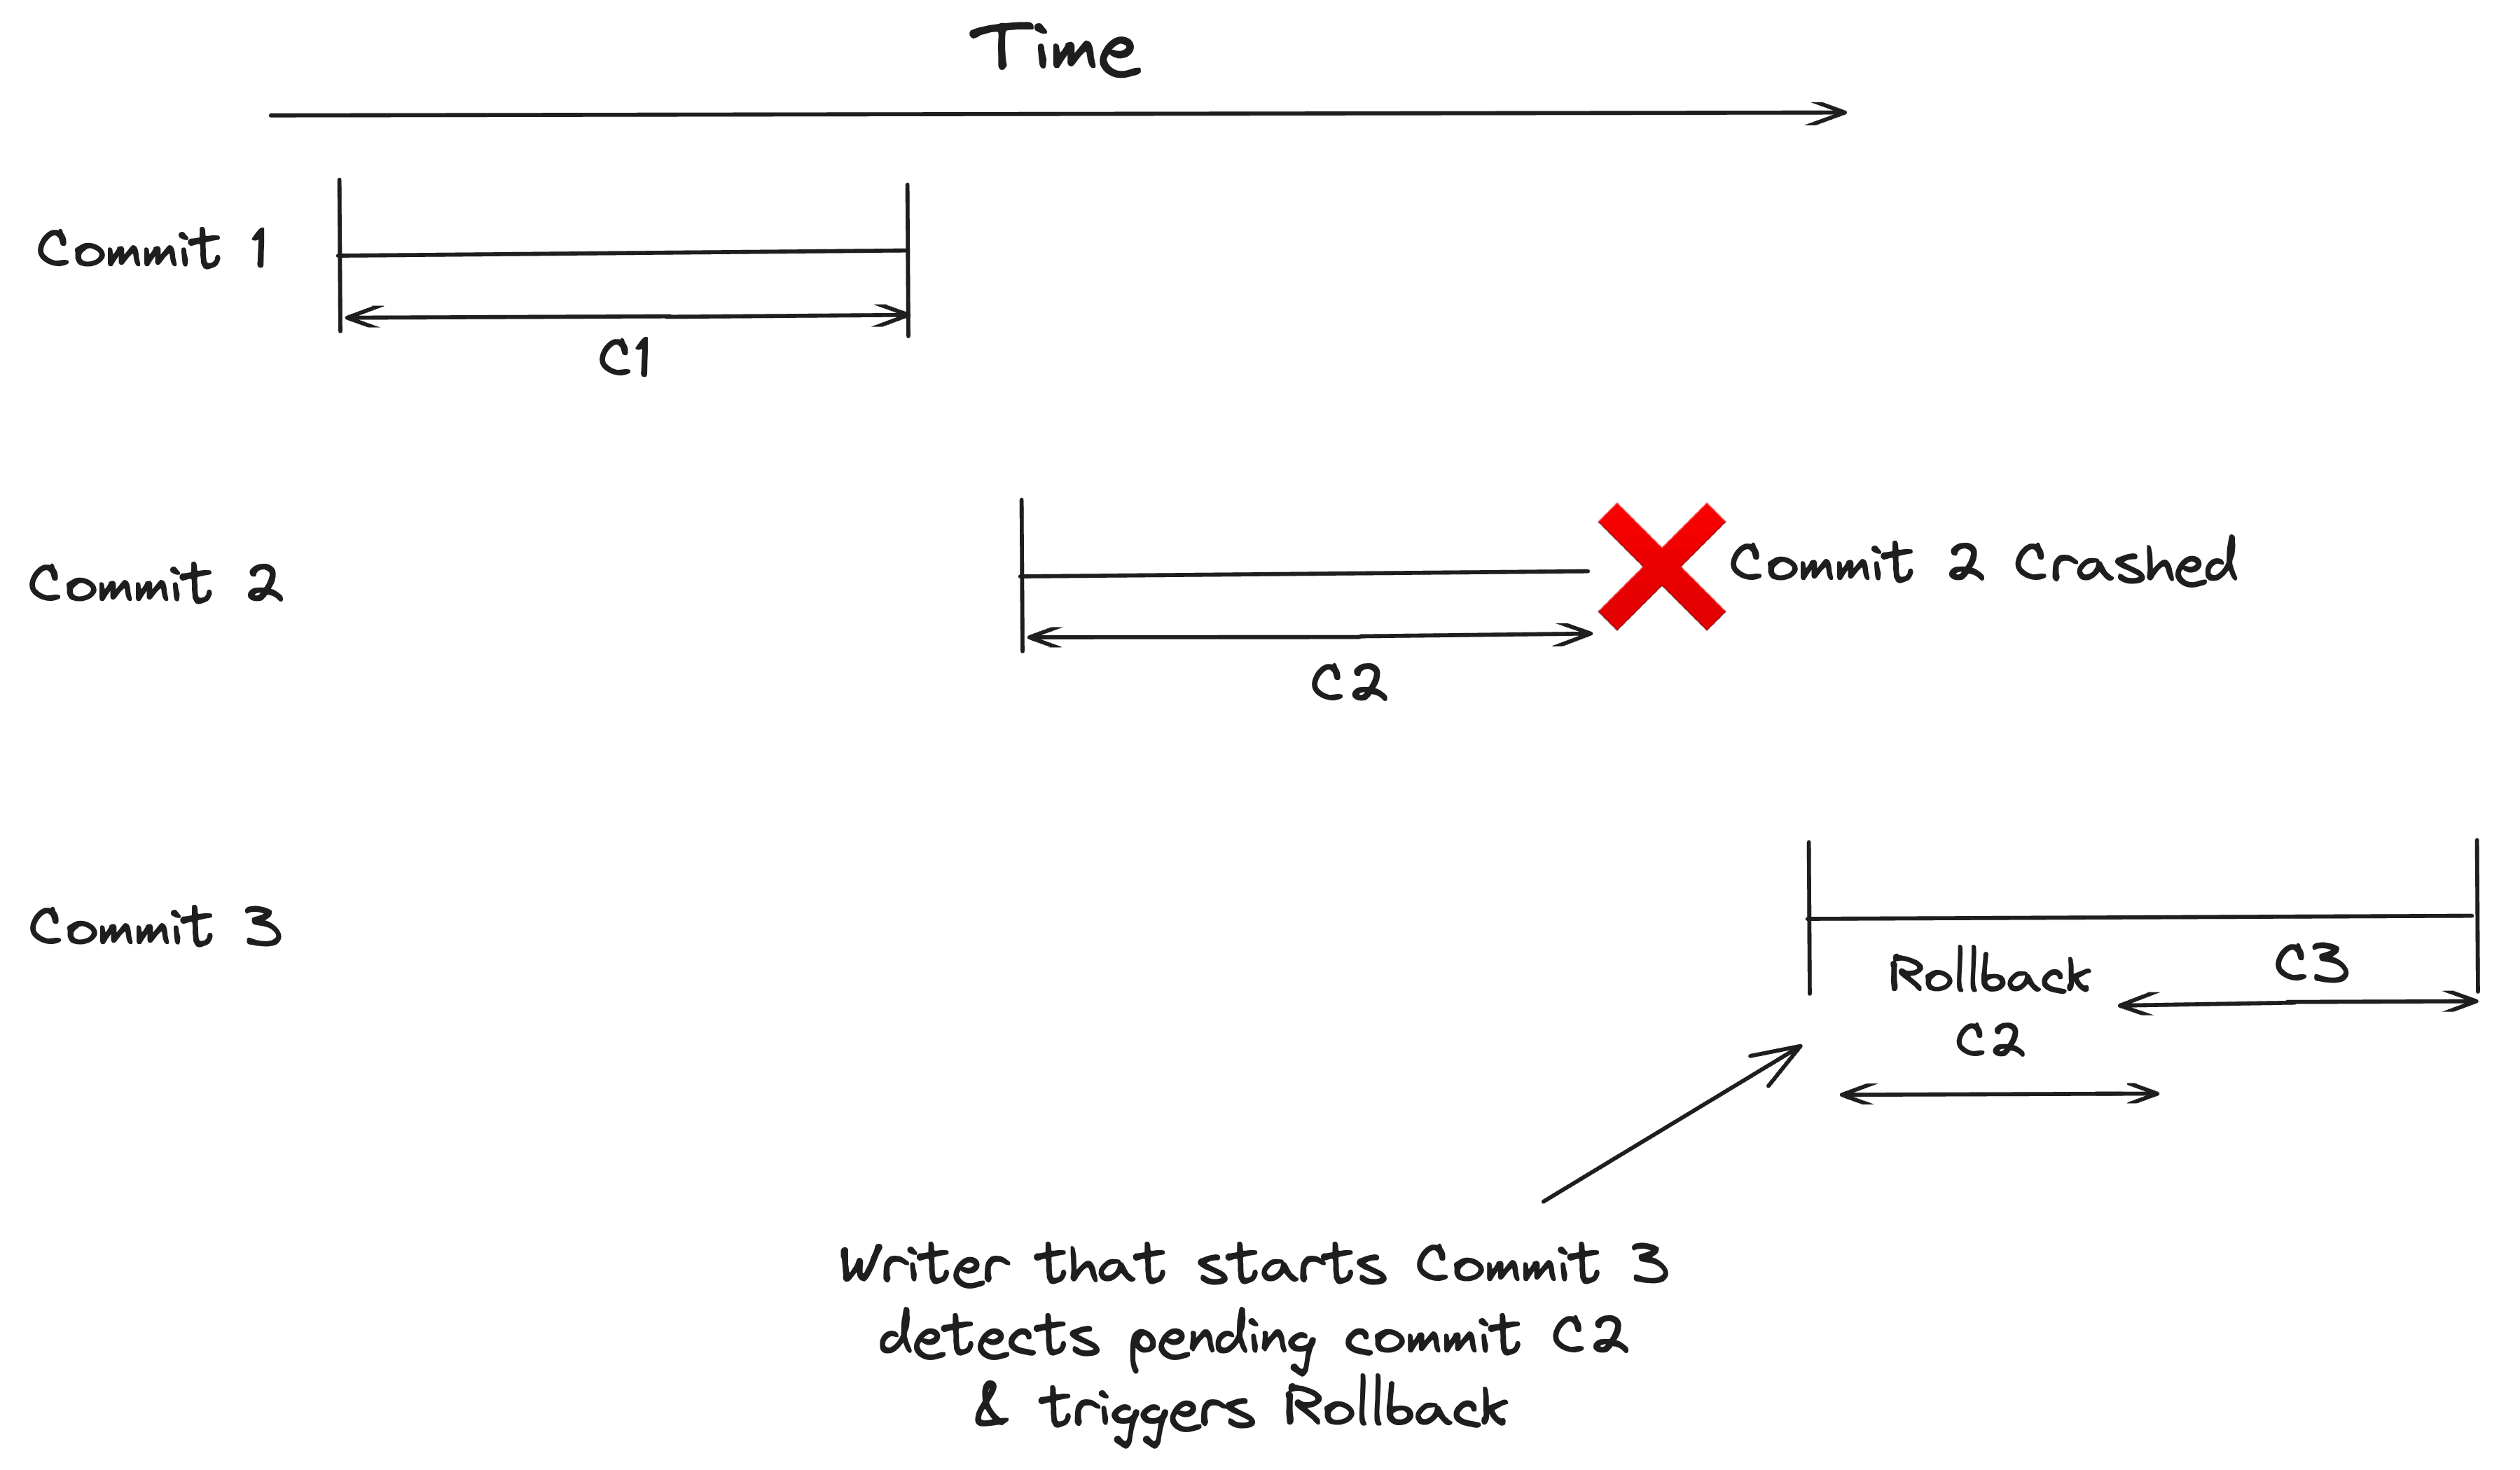 图 1:带有即时回滚的单写入方
多写入方的部分失败提交回滚
困难之处在于多写入器(multi-writer)并发的场景。根据时间线(timeline),某个提交尚未完成,并不意味着当前(新的)写入器可以假定这是一个部分失败的提交,因为可能还有一个并发的写入器正在推进。Hudi 的设计目标是无需始终运行任何中心化服务,因此在这种情况下,Hudi 拥有一种巧妙的方式来推断这类部分失败的写入。
心跳(Heartbeats)
这里我们借助心跳机制来救场。每个提交从开始写入到完成为止,会持续发出心跳。在进行回滚推断时,Hudi 会检查所有正在进行或未完成提交的心跳是否超时,并据此检测部分失败的提交。对于任何正在进行的提交,其心跳不应已经超过超时时间。例如,如果某个提交的心跳超过 10 分钟没有更新,我们就可以安全地假定原始写入器已经失败或崩溃,该未完成的提交也可以安全地清理。因此,多写入器场景下的回滚是惰性的(lazy),并不像单写入器模型中那样是即时的(eager)。但它依然是自动的,用户无需执行任何显式命令来触发对失败写入的清理。当这种惰性回滚触发时,失败写入的数据文件和时间线文件都会被删除。
Hudi 采用一种简单而有效的机制来通知某个提交仍在推进,即心跳。每个提交都会在 .hoodie/.heartbeat/ 下创建一个心跳文件(例如,.hoodie/.heartbeat/20230819183853177)。写入器会启动一个后台线程,按照固定的节奏持续更新该心跳文件,以刷新文件的最后修改时间。因此,通过检查心跳文件的最后修改时间,我们就能知道启动该相关提交的写入器是否仍在推进。提交完成时,心跳文件会被删除;如果写入中途失败,心跳文件的最后修改时间将不再更新,其他写入器在经过一段时间后便可推断出该写入已失败。
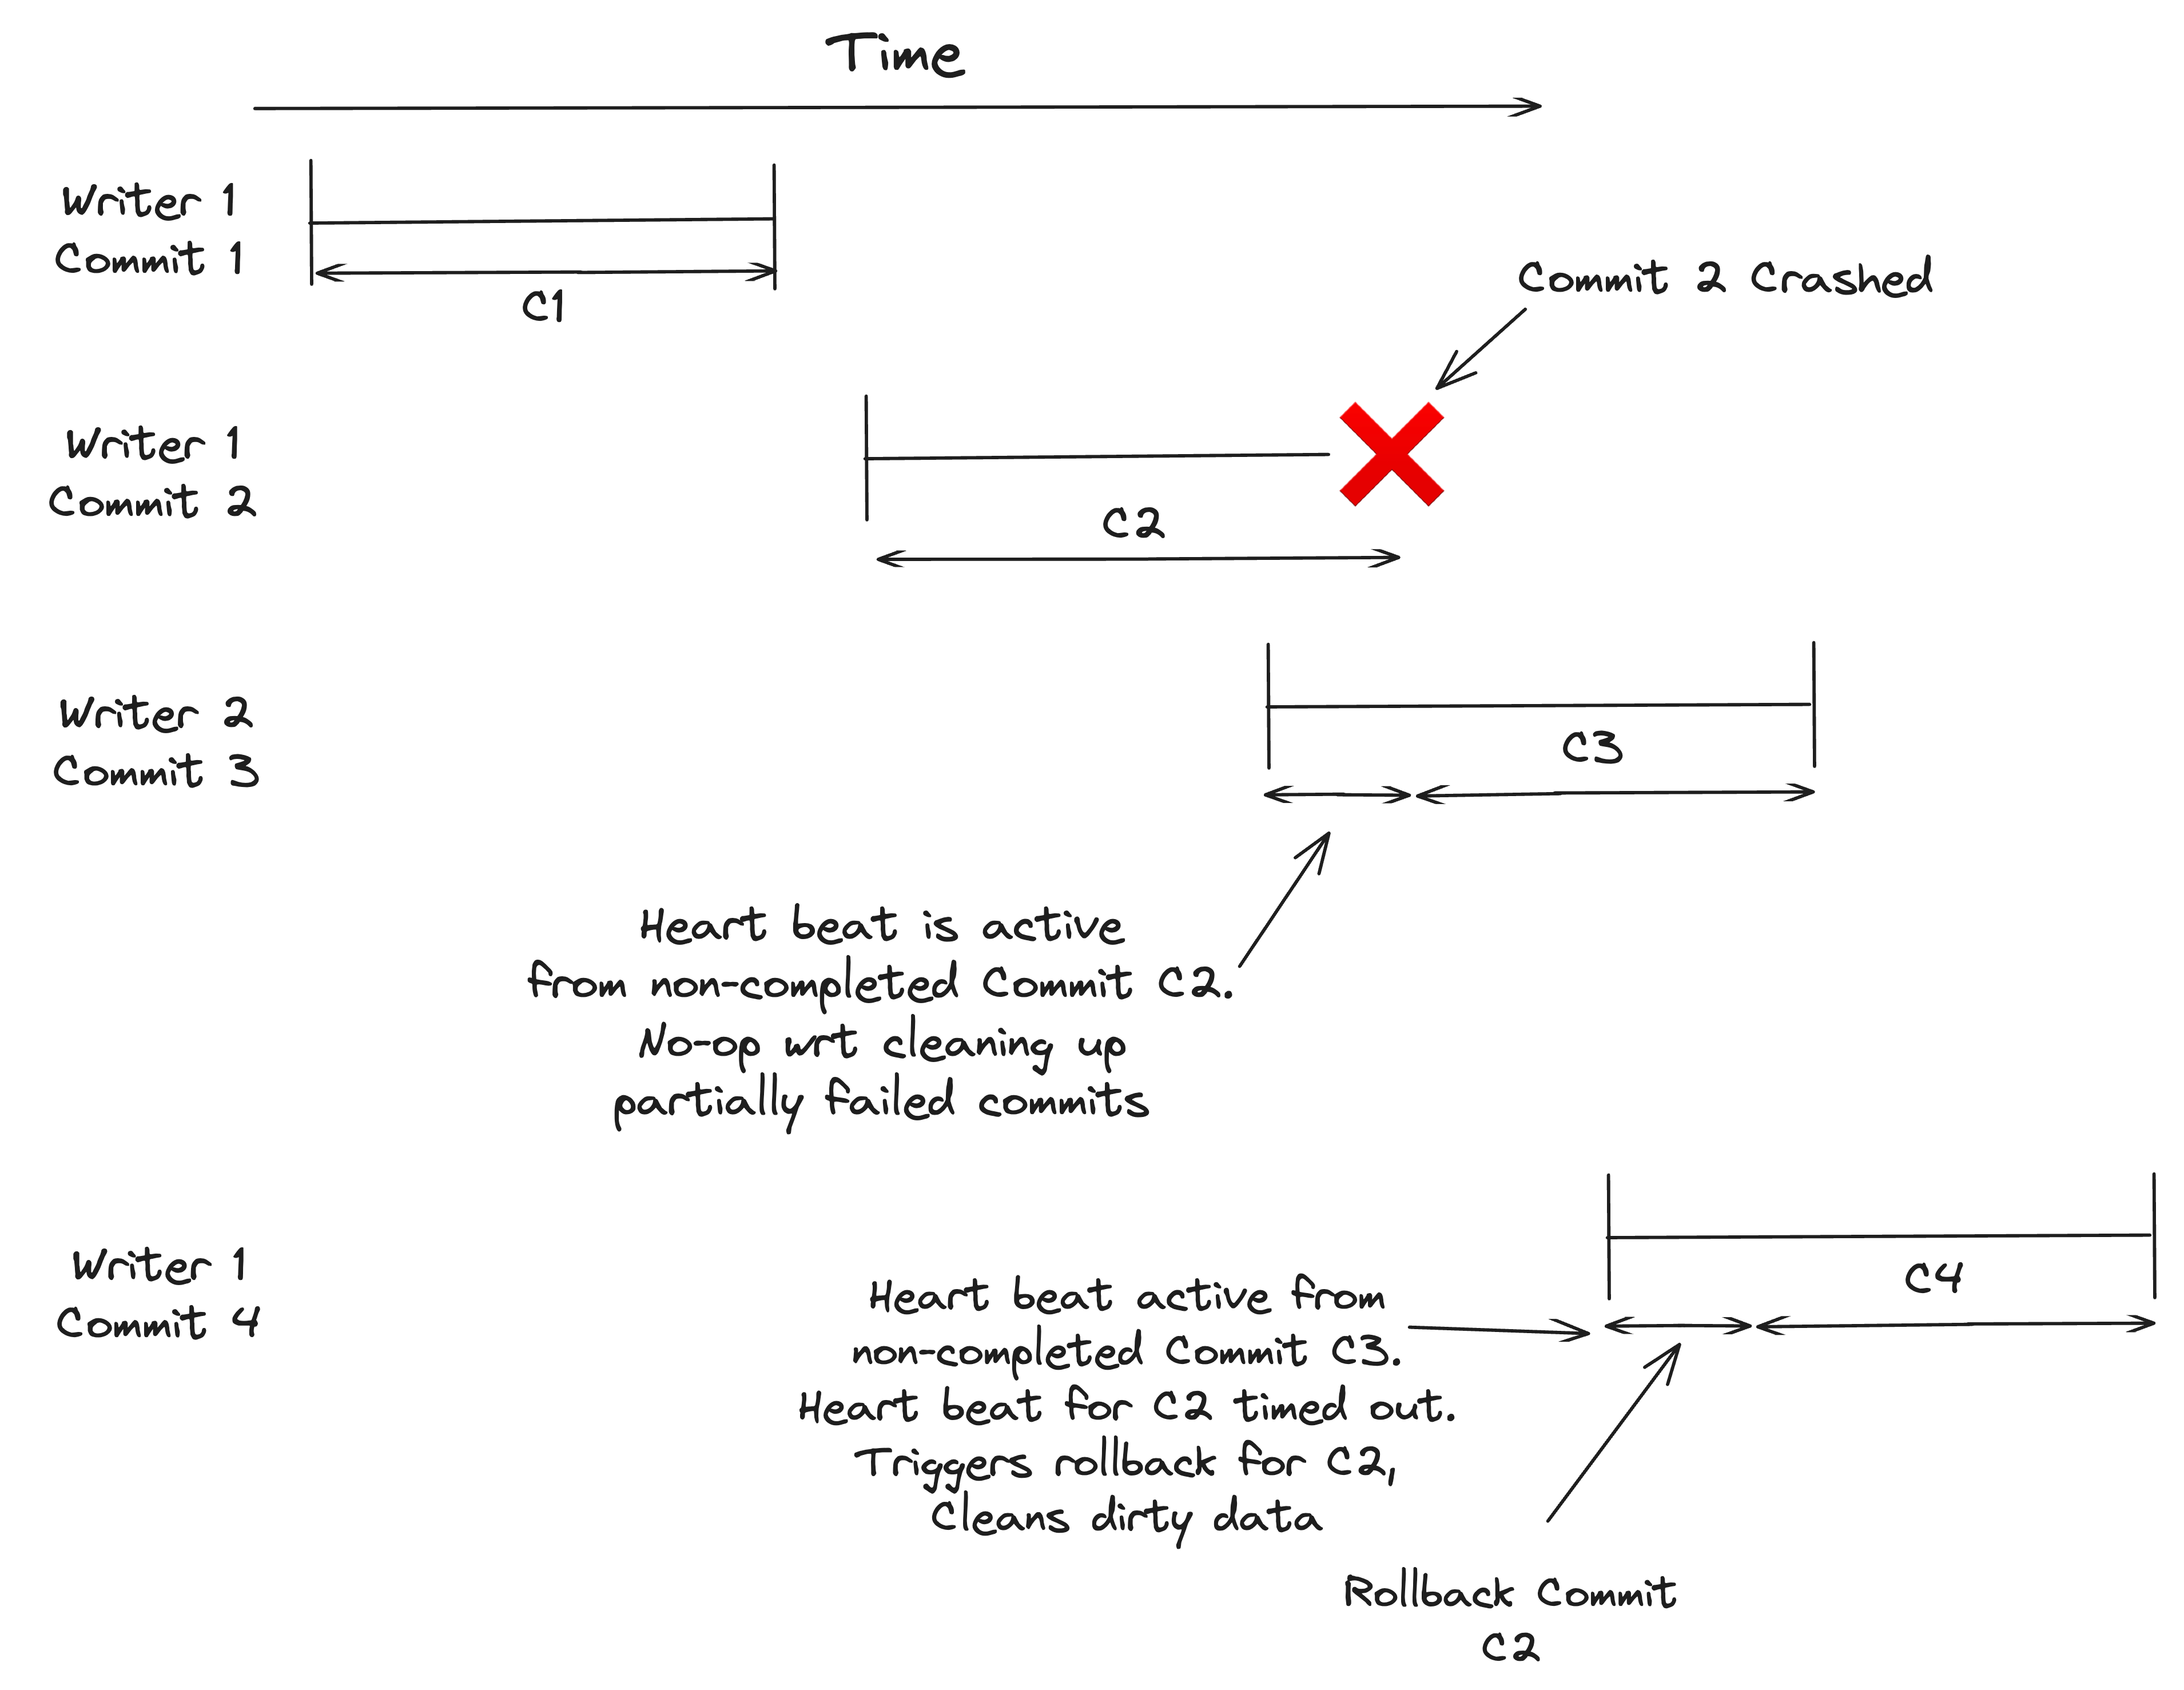 图 2:多写入器场景下对失败提交的惰性清理
视频
评论
登录后参与评论