 KnowForge
线程模型概述
 qianmoQ· 更新于 2026-10-05· 阅读 9 分钟· 0 次阅读
线程模型概述
了解 bRPC 的线程模型。
常见线程模型
连接独占线程或进程
在这种模型中,一个线程/进程负责处理来自某个连接的所有消息,在连接关闭之前不会退出,也不会处理其他任务。随着连接数量增加,线程/进程占用的资源以及上下文切换的开销变得越来越难以承受,导致服务器性能下降。这种情况被总结为 C10K 问题,它在早期的 Web 服务器中很常见,但在如今已经很少出现。
单线程 reactor
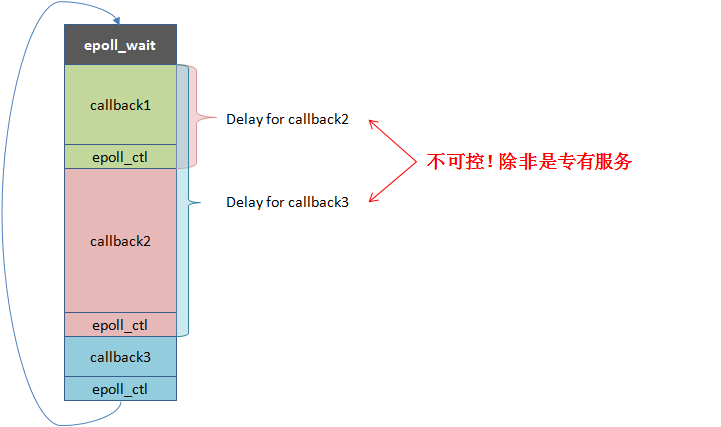
libevent、libev 等事件循环库是典型的例子。这种模型中通常有一个事件分发器,负责等待各种事件,并在事件发生时就地调用相应的事件处理器。当所有(需要被调用的)处理器都被调用完毕后,分发器再次等待更多事件,从而形成一个“循环”。本质上,这种模型把编写在不同处理器中的代码多路复用(交织)到一个系统线程中执行。一个事件循环只能利用一个核心,因此这类程序要么是 IO 密集型的,要么每个处理器都在较短且确定的时间内运行(例如 HTTP 服务器);否则,一个耗时的回调就会阻塞整个程序,导致高延迟。在实践中,这类程序不适合有众多开发者共同参与,因为只要一个人加入了不恰当的阻塞代码,就可能显著降低其他所有代码的响应速度。由于事件处理器不会同时运行,回调之间的竞态条件相对简单,在某些场景下甚至不需要加锁。这类程序通常通过使用更多线程或更多进程来扩展。
单线程 reactor 的工作方式及其相关问题如下所示:(红色中文字符:“不可控!除非服务是专用的”)
N:1 线程库
也称为 Fiber。典型的例子有 GNU Pth、StateThreads。这种模型将 N 个用户线程映射到一个系统线程中,同一时刻只有一个用户线程在运行,并且正在运行的用户线程在调用阻塞原语之前不会切换到其他用户线程(协作式)。N:1 线程库在能力上等同于单线程 reactor,区别只是用上下文(栈、寄存器、信号)取代了回调,运行回调变成了跳转到上下文。与事件循环库类似,N:1 线程库无法利用多个 CPU 核心,因此只适用于专用应用。不过,单个系统线程对 CPU 缓存更友好,去掉对信号屏蔽的支持后,用户线程之间的上下文切换可以非常快(100 ~ 200ns)。N:1 线程库的性能与事件循环库相当,通常也是通过使用更多线程或更多进程来扩展。
多线程 reactor
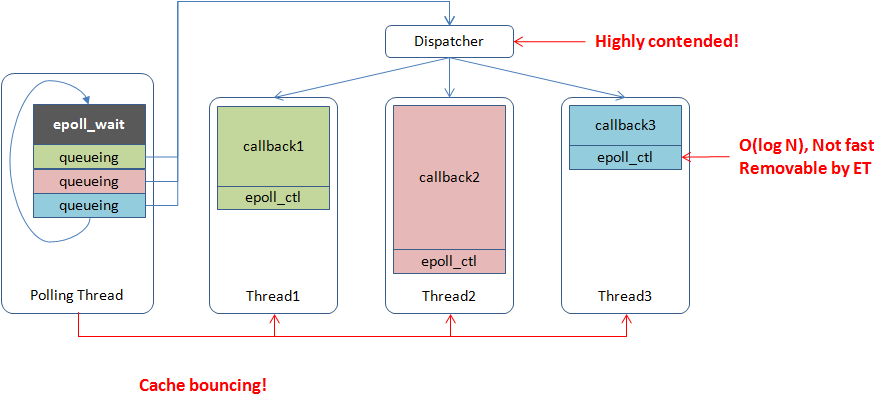
boost::asio](http://www.boost.org/doc/libs/1_56_0/doc/html/boost_asio.html) 就是一个典型的例子。一个或多个线程分别运行事件分发器。当事件发生时,事件处理器会被排入某个工作线程中执行。这种模型直观上是从单线程 reactor 扩展而来,同时能够利用多个 CPU 核心。由于共享内存地址使得线程之间的交互成本低得多,工作线程之间可以频繁地进行负载均衡;相比之下,多个单线程 reactor 基本上只能依赖前端服务器来分发流量。在同一条机器上,实现良好的多线程 reactor 往往比多个单线程 reactor 更能均匀地利用 CPU 核心。然而,由于缓存一致性,多线程 reactor 很难在 CPU 核心上实现线性扩展。在某些特定场景下,一个实现糟糕的多线程 reactor 运行在 24 个核心上,甚至比一个经过良好调优的单线程 reactor 还要慢。因为多线程 reactor 拥有多个工作线程,某个阻塞的事件处理器可能并不会拖慢其他处理器。所以,除非所有工作线程都被阻塞(此时整体进度会受到影响),事件处理器并不要求必须是非阻塞的。事实上,大多数 RPC 框架都是采用这种模型实现的,其事件处理器可能会阻塞,例如同步等待发往下游服务器的 RPC。
下图展示了多线程 reactor 的工作方式以及与之相关的问题:
M:N 线程库
该模型把 M 个用户线程映射到 N 个系统线程上。M:N 线程库能够决定一段代码在何时何地运行以及何时结束执行,因此在调度上比多线程 reactor 更加灵活。但功能完备的 M:N 线程库难以实现,至今仍是活跃的研究课题。我们这里所说的 M:N 线程库是专门为构建在线服务而设计的,因此其中一些需求可以简化,即不需要(完整的)抢占和优先级。M:N 线程库既可以在用户态实现,也可以在操作系统内核中实现。新编程语言倾向于在用户态实现,例如 GHC 线程和 goroutine,它们能够引入全新的关键字并拦截与线程相关的 API。在已有语言中的实现往往不得不修改操作系统内核,例如 Windows UMS 以及 Google 的 SwicthTo(不过它是 1:1 的,但可以基于它实现 M:N 的效果)。与 N:1 线程库相比,M:N 线程库的使用方式更接近系统线程,需要借助锁或消息传递来保证线程安全。
问题
多核可扩展性
理想情况下,当所有源代码都以事件驱动方式编写时,反应器(reactor)模型的能力可以得到最大程度的发挥。但在现实中,由于实现困难且不易维护,用户往往会混合使用各种方式:在回调中发起同步 IO,从而阻塞工作线程去处理其他请求。一个请求通常要经过几十个服务,使得工作线程将大量时间花费在等待下游服务器的响应上。用户不得不启动数百个线程来维持足够的吞吐量,这给调度带来了巨大的压力,并降低了 TLS 相关代码的效率。任务通常被推入一个由全局互斥量和条件变量保护的队列中,在多个线程争抢时性能很差。更好的做法是部署更多任务队列,并调整调度算法以减少全局争用。也就是说,每个系统线程都拥有自己的运行队列,由一个或多个调度器将用户线程分派到不同的运行队列中。每个系统线程优先运行自己运行队列中的用户线程,然后再考虑其他运行队列,这种方式比全局互斥量加条件变量的方案更复杂,但可扩展性更好。该模型也更容易支持 NUMA。
当事件分发器将任务交给工作线程时,用户代码可能会从一个 CPU 核心跳到另一个 CPU 核心,这可能需要等待相关缓存行的同步,速度并不快。如果工作线程能直接在事件分发器所在的 CPU 核心上运行会更好,因为在大多数时候,尽快运行工作线程的优先级高于从分发器获取新事件。同理,最好在接收响应的同一个 CPU 核心上唤醒阻塞在 RPC 上的用户线程。
异步编程
异步编程中的流程控制即使对专家来说也很困难。任何挂起操作,比如睡眠一段时间或等待某事完成,都意味着用户必须显式地保存状态并在回调中恢复状态。异步代码通常被写成状态机。少量的挂起虽有些麻烦,但仍可处理。问题在于,一旦挂起发生在条件、循环或子函数内部,就几乎不可能写出能被多人理解并维护的状态机,尽管这种场景在分布式系统中非常常见——一个节点通常需要同时与多个节点交互。此外,如果唤醒可以由多个事件触发(例如文件描述符有数据到达或超时到达),挂起与恢复就容易出现竞态条件,需要具备良好的多线程编程技巧才能解决。语法糖(如 lambda)只是让编码不那么麻烦,并没有降低难度。
智能指针在异步编程中很常见,看似方便,却也让内存的归属变得难以捉摸。如果发生内存泄漏,很难定位到忘记释放的那段代码;如果出现段错误,双释放发生的位置同样无从知晓。引用计数繁多的代码很难保持高质量,往往会耗费大量时间调试与内存相关的问题。如果还要手动维护引用计数,代码质量更难保证,维护者也更不愿意修改这样的代码。RAII 在异步编程的许多场景中无法使用:有时需要在回调之前加锁、在回调内部解锁,这在实践中非常容易出错。
最后修改于 2022 年 8 月 2 日:[ISSUE devlive-community/knowforge#82] 改进文档 (devlive-community/knowforge#83) (ebba480b6)]
评论
登录后参与评论