 KnowForge
概览
 qianmoQ· 更新于 2026-10-05· 阅读 17 分钟· 0 次阅读
bRPC 概览
bRPC 的基本介绍。
什么是 RPC?
互联网上的大多数机器通过 TCP/IP 进行通信。但 TCP/IP 只能保证可靠的数据传输。要构建服务,我们还需要做更多抽象:
- 数据传输的格式是什么?不同的机器和网络可能采用不同的字节序,直接发送内存中的数据并不合适。数据中的字段会逐渐增加、修改或删除,新版服务如何与旧版服务通信?
- TCP 连接能否被多个请求复用以减少开销?能否通过一条 TCP 连接同时发送多个请求?
- 如何与拥有众多机器的集群通信?
- 连接断开时应该怎么办?如果服务器没有响应怎么办?
- …
RPC 将网络通信抽象为“客户端访问服务器上的函数”来解决上述问题:客户端向服务器发送请求,等待服务器接收 -> 处理 -> 响应该请求,然后根据结果执行相应操作。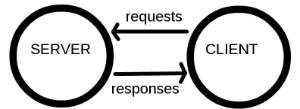
下面来看看这些问题是如何解决的。
- RPC 需要序列化,这由 protobuf 完成得相当不错。用户按照 protobuf::Message 的格式填写请求、发起 RPC,并从 protobuf::Message 格式的响应中获取结果。protobuf 具有良好的向前和向后兼容性,方便用户修改字段并逐步构建服务。对于 http 服务,json 被广泛用于序列化。
- 连接的建立与复用对用户是透明的,但用户可以选择 不同的连接类型:短连接、连接池、单连接。
- 机器由命名服务发现,命名服务可以基于 DNS、ZooKeeper 或 etcd 实现。在百度内部,我们使用 BNS(百度命名服务)。brpc 还提供了 “list://” 和 “file://” 两种方式。用户指定负载均衡算法,从所有机器中为每个请求选择一台机器,包括:轮询、随机、一致性哈希(murmurhash3 或 md5)以及 按地理位置感知。
- 连接断开时 RPC 会重试。当服务器在给定时间内没有响应时,客户端会以超时错误失败。
我可以在哪里使用 RPC?
几乎所有网络通信场景。
当然,RPC 并非万能,否则我们就不需要 TCP/IP 这一层了。但在大多数网络通信中,RPC 都能满足需求,并屏蔽底层细节。
对 RPC 的常见疑问:
- 我的数据是二进制的且体积很大,使用 protobuf 会很慢。首先,这可能只是一种错觉,你必须通过 profilers 进行测试并加以验证。其次,许多协议支持在携带 protobuf 请求的同时携带二进制数据,从而绕过序列化。
- 我在发送流式数据,RPC 无法处理。实际上 RPC 中的许多协议都能处理流式数据,包括 ProgressiveReader in http、h2 中的 streams、streaming rpc,以及专门的流媒体协议 RTMP。
- 我不需要回复。经过一些归纳推理可知,在你的场景中请求可能在任意阶段被丢弃,因为客户端始终对情况一无所知。你真的确定这样可以接受吗?即使你不需要回复,我们也建议返回小尺寸的回复,它们不太可能成为性能瓶颈,而且在调试复杂问题时很可能提供有价值的线索。
什么是  ?
brpc 是一个工业级的 RPC 框架,使用 C++ 语言编写,常用于搜索、存储、机器学习、广告、推荐等高性能系统。
你可以用它来:
构建可以使用多种协议通信的服务端(在同一个端口上),或访问各种各样的服务
- restful http/https、h2/gRPC。在 brpc 中使用 http/h2 比使用 libcurl 友好得多。使用 HTTP/h2+json 访问基于 protobuf 的协议,可能来自另一种语言。
- redis 和 memcached,线程安全,比官方客户端更友好、性能更好
- rtmp/flv/hls,用于构建 streaming services。
- hadoop_rpc(可能会开源)
- rdma 支持(将会开源)
- thrift 支持,线程安全,比官方客户端更友好、性能更好。
- 百度内部使用的各种协议:baidu_std、streaming_rpc、hulu_pbrpc、sofa_pbrpc、nova_pbrpc、public_pbrpc、ubrpc 以及基于 nshead 的协议。
- 使用工业级的 RAFT 共识算法 实现构建 HA 分布式服务,该实现在 braft 开源
客户端可以 同步、异步、半同步 访问服务端,或使用 combo channels 以声明式的方式简化分片或并行访问。
通过 http 调试服务,并运行 cpu、heap 和 contention 分析器。
获得 更低的延迟和更高的吞吐。
扩展 brpc 以快速支持你们组织使用的协议,或定制组件,包括 naming services(dns、zk、etcd)、load balancers(rr、random、一致性哈希)
bRPC 的优势
更友好的 API
只有 3 个(主要的)用户头文件:Server、Channel、Controller,分别对应服务端、客户端和参数设置。你不必操心"如何初始化 XXXManager"、"如何把所有这些组件分层组织起来"、"XXXController 和 XXXContext 之间是什么关系"。你需要做的很简单:
- 构建服务?包含 brpc/server.h 并按照注释或 示例 操作。
- 访问服务?包含 brpc/channel.h 并按照注释或 示例 操作。
- 调整参数?查看 brpc/controller.h。注意该类由 server 和 channel 共享,其中的方法分为三部分:client-side(客户端)、server-side(服务端)和 both-side(两端通用)。
我们努力让简单的事情保持简单。以命名服务为例,在其他 RPC 实现中,你可能需要复制一大堆晦涩的代码才能让它工作,而在 brpc 中,访问 BNS 表示为 Init("bns://node-name", ...),DNS 表示为 Init("http://domain-name", ...),本机列表表示为 Init("file:///home/work/server.list", ...)。无需任何解释,你就知道它是什么意思。
让服务更可靠
brpc 在百度被广泛使用:
- map-reduce 服务与表存储
- 高性能计算与模型训练
- 各类索引与排序服务器
- ….
这已经得到了充分验证。
brpc 特别关注开发与维护效率,你可以在浏览器中或用 curl 查看服务器的内部状态,分析线上服务的 cpu 热点、堆内存分配 和 锁竞争,通过 bvar 统计指标,这些指标可在 /vars 中查看。
更好的延迟与吞吐
尽管几乎所有 RPC 实现都自称"高性能",但那些数字可能只是数字而已。在不同场景下真正做到高性能是非常困难的。为了统一百度内部的通信基础设施,brpc 在性能方面的投入远比其他实现更加深入。
- 从不同客户端读取和解析请求完全并行化,用户无需区分「IO 线程」和「处理线程」。其他实现通常会有「IO 线程」和「处理线程」,并将文件描述符(fd)哈希到各个 IO 线程中。当某个 IO 线程正在处理它的一个 fd 时,该线程中的其他 fd 就无法得到处理。如果一条消息很大,其他 fd 就会被明显拖慢。虽然不同的 IO 线程是并行运行的,但 IO 线程的数量不会太多,因为除了从 fd 读取/解析之外它们没有太多工作可做。假设有 10 个 IO 线程,一个 fd 可能会影响全部 fd 的 10%,这对于要求 99.99% 可用性的工业级在线服务来说是不可接受的。如果 fd 在 IO 线程之间分布不均(不幸的是这很常见),或者服务是多租户的(云服务中很常见),问题会更加严重。在 brpc 中,从不同 fd 读取是并行的,甚至处理同一个 fd 上的不同消息也是并行的。解析一条大消息不会阻塞同一个 fd 上的其他消息,更不用说其他 fd 了。更多细节见这里]。
- 向单个 fd 和多个 fd 写入是高度并发的。当多个线程向同一个 fd 写入时(多路复用连接中很常见),第一个线程直接就地写入,其余线程则以无等待]的方式提交写请求。几个存在高度竞争的线程每秒可以向一个 fd 写入 5,000,000 条 16 字节的消息。更多细节见这里]。
- 极少的锁。高 QPS 服务可以充分利用机器上的全部 CPU 算力。例如,创建 bthread]处理请求、设置超时]、根据响应查找 RPC 上下文]、记录性能计数器]都是高度并发的。即使服务运行在 500,000+ QPS,用户通过锁竞争分析器]也几乎看不到 RPC 框架引起的锁竞争。
- 服务器根据负载调整线程数量。传统实现根据延迟来设定线程数量,以避免限制吞吐量。brpc 为每个请求创建一个新的 bthread],并在请求结束时销毁该 bthread,从而根据负载自动调整线程数量。
参见性能基准]了解 brpc 与其他实现的对比。
最后修改于 2023 年 1 月 10 日:移除 incubator(devlive-community/knowforge#122)(7647361c1)]
评论
登录后参与评论