 KnowForge
Hive
 qianmoQ· 更新于 2026-09-27· 阅读 11 分钟· 0 次阅读
Apache Atlas 的 Apache Hive 钩子与桥接
Hive 模型
Hive 模型包含以下类型:
实体类型:
hive_db
- 超类型:Asset
- 属性:qualifiedName、name、description、owner、clusterName、location、parameters、ownerName
hive_table
超类型:DataSet
属性:qualifiedName、name、description、owner、db、createTime、lastAccessTime、comment、retention、sd、partitionKeys、columns、aliases、parameters、viewOriginalText、viewExpandedText、tableType、temporary
hive_column
- 超类型:DataSet
- 属性:qualifiedName、name、description、owner、type、comment、table
hive_storagedesc
- 超类型:Referenceable
- 属性:qualifiedName、table、location、inputFormat、outputFormat、compressed、numBuckets、serdeInfo、bucketCols、sortCols、parameters、storedAsSubDirectories
hive_process
- 超类型:Process
- 属性:qualifiedName、name、description、owner、inputs、outputs、startTime、endTime、userName、operationType、queryText、queryPlan、queryId、clusterName
hive_column_lineage
- 超类型:Process
- 属性:qualifiedName、name、description、owner、inputs、outputs、query、depenendencyType、expression
枚举类型:
hive_principal_type
- 取值:USER、ROLE、GROUP
结构体类型:
hive_order
- 属性:col、order
hive_serde
- 属性:name、serializationLib、parameters
Hive 实体在 Atlas 中通过唯一属性 qualifiedName 进行创建与去重,其取值应按如下格式确定。请注意,dbName、tableName 和 columnName 应使用小写字母。
hive_db.qualifiedName:     <dbName>@<clusterName>
hive_table.qualifiedName:  <dbName>.<tableName>@<clusterName>
hive_column.qualifiedName: <dbName>.<tableName>.<columnName>@<clusterName>
hive_process.queryString:  trimmed query string in lower case
Hive Hook
Atlas Hive hook 会注册到 Hive 中,监听创建/更新/删除操作,并通过 Kafka 通知将 Hive 中的变更元数据更新到 Atlas。请按照以下步骤在 Hive 中设置 Atlas hook:
- 在 hive-site.xml 中添加以下内容来设置 Atlas hook:
<property>
    <name>hive.exec.post.hooks</name>
      <value>org.apache.atlas.hive.hook.HiveHook</value>
</property>- 解压 apache-atlas-${project.version}-hive-hook.tar.gz
- cd apache-atlas-hive-hook-${project.version}
- 将文件夹 apache-atlas-hive-hook-${project.version}/hook/hive 中的全部内容复制到
<atlas package>/hook/hive - 在 Hive 配置的 hive-env.sh 中添加
export HIVE_AUX_JARS_PATH=<atlas package>/hook/hive - 将
<atlas-conf>/atlas-application.properties 复制到 hive 的 conf 目录中。
atlas-application.properties 中的以下属性用于控制线程池和通知相关设置:
atlas.hook.hive.synchronous=false # whether to run the hook synchronously. false is recommended to avoid delays in Hive query completion. Default: false
atlas.hook.hive.numRetries=3      # number of retries for notification failure. Default: 3
atlas.hook.hive.queueSize=10000   # queue size for the threadpool. Default: 10000
atlas.cluster.name=primary # clusterName to use in qualifiedName of entities. Default: primary
atlas.kafka.zookeeper.connect=                    # Zookeeper connect URL for Kafka. Example: localhost:2181
atlas.kafka.zookeeper.connection.timeout.ms=30000 # Zookeeper connection timeout. Default: 30000
atlas.kafka.zookeeper.session.timeout.ms=60000    # Zookeeper session timeout. Default: 60000
atlas.kafka.zookeeper.sync.time.ms=20             # Zookeeper sync time. Default: 20
Kafka 通知生产者的其他配置可以通过在配置名称前加上 "atlas.kafka." 来指定。有关 Kafka 生产者支持的配置列表,请参阅 Kafka Producer Configs
列级血缘
从 Atlas 的 0.8-incubating 版本开始,Atlas 会捕获列级血缘信息。详情如下:
模型
ColumnLineageProcess 类型是 Process 的子类型
它将一个输出列与一组输入列或输入表关联起来
血缘信息还会捕获依赖的类型,如下所列:
- SIMPLE:输出列与输入列具有相同的值
- EXPRESSION:输出列在运行时由某个表达式对输入列进行转换(例如 Hive SQL 表达式)
- SCRIPT:输出列由用户提供的脚本进行转换
对于 EXPRESSION 类型的依赖,expression 属性以字符串形式包含该表达式
由于 Process 连接输入和输出数据集(DataSet),因此 Column 是 DataSet 的子类型
示例
对于如下的简单 CTAS:
create table t2 as select id, name from T1血缘关系以如下方式捕获:
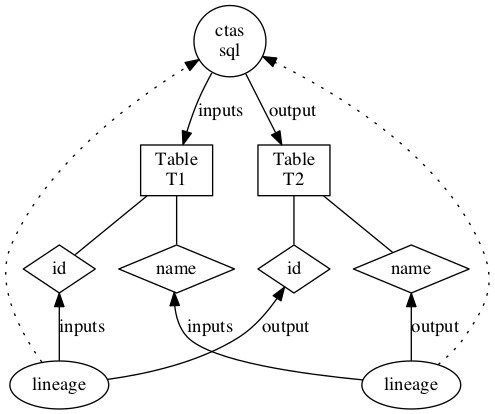
从 Hive 命令中提取血缘
- HiveHook 将 HookContext 中的 LineageInfo 映射为列级血缘实例
- Hive 中的 LineageInfo 提供最终 FileSinkOperator 的列级血缘,并将其关联到 Hive 查询中的输入列
注意事项
列级血缘适用于 Hive 版本 1.2.1,但需要将 HIVE-13112 的补丁应用到 Hive 源代码
由于 Hive 中的数据库名、表名和列名不区分大小写,实体中的对应名称均为小写。因此,查询实体名称时,所有搜索 API 都应使用小写
目前 Hive hook 会捕获以下 Hive 操作
- create database
- create table/view、create table as select
- load、import、export
- DML(insert)
- alter database
- alter table(不支持倾斜表信息、stored as、protection)
- alter view
导入 Hive 元数据
Apache Atlas 提供了一个命令行工具 import-hive.sh,用于将 Apache Hive 数据库和表的元数据导入 Apache Atlas。可以使用该工具,利用 Apache Hive 中已有的数据库/表来初始化 Apache Atlas。该工具支持导入特定表、特定数据库中的表或所有数据库和表的元数据。
Usage 1: <atlas package>/hook-bin/import-hive.sh
Usage 2: <atlas package>/hook-bin/import-hive.sh [-d <database regex> OR --database <database regex>] [-t <table regex> OR --table <table regex>]
Usage 3: <atlas package>/hook-bin/import-hive.sh [-f <filename>]
           File Format:
             database1:tbl1
             database1:tbl2
             database2:tbl1
评论
登录后参与评论