 KnowForge
组合通道
 qianmoQ· 更新于 2026-10-05· 阅读 40 分钟· 0 次阅读
Combo 通道
bRPC 中的 channel 是什么?
随着服务规模的增长,对下游服务器的访问模式变得日益复杂,往往包含多个并行 RPC 或分层访问。这种复杂性很容易引入多线程编程方面的棘手缺陷,用户可能根本察觉不到,也难以调试和复现。此外,现有实现要么只支持同步模式,要么为异步模式编写了完全不同的代码。以在多个异步 RPC 完成之后执行某段代码为例,同步模式通常是异步发出多个 RPC 并分别等待其完成,而异步模式通常用一个回调加一个引用计数来实现,每当一个 RPC 完成就将计数减一,当计数归零时调用该回调。下面看看这种方案的缺点:
- 同步模式与异步模式之间的代码不一致,用户想从一种模式迁移到另一种模式并不容易。从设计的角度来看,不一致往往意味着还没有抓住本质。
- 难以支持取消。正确取消单个 RPC 就不容易,更不用说多个 RPC 的组合了。然而在许多场景中,取消是终止无意义等待所必需的。
- 不可组合。很难把上述实现封装为某个「更大」模式的一部分,代码也很难在其他场景下复用。
我们需要更好的抽象。如果把若干个通道组合成一个更大的通道,并在其中封装不同的访问模式,用户就能通过一致、统一的接口执行同步、异步、取消等操作。这类通道在 bRPC 中被称为 combo 通道。
ParallelChannel
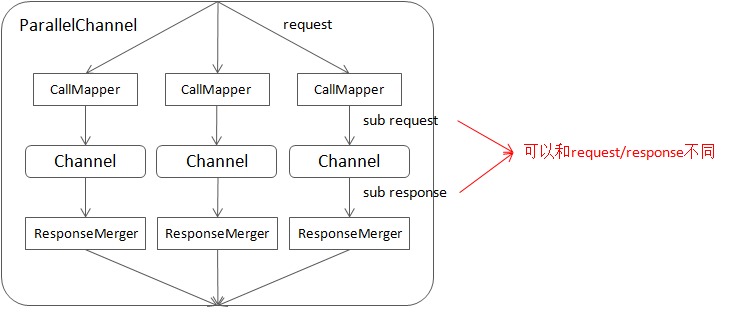
ParallelChannel(有时简称为 “pchan”)会并行地向其内部的所有子通道发送请求,并合并响应。用户可以通过 CallMapper 修改请求,并通过 ResponseMerger 合并响应。ParallelChannel 的行为类似于 Channel:
- 支持同步和异步访问。
- 发起异步操作后可以立即销毁。
- 支持取消。
- 支持超时。
参见 example/parallel_echo_c++](https://github.com/brpc/brpc/tree/master/example/parallel_echo_c++/) 中的示例。
brpc::ChannelBase 的任何子类都可以被添加到 ParallelChannel 中,包括 ParallelChannel 以及其他 combo 通道。设置 ParallelChannelOptions.fail_limit 可以控制允许的最大失败次数。当失败响应的数量达到该上限时,RPC 会立即结束,而不必等待超时。
同一个 ParallelChannel 可以被添加多个子通道,当你需要向同一服务发起多个异步 RPC 并等待它们全部完成时,这一点非常有用。
下图展示了 ParallelChannel 的内部结构(红色中文部分:可以分别与请求/响应不同):
添加子通道
可以通过以下 API 将子通道添加到 ParallelChannel 中:
int AddChannel(brpc::ChannelBase* sub_channel,
               ChannelOwnership ownership,
               CallMapper* call_mapper,
               ResponseMerger* response_merger);
当 ownership 为 brpc::OWNS_CHANNEL 时,sub_channel 会在 ParallelChannel 析构时被销毁。虽然一个子通道可以被多次加入到一个 ParallelChannel 中,但当 ownership 为 brpc::OWNS_CHANNEL 时,它最多只会被删除一次。
在通过 ParallelChannel 进行 RPC 调用期间调用 AddChannel 是非线程安全的。
CallMapper
该类将发往 ParallelChannel 的 RPC 转换为发往 sub channel 的 RPC。如果 call_mapper 为 NULL,则发往子通道的请求就是发往 ParallelChannel 的请求,而响应则是通过对发往 ParallelChannel 的响应调用 New() 来创建的。call_mapper 会在 ParallelChannel 析构时被销毁。由于内部的引用计数机制,一个 call_mapper 可以关联到多个子通道。
class CallMapper {
public:
    virtual ~CallMapper();

    virtual SubCall Map(int channel_index/*starting from 0*/,
                        const google::protobuf::MethodDescriptor* method,
                        const google::protobuf::Message* request,
                        google::protobuf::Message* response) = 0;
};channel_index:子通道在 ParallelChannel 中的位置,从零开始。
method/request/response:传递给 ParallelChannel::CallMethod() 的参数。
返回的 SubCall 用于配置对相应子通道的调用,有两个特殊取值:
SubCall::Bad():对 ParallelChannel 的调用立即失败,并将Controller::ErrorCode()设置为EREQUEST。SubCall::Skip():跳过对该子通道的调用。如果所有子通道都被跳过,则对 ParallelChannel 的调用立即失败,并将Controller::ErrorCode()设置为ECANCELED。
Map() 的常见实现列举如下:
- 广播请求。当
call_mapper为 NULL 时也是这种行为:
  class Broadcaster : public CallMapper {
  public:
      SubCall Map(int channel_index/*starting from 0*/,
                  const google::protobuf::MethodDescriptor* method,
                  const google::protobuf::Message* request,
                  google::protobuf::Message* response) {
          // Use the method/request to pchan.
          // response is created by `new` and the last flag tells pchan to delete response after completion of the RPC
          return SubCall(method, request, response->New(), DELETE_RESPONSE);
      }
};- 在发送请求前修改其中的部分字段:
  class ModifyRequest : public CallMapper {
  public:
    SubCall Map(int channel_index/*starting from 0*/,
                const google::protobuf::MethodDescriptor* method,
                const google::protobuf::Message* request,
                google::protobuf::Message* response) {
        FooRequest* copied_req = brpc::Clone<FooRequest>(request);
        copied_req->set_xxx(...);
        // Copy and modify the request
        // The last flag tells pchan to delete the request and response after completion of the RPC
        return SubCall(method, copied_req, response->New(), DELETE_REQUEST | DELETE_RESPONSE);
    }
};- request/response 中已经包含子请求/子响应,直接使用即可。
  class UseFieldAsSubRequest : public CallMapper {
  public:
    SubCall Map(int channel_index/*starting from 0*/,
                const google::protobuf::MethodDescriptor* method,
                const google::protobuf::Message* request,
                google::protobuf::Message* response) {
        if (channel_index >= request->sub_request_size()) {
            // Not enough sub_request. The caller doesn't provide same number of requests as number of sub channels in pchan
            // Return Bad() to end this RPC immediately
            return SubCall::Bad();
        }
        // Fetch the sub request and add a new sub response.
        // The last flag(0) tells pchan that there is nothing to delete.
        return SubCall(sub_method, request->sub_request(channel_index), response->add_sub_response(), 0);
    }
  };
ResponseMerger
response_merger 将所有子 channel 的响应合并为一个,供 ParallelChannel 使用。当其为 NULL 时,将使用 response->MergeFrom(*sub_response),其行为可概括为"合并重复字段,其余字段覆盖"。若需要更复杂的行为,请实现 ResponseMerger。多个 response_merger 会被依次调用来合并各个子响应,这样你就不必考虑同时合并多个响应时的竞态条件。该对象会在 ParallelChannel 析构时被删除。由于内部使用了引用计数,response_merger 可以关联到多个子 channel。
Result 的可能取值如下:
- MERGED:合并成功。
- FAIL:该
sub_response未合并成功,计为一次失败。例如,有 10 个子 channel 且fail_limit为 4,如果有 4 次合并返回 FAIL,该 RPC 将达到 fail_limit 并很快结束。 - FAIL_ALL:直接使 RPC 失败。
获取各子 channel 的 controller
有时用户可能需要了解子调用的相关细节。Controller.sub(i) 会获取与某个子 channel 对应的 controller。
// Get the controllers for accessing sub channels in combo channels.
// Ordinary channel:
//   sub_count() is 0 and sub() is always NULL.
// ParallelChannel/PartitionChannel:
//   sub_count() is #sub-channels and sub(i) is the controller for
//   accessing i-th sub channel inside ParallelChannel, if i is outside
//    [0, sub_count() - 1], sub(i) is NULL.
//   NOTE: You must test sub() against NULL, ALWAYS. Even if i is inside
//   range, sub(i) can still be NULL:
//   * the rpc call may fail and terminate before accessing the sub channel
//   * the sub channel was skipped
// SelectiveChannel/DynamicPartitionChannel:
//   sub_count() is always 1 and sub(0) is the controller of successful
//   or last call to sub channels.
int sub_count() const;
const Controller* sub(int index) const;
SelectiveChannel
SelectiveChannel(有时简称为 “schan”)通过负载均衡算法访问其内部的某个子 channel。与普通 channel 相比,它更加高层:请求被发送到子 channel,而不是直接发送给服务器。SelectiveChannel 主要用于机器分组之间的负载均衡,并共享 Channel 的基本特性:
- 支持同步和异步访问。
- 发起异步操作后可以立即销毁。
- 支持取消。
- 支持超时。
参见 example/selective_echo_c++ 获取示例。
brpc::ChannelBase 的任意子类都可以被加入到 SelectiveChannel 中,包括 SelectiveChannel 以及其他组合 channel。
SelectiveChannel 所做的重试与其子 channel 中的重试相互独立。当对某个子 channel 的调用失败(该调用可能已经重试过)时,会继续尝试其他子 channel。
目前 SelectiveChannel 要求请求在 RPC 完成之前保持有效,而其他组合 channel 或普通 channel 则没有这一要求。如果你打算异步使用 SelectiveChannel,请确保请求是在 done 内部被删除的。
使用 SelectiveChannel
SelectiveChannel 的初始化方式与普通的 Channel 几乎完全相同,只是它在 Init 中不需要命名服务,因为 SelectiveChannel 通过 AddChannel 动态添加子 channel,而普通的 Channel 则向命名服务中添加服务器。
#include <brpc/selective_channel.h>
...
brpc::SelectiveChannel schan;
brpc::ChannelOptions schan_options;
schan_options.timeout_ms = ...;
schan_options.backup_request_ms = ...;
schan_options.max_retry = ...;
if (schan.Init(load_balancer, &schan_options) != 0) {
    LOG(ERROR) << "Fail to init SelectiveChannel";
    return -1;
}
初始化成功后,使用 AddChannel 添加子通道。
// The second parameter ChannelHandle is used to delete sub channel,
// which can be NULL if this isn't necessary.
if (schan.AddChannel(sub_channel, NULL/*ChannelHandle*/) != 0) {
    LOG(ERROR) << "Fail to add sub_channel";
    return -1;
}
注意:
- 与
ParallelChannel不同,SelectiveChannel::AddChannel可以在任何时候被调用,即使 SelectiveChannel 上正在进行 RPC。(新增的通道将在下一次 RPC 时生效)。 SelectiveChannel始终拥有子通道的所有权,这与ParallelChannel可配置的所有权不同。- 如果
AddChannel的第二个参数不为 NULL,则会填入一个brpc::SelectiveChannel::ChannelHandle类型的值,该值可用作RemoveAndDestroyChannel的参数,以动态移除并销毁某个通道。 SelectiveChannel会覆盖子通道中的超时设置。例如,为某子通道设置超时为 100ms,为SelectiveChannel设置超时为 500ms,则实际超时为 500ms。
SelectiveChannel 的访问方式与普通通道相同。
示例:将流量分配到多个命名服务
有时我们需要将流量分配到多个命名服务,原因如下:
- 同一服务的机器在多个命名服务中列出。
- 机器被划分为多个分组。请求发送到其中一个分组,然后再路由到该分组内的一台机器,且流量在分组之间以及分组内的机器之间按不同方式分配。
上述需求可以通过 SelectiveChannel 实现。
以下代码创建了一个 SelectiveChannel,并分别插入了 3 个指向不同命名服务的普通通道。
brpc::SelectiveChannel channel;
brpc::ChannelOptions schan_options;
schan_options.timeout_ms = FLAGS_timeout_ms;
schan_options.max_retry = FLAGS_max_retry;
if (channel.Init("c_murmurhash", &schan_options) != 0) {
    LOG(ERROR) << "Fail to init SelectiveChannel";
    return -1;
}

for (int i = 0; i < 3; ++i) {
    brpc::Channel* sub_channel = new brpc::Channel;
    if (sub_channel->Init(ns_node_name[i], "rr", NULL) != 0) {
        LOG(ERROR) << "Fail to init sub channel " << i;
        return -1;
    }
    if (channel.AddChannel(sub_channel, NULL/*handle for removal*/) != 0) {
        LOG(ERROR) << "Fail to add sub_channel to channel";
        return -1;
    }
}
...
XXXService_Stub stub(&channel);
stub.FooMethod(&cntl, &request, &response, NULL);
...
PartitionChannel
PartitionChannel 是一种专门的 ParallelChannel,它会根据命名服务中定义的标签自动添加子通道。这样一来,用户可以在一个命名服务中列出所有机器,并按标签对它们进行划分。示例请参见 example/partition_echo_c++。
ParititonChannel 只支持一种分区方式。当需要多种方式共存,或者需要将一种方式平滑地切换为另一种方式时,可以使用 DynamicPartitionChannel:它会为不同的分区方式创建相应的子 PartitionChannel,并按照服务器的容量将流量分配到各个分区。示例请参见 example/dynamic_partition_echo_c++。
如果各个分区列在不同的命名服务中,用户就必须通过 ParallelChannel 自行实现分区,并分别将子通道关联到对应的命名服务。关于 ParellelChannel 的用法,请参考上一节。
使用 PartitionChannel
首先,实现你自己的 PartitionParser。在本例中,标签的格式为 N/M,其中 N 是分区的序号,M 是分区的总数。0/3 表示共有 3 个分区,而这是其中的第一个。
#include <brpc/partition_channel.h>
...
class MyPartitionParser : public brpc::PartitionParser {
public:
    bool ParseFromTag(const std::string& tag, brpc::Partition* out) {
        // "N/M" : #N partition of M partitions.
        size_t pos = tag.find_first_of('/');
        if (pos == std::string::npos) {
            LOG(ERROR) << "Invalid tag=" << tag;
            return false;
        }
        char* endptr = NULL;
        out->index = strtol(tag.c_str(), &endptr, 10);
        if (endptr != tag.data() + pos) {
            LOG(ERROR) << "Invalid index=" << butil::StringPiece(tag.data(), pos);
            return false;
        }
        out->num_partition_kinds = strtol(tag.c_str() + pos + 1, &endptr, 10);
        if (endptr != tag.c_str() + tag.size()) {
            LOG(ERROR) << "Invalid num=" << tag.data() + pos + 1;
            return false;
        }
        return true;
    }
};
然后初始化 PartitionChannel。
#include <brpc/partition_channel.h>
...
brpc::PartitionChannel channel;

brpc::PartitionChannelOptions options;
options.protocol = ...;   // PartitionChannelOptions inherits ChannelOptions
options.timeout_ms = ...; // Same as above
options.fail_limit = 1;   // PartitionChannel's own settting, which means the same as that of
                          // ParalellChannel. fail_limit=1 means the overall RPC will fail
                          // as long as only 1 paratition fails

if (channel.Init(num_partition_kinds, new MyPartitionParser(),
                 server_address, load_balancer, &options) != 0) {
    LOG(ERROR) << "Fail to init PartitionChannel";
    return -1;
}
// The RPC interface is the same as regular Channel
使用 DynamicPartitionChannel
DynamicPartitionChannel 和 PartitionChannel 在用法上基本相同。先实现 PartitionParser,然后初始化 channel,这不需要 num_partition_kinds,因为 DynamicPartitionChannel 会为每个分区动态创建子 PartitionChannel。
下面的章节演示如何使用 DynamicPartitionChannel 将分区数从 3 个平滑迁移到 4 个。
首先,启动 3 个服务器,分别监听端口 8004、8005、8006。
$ ./echo_server -server_num 3
TRACE: 09-06 10:40:39:   * 0 server.cpp:159] EchoServer is serving on port=8004
TRACE: 09-06 10:40:39:   * 0 server.cpp:159] EchoServer is serving on port=8005
TRACE: 09-06 10:40:39:   * 0 server.cpp:159] EchoServer is serving on port=8006
TRACE: 09-06 10:40:40:   * 0 server.cpp:192] S[0]=0 S[1]=0 S[2]=0 [total=0]
TRACE: 09-06 10:40:41:   * 0 server.cpp:192] S[0]=0 S[1]=0 S[2]=0 [total=0]
TRACE: 09-06 10:40:42:   * 0 server.cpp:192] S[0]=0 S[1]=0 S[2]=0 [total=0]
注意每个服务器都会打印过去一秒接收到的流量摘要,目前全部为 0。
使用 DynamicPartitionChannel 启动一个客户端,其初始化方式如下:
    ...
    brpc::DynamicPartitionChannel channel;
    brpc::PartitionChannelOptions options;
    // Failure on any single partition fails the RPC immediately. You can use a more relaxed value
    options.fail_limit = 1;
    if (channel.Init(new MyPartitionParser(), "file://server_list", "rr", &options) != 0) {
        LOG(ERROR) << "Fail to init channel";
        return -1;
    }
    ...
命名服务 file://server_list 中的内容为:
0.0.0.0:8004  0/3  # The first partition of the three
0.0.0.0:8004  1/3  # and so forth
0.0.0.0:8004  2/3
所有 3 个分片都部署在 8004 端口的服务器上,因此客户端启动后即开始向 8004 端口发送请求。
$ ./echo_client
TRACE: 09-06 10:51:10:   * 0 src/brpc/policy/file_naming_service.cpp:83] Got 3 unique addresses from `server_list'
TRACE: 09-06 10:51:10:   * 0 src/brpc/socket.cpp:779] Connected to 0.0.0.0:8004 via fd=3 SocketId=0 self_port=46544
TRACE: 09-06 10:51:11:   * 0 client.cpp:226] Sending EchoRequest at qps=132472 latency=371
TRACE: 09-06 10:51:12:   * 0 client.cpp:226] Sending EchoRequest at qps=132658 latency=370
TRACE: 09-06 10:51:13:   * 0 client.cpp:226] Sending EchoRequest at qps=133208 latency=369
同时,由于 3 个分区,8004 端口上的服务器接收到了三倍的流量。
TRACE: 09-06 10:51:11:   * 0 server.cpp:192] S[0]=398866 S[1]=0 S[2]=0 [total=398866]
TRACE: 09-06 10:51:12:   * 0 server.cpp:192] S[0]=398117 S[1]=0 S[2]=0 [total=398117]
TRACE: 09-06 10:51:13:   * 0 server.cpp:192] S[0]=398873 S[1]=0 S[2]=0 [total=398873]
在端口为 8005 的服务器上新增 4 个分区。
0.0.0.0:8004  0/3
0.0.0.0:8004  1/3
0.0.0.0:8004  2/3

0.0.0.0:8005  0/4
0.0.0.0:8005  1/4
0.0.0.0:8005  2/4
0.0.0.0:8005  3/4
注意摘要是如何变化的。客户端感知到 server_list 的修改并重新加载它,但 QPS 几乎没有变化。
TRACE: 09-06 10:57:10:   * 0 src/brpc/policy/file_naming_service.cpp:83] Got 7 unique addresses from `server_list'
TRACE: 09-06 10:57:10:   * 0 src/brpc/socket.cpp:779] Connected to 0.0.0.0:8005 via fd=7 SocketId=768 self_port=39171
TRACE: 09-06 10:57:11:   * 0 client.cpp:226] Sending EchoRequest at qps=135346 latency=363
TRACE: 09-06 10:57:12:   * 0 client.cpp:226] Sending EchoRequest at qps=134201 latency=366
TRACE: 09-06 10:57:13:   * 0 client.cpp:226] Sending EchoRequest at qps=137627 latency=356
TRACE: 09-06 10:57:14:   * 0 client.cpp:226] Sending EchoRequest at qps=136775 latency=359
TRACE: 09-06 10:57:15:   * 0 client.cpp:226] Sending EchoRequest at qps=139043 latency=353
服务端的汇总变化更为明显。8005 端口上的服务器已经收到请求,发往 8004 与 8005 的流量比例大约为 3:4。
TRACE: 09-06 10:57:09:   * 0 server.cpp:192] S[0]=398597 S[1]=0 S[2]=0 [total=398597]
TRACE: 09-06 10:57:10:   * 0 server.cpp:192] S[0]=392839 S[1]=0 S[2]=0 [total=392839]
TRACE: 09-06 10:57:11:   * 0 server.cpp:192] S[0]=334704 S[1]=83219 S[2]=0 [total=417923]
TRACE: 09-06 10:57:12:   * 0 server.cpp:192] S[0]=206215 S[1]=273873 S[2]=0 [total=480088]
TRACE: 09-06 10:57:13:   * 0 server.cpp:192] S[0]=204520 S[1]=270483 S[2]=0 [total=475003]
TRACE: 09-06 10:57:14:   * 0 server.cpp:192] S[0]=207055 S[1]=273725 S[2]=0 [total=480780]
TRACE: 09-06 10:57:15:   * 0 server.cpp:192] S[0]=208453 S[1]=276803 S[2]=0 [total=485256]
8004 与 8005 之间的流量比例为 3:4,考虑到每次 RPC 需要向 8004 发起 3 次调用或向 8005 发起 4 次调用,客户端以 1:1 的比例同时使用两种分片方式发起请求,具体取决于按递归方式计算出的容量:
- 普通
Channel的容量等于其寻址的各台服务器容量之和。如果命名服务没有配置权重,则服务器容量默认为 1。 ParallelChannel或PartitionChannel的容量等于其所有子通道容量的最小值。SelectiveChannel的容量等于其所有子通道容量之和。DynamicPartitionChannel的容量等于其所有子PartitionChannel容量之和。
在本例中,3 分片方式和 4 分片方式的容量均为 1,因为 3 个分片全部位于 8004 上的服务器,4 个分片全部位于 8005 上的服务器。
将 8006 上的服务器加入 4 分片方式:
0.0.0.0:8004  0/3
0.0.0.0:8004  1/3
0.0.0.0:8004  2/3

0.0.0.0:8005  0/4
0.0.0.0:8005  1/4
0.0.0.0:8005  2/4
0.0.0.0:8005  3/4

0.0.0.0:8006 0/4
0.0.0.0:8006 1/4
0.0.0.0:8006 2/4
0.0.0.0:8006 3/4
客户端仍然几乎不变。
TRACE: 09-06 11:11:51:   * 0 src/brpc/policy/file_naming_service.cpp:83] Got 11 unique addresses from `server_list'
TRACE: 09-06 11:11:51:   * 0 src/brpc/socket.cpp:779] Connected to 0.0.0.0:8006 via fd=8 SocketId=1280 self_port=40759
TRACE: 09-06 11:11:51:   * 0 client.cpp:226] Sending EchoRequest at qps=131799 latency=372
TRACE: 09-06 11:11:52:   * 0 client.cpp:226] Sending EchoRequest at qps=136217 latency=361
TRACE: 09-06 11:11:53:   * 0 client.cpp:226] Sending EchoRequest at qps=133531 latency=368
TRACE: 09-06 11:11:54:   * 0 client.cpp:226] Sending EchoRequest at qps=136072 latency=361
观察服务端 8006 上的流量。3 分片方式的容量仍为 1,而 4 分片方式的容量因新增了 8006 上的服务实例而提升为 2,因此两种方式之间的总体比例变为 3:8。4 分片方式中的每个分片分别在 8005 和 8006 上各有 2 个实例,二者之间采用轮询负载均衡来分摊流量。最终,3 台服务器之间的流量比例变为 3:4:4。
TRACE: 09-06 11:11:51:   * 0 server.cpp:192] S[0]=199625 S[1]=263226 S[2]=0 [total=462851]
TRACE: 09-06 11:11:52:   * 0 server.cpp:192] S[0]=143248 S[1]=190717 S[2]=159756 [total=493721]
TRACE: 09-06 11:11:53:   * 0 server.cpp:192] S[0]=133003 S[1]=178328 S[2]=178325 [total=489656]
TRACE: 09-06 11:11:54:   * 0 server.cpp:192] S[0]=135534 S[1]=180386 S[2]=180333 [total=496253]
看看如果三分区方法中的一个分区被移除会发生什么:(你可以在 file://server_list 中用 # 注释掉一行)
 0.0.0.0:8004  0/3
 0.0.0.0:8004  1/3
#0.0.0.0:8004  2/3

 0.0.0.0:8005  0/4
 0.0.0.0:8005  1/4
 0.0.0.0:8005  2/4
 0.0.0.0:8005  3/4

 0.0.0.0:8006 0/4
 0.0.0.0:8006 1/4
 0.0.0.0:8006 2/4
 0.0.0.0:8006 3/4
客户端感知 server_list 中的变化:
TRACE: 09-06 11:17:47:   * 0 src/brpc/policy/file_naming_service.cpp:83] Got 10 unique addresses from `server_list'
TRACE: 09-06 11:17:47:   * 0 client.cpp:226] Sending EchoRequest at qps=131653 latency=373
TRACE: 09-06 11:17:48:   * 0 client.cpp:226] Sending EchoRequest at qps=120560 latency=407
TRACE: 09-06 11:17:49:   * 0 client.cpp:226] Sending EchoRequest at qps=124100 latency=395
TRACE: 09-06 11:17:50:   * 0 client.cpp:226] Sending EchoRequest at qps=123743 latency=397
8004 端口上的流量在服务端迅速降为零。原因是,一旦移除了最后的三分之二分区,三分区方法就不再完整了。容量变为零,因此不再有请求发送到 8004 端口的服务器。
TRACE: 09-06 11:17:47:   * 0 server.cpp:192] S[0]=130864 S[1]=174499 S[2]=174548 [total=479911]
TRACE: 09-06 11:17:48:   * 0 server.cpp:192] S[0]=20063 S[1]=230027 S[2]=230098 [total=480188]
TRACE: 09-06 11:17:49:   * 0 server.cpp:192] S[0]=0 S[1]=245961 S[2]=245888 [total=491849]
TRACE: 09-06 11:17:50:   * 0 server.cpp:192] S[0]=0 S[1]=250198 S[2]=250150 [total=500348]
在真实的线上环境中,我们使用 4 分区方案逐步增加实例,并通过 3 分区方案逐步减少实例。DynamicParititonChannel 会根据所有分区的容量动态分配流量。当 3 分区方案的容量降至 0 时,我们已在不修改客户端代码的情况下,将全部服务器从 3 分区平滑迁移至 4 分区。
最后修改于 2022 年 1 月 30 日:bRPC 网站 1.0 (92b925e8f)
评论
登录后参与评论