 KnowForge
基础
 qianmoQ· 更新于 2026-10-05· 阅读 82 分钟· 0 次阅读
基础
学习如何使用 bRPC 客户端。
示例
客户端代码(echo 示例)。
快速要点
- Channel.Init() 不是线程安全的。
- Channel.CallMethod() 是线程安全的,一个 Channel 可以被多个线程同时使用。
- Channel 可以放在栈上。
- 发送异步请求后即可立即析构 Channel。
- 不存在名为 brpc::Client 的类。
Channel
RPC 的客户端负责发送请求。在 brpc 中,它被称为 Channel 而非“Client”。channel 表示到一台或多台服务器的通信线路,可用于调用服务。
一个 Channel 可以被进程内的所有线程共享。你不必为每个线程创建单独的 Channel,也不需要用锁来同步 Channel.CallMethod。但是 Channel 的创建和销毁不是线程安全的,请确保 channel 只由一个线程初始化和销毁。
某些 RPC 实现有所谓的“ClientManager”,包含客户端侧的配置与资源管理,而 brpc 不需要它。“thread-num”、“connection-type” 这类参数要么位于 brpc::ChannelOptions 中,要么是全局 gflags。这样做有如下好处:
- 方便。创建 Channel 时不必传入“ClientManager”,也不必保存“ClientManager”。否则代码就得层层传递“ClientManager”,非常麻烦。gflags 让全局行为的配置更加容易。
- 共享资源。例如,brpc 中的 server 和 channel 共享后台工作线程(bthread)。
- 更好地管理生命周期。析构一个“ClientManager”非常容易出错,而现在由 brpc 统一管理。
与大多数类一样,Channel 在使用前必须先 Init()。当 options 为 NULL 时,参数取默认值。如果需要非默认值,请按如下方式编写:
brpc::ChannelOptions options;  // including default values
options.xxx = yyy;
...
channel.Init(..., &options);
请注意,Init() 完成后,Channel 既不会修改 options,也不会访问 options,因此如上面的代码所示,可以安全地将 options 放在栈上。Channel.options() 返回 Channel 正在使用的 options。
Init() 可以连接单个服务器,也可以连接一个集群(多个服务器)。
连接到单个服务器
// Take default values when options is NULL.
int Init(EndPoint server_addr_and_port, const ChannelOptions* options);
int Init(const char* server_addr_and_port, const ChannelOptions* options);
int Init(const char* server_addr, int port, const ChannelOptions* options);
通过这些 Init() 创建的服务器地址通常是固定的。创建时不涉及 NamingService 或 LoadBalancer,因此相对轻量。地址可以是主机名,但不要频繁创建连接到主机名的 Channel,因为这需要进行 DNS 查询,最多可能耗时 10 秒(DNS 查询的默认超时时间)。请复用它们。
有效的 “server_addr_and_port”:
- 127.0.0.1:80
- www.foo.com:8765
- localhost:9000
无效的 “server_addr_and_port”:
- 127.0.0.1:90000 # 端口号过大
- 10.39.2.300:8000 # 无效的 IP
连接到集群
int Init(const char* naming_service_url,
         const char* load_balancer_name,
         const ChannelOptions* options);
由上述 Init() 创建的 Channel 会定期或由事件驱动地从 naming_service_url 指定的 NamingService 获取服务器列表,并按照 load_balancer_name 指定的算法从列表中选择一台服务器发送请求。
你不应该在每次 RPC 之前临时创建这样的 Channel,因为创建和销毁这类 Channel 会涉及许多资源,例如 NamingService 需要在创建时访问一次,否则服务器候选列表是未知的。另一方面,Channel 可以被多个线程安全地共享,没有必要频繁创建。
如果 load_balancer_name 为 NULL 或空,那么这个 Init() 就只是用于连接单个服务器,此时 naming_service_url 应当是该服务器的 "ip:port" 或 "host:port"。这样你就可以用这个 Init() 统一初始化所有 Channel。例如,你可以把 naming_service_url 和 load_balancer_name 的值放在配置文件中,将 load_balancer_name 对于单服务器设置为空,对集群设置为一个有效的算法。
命名服务
命名服务将一个名称映射为一个可修改的服务器列表。它在客户端的位置如下:
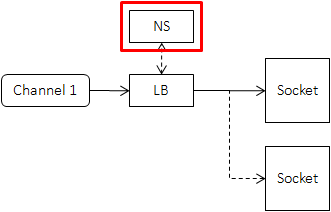
借助命名服务,客户端只需记住一个名称,而不是记住每一台具体的服务器。当服务器被添加或删除时,只需修改命名服务中的映射,而无需通知每一个可能访问该集群的客户端。这一过程被称为"上下游解耦"。回到实现细节,客户端实际上会记住每一台服务器,并定期访问 NamingService 或被推送最新的服务器列表。这种实现对 RPC 延迟的影响极小,对提供命名服务的系统造成的压力也非常小。
naming_service_url 的一般形式为 "协议://服务名"。
bns://<bns-name>
BNS 是百度内部最常见的命名服务。在 "bns://rdev.matrix.all" 中,"bns" 是协议,"rdev.matrix.all" 是服务名。相关的 gflag 是 -ns_access_interval: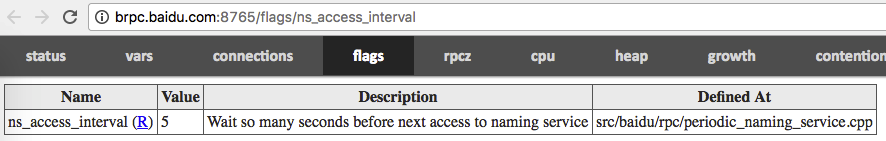
如果 BNS 中的列表非空,但 Channel 报告"没有服务器",那么该机器在 BNS 中的状态位很可能非零,这意味着该机器不可用,因此相应地未被添加为 Channel 的服务器候选。可以通过以下方式检查状态位:
get_instance_by_service [bns_node_name] -s
file://<path>
服务器被放置在 path 所指定的文件中。例如,在 "file://conf/machine_list" 中,"conf/machine_list" 就是该文件:
- 其中每一行都是一个服务器的地址。
之后的内容是注释,会被忽略。
- 地址之后的非注释内容是标签,标签与地址之间由一个或多个空格分隔;相同地址加上不同标签会被视为不同的实例。
- 当该文件更新时,brpc 会重新加载它。
# This line is ignored
10.24.234.17:8080 tag1  # a comment
10.24.234.17:8090 tag2  # an instance different from the instance on last line
10.24.234.18:8080
10.24.234.19:8080
优点:易于修改,方便进行单元测试。
缺点:列表变更时需要更新所有客户端,不适用于线上部署。
list://<addr1>,<addr2>…
服务器地址直接写在 list:// 之后,用逗号分隔。例如:"list://db-bce-81-3-186.db01:7000,m1-bce-44-67-72.m1:7000,cp01-rd-cos-006.cp01:7000" 表示包含 3 个地址。
可以在地址后追加标签,地址与标签之间用一个或多个空格分隔。相同的地址 + 不同的标签会被视为不同的实例。
优点:可直接在命令行中配置,方便进行单元测试。
缺点:无法在运行时更新,完全不适用于线上部署。
http://<url>
连接该域名下的所有服务器,例如:http://www.baidu.com:80]。
注意:虽然用于连接单个服务器的 Init()(2 个参数)也接受主机名,但它只会连接该域名下的一个服务器。
优点:利用 DNS 的通用性,可在专网或公网中使用。
缺点:受 DNS 传输格式的限制,无法实现通知机制。
https://<url>
与"http"前缀类似,区别在于连接将使用SSL加密。
consul://<service-name>
通过 consul 获取指定 service-name 的服务器列表。consul 的默认地址为 localhost:8500,可以通过在 gflags 中设置 -consul_agent_addr 进行修改。consul 的连接超时默认为 200ms,可以通过 -consul_connect_timeout_ms 修改。
默认情况下,stale 和 passing(仅返回状态为 passing 的服务器)会被添加到 consul 请求的参数 中,可以通过 gflags 中的 -consul_url_parameter 修改。
除第一次请求 consul 外,后续请求使用 长轮询 功能。即 consul 仅在服务器列表更新或请求超时才做出响应。超时默认为 60 秒,可以通过 -consul_blocking_query_wait_secs 修改。
如果 consul 返回的服务器列表不符合 响应格式,或者列表中的所有服务器因地址、端口等关键字段缺失或无法解析而被过滤,则服务器列表不会更新,经过一段时间(默认 500ms,可通过 -consul_retry_interval_ms 修改)后将重新访问 consul 服务。
如果 consul 不可访问,命名服务可以自动降级为文件命名服务。该功能默认关闭,可通过设置 -consul_enable_degrade_to_file_naming_service 开启。降级后,将使用 -consul_file_naming_service_dir 目录下以 service-name 命名的文件。该文件可由 consul-template 生成,其中保存了 consul 不可用前的最新服务器列表。当 consul 恢复时,consul 命名服务会自动恢复。
更多命名服务
用户可以通过实现 brpc::NamingService 来扩展更多命名服务,详情请参见 此链接。
命名服务中的标签
每个地址都可以附加一个标签。常见的实现方式是:如果地址后存在空格,则空格之后的内容即为标签。相同地址但标签不同会被视为不同的实例,通过各自的连接进行交互。用户可以利用该功能以更灵活的方式与远程服务器建立连接。如果需要加权轮询,应优先考虑使用 wrr 算法,而不是用标签模拟"一个粗粒度版本"。
VIP 通常是四层负载均衡器的公网 IP,它将流量代理到其背后的 RS。当客户端连接 VIP 时,会与被选中的 RS 建立连接。当客户端连接断开时,到 RS 的连接也会被重置。
如果一个客户端只与 VIP 建立一条连接(brpc 中的“single”连接类型),该客户端的所有流量都会落到同一个 RS 上。当客户端数量足够多时,每个 RS 都会接收到大量连接,从集群整体来看大致是均衡的。然而,如果客户端数量不够多,或者各客户端的负载差异很大,某些 RS 可能会过载。另一个问题是,当多个 VIP 一起被列出时,发往它们的流量可能与它们背后的 RS 数量不成正比。
解决这些问题的一种方式是使用“pooled”连接类型,这样一个客户端可以与一个 VIP 建立多条连接(大致等于最近的并发量),从而使流量分散到不同的 RS 上。如果存在多个 VIP,可以考虑使用 wrr 负载均衡为不同 VIP 设置权重,或为 VIP 添加不同的 tag 以形成更多实例。
如果对性能有更高要求,或者(在大规模集群中)连接数量受限,可以考虑使用 single 连接方式,通过为同一个 VIP 附加不同的 tag 来建立不同的连接。与 pooled 连接相比,这种方式的连接数和系统调用开销通常更低,但如果 tag 数量不足,RS 热点问题仍然可能存在。
命名服务过滤器
用户可以在将从 NamingService 获取的服务器推送给 LoadBalancer 之前对其进行过滤。
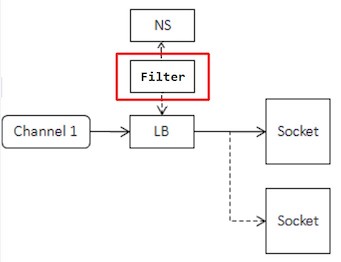
过滤器的接口:
// naming_service_filter.h
class NamingServiceFilter {
public:
    // Return true to take this `server' as a candidate to issue RPC
    // Return false to filter it out
    virtual bool Accept(const ServerNode& server) const = 0;
};

// naming_service.h
struct ServerNode {
    butil::EndPoint addr;
    std::string tag;
};
最常见的用法是按服务器标签过滤。
自定义过滤器设置在 ChannelOptions 中生效。默认值为 NULL,表示不过滤。
class MyNamingServiceFilter : public brpc::NamingServiceFilter {
public:
    bool Accept(const brpc::ServerNode& server) const {
        return server.tag == "main";
    }
};

int main() {
    ...
    MyNamingServiceFilter my_filter;
    ...
    brpc::ChannelOptions options;
    options.ns_filter = &my_filter;
    ...
}
负载均衡
当有多个服务器可供访问时,我们需要分流流量。这个过程称为负载均衡,在客户端的位置如下所示:
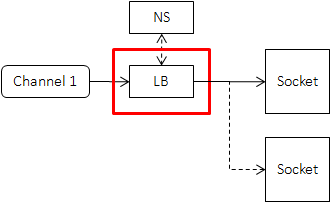
理想的算法是让每个请求都能被及时处理,任何服务器的故障影响最小。然而客户端无法实时感知服务器端发生的延迟或拥塞,且负载均衡算法通常需要是轻量级的,因此用户需要根据自己的使用场景选择合适的算法。brpc 提供的算法(由 load_balancer_name 指定)如下:
rr
即轮询(round robin)。总是选择列表中的下一个服务器,最后一个服务器的下一个是第一个。无需其他配置。例如有 3 台服务器 a、b、c,brpc 将按 a、b、c、a、b、c……的顺序发送请求。注意,使用该算法的前提是机器配置、网络延迟、服务器负载等条件相似。
wrr
即加权轮询(weighted round robin)。根据配置的权重选择下一个服务器。服务器被选中的概率与其权重一致,且该算法可以使每次服务器选择分布更加均匀。
实例标签必须是一个 int32 类型的数字,表示权重,例如 tag="50"。
random
从列表中随机选择一台服务器,无需其他配置。与轮询类似,该算法假设待访问的服务器条件相似。
wr
即加权随机(weighted random)。根据配置的权重选择下一个服务器。服务器被选中的概率与其权重一致。
实例标签的要求与 wrr 相同。
la
即地域感知(locality-aware)。优先选择延迟较低的服务器,直到其延迟高于其他服务器,无需其他配置。详情请参阅 地域感知负载均衡。
c_murmurhash 或 c_md5
即一致性哈希。添加或删除服务器不会像简单哈希那样导致请求的目标地址发生剧烈变化。特别适用于缓存服务。
在 RPC 之前需要设置 Controller.set_request_code(),否则 RPC 将会失败。request_code 通常是请求"键部分"的 32 位哈希码,哈希算法不需要与负载均衡器使用的算法相同。例如 c_murmurhash 也可以使用 md5 来计算请求的 request_code。
src/brpc/policy/hasher.h](https://github.com/brpc/brpc/blob/master/src/brpc/policy/hasher.h) 包含了通用的哈希函数。如果 std::string key 代表请求的键部分,则 controller.set_request_code(brpc::MurmurHash32(key.data(), key.size())) 可以正确设置 request_code。
请区分请求的"键"和"属性"。不要为了图省事而用请求的全部内容来计算 request_code。属性的微小变化可能导致完全不同的哈希码,从而使目标地址发生剧烈变化。另一个原因是内存填充(padding),例如:struct Foo { int32_t a; int64_t b; } 在 64 位机器上,a 和 b 之间存在 4 字节的未定义间隙,hash(&foo, sizeof(foo)) 的结果是未定义的。字段在哈希之前需要进行打包或序列化。
详情请参阅 一致性哈希。
其他类型的 lb 不需要设置 Controller.set_request_code()。即使设置了请求码,lb 也不会使用它。例如,lb=rr 时调用了 Controller.set_request_code(),即便每个请求的 request_code 都相同,lb 仍会按照 rr 策略进行负载均衡。
集群宕机恢复的客户端限流
集群宕机是指集群中所有服务器都不可用的状态。由于健康检查机制的存在,当集群恢复正常时,服务器会逐个上线。当某台服务器上线后,所有流量都会被发送到它,这可能导致该服务再次过载。如果启用了熔断机制,服务器可能在其他服务器上线之前就再次下线,导致集群永远无法恢复。作为一种解决方案,brpc 提供了集群宕机后恢复的客户端限流机制。当集群中没有可用服务器时,集群进入恢复状态。假设能够服务所有请求的最小服务器数量为 min_working_instances,当前集群中可用的服务器数量为 q,那么在恢复状态下,客户端接受请求的概率为 q/min_working_instances,否则该请求将被丢弃。如果 q 在一段时间(hold_seconds)内保持不变,则流量会重新发送到所有可用服务器,集群离开恢复状态。判断请求是否在恢复状态中被拒绝,可通过 controller.ErrorCode() 是否等于 brpc::ERJECT 来确定,被拒绝的请求不会由框架重试。
该恢复机制要求下游服务器的能力相近,因此目前仅对 rr 和 random 有效。启用方式是在 load_balancer_name 之后添加 min_working_instances 和 hold_seconds 参数的值,例如:
channel.Init("http://...", "random:min_working_instances=6 hold_seconds=10", &options);健康检查
连接丢失的服务器会被临时隔离,以防止被 LoadBalancer 选中。brpc 会周期性地连接被隔离的服务器,测试它们是否已恢复健康。该周期由 gflag -health_check_interval 控制:
| 名称 | 值 | 描述 | 定义位置 |
|---|---|---|---|
| health_check_interval (R) | 3 | 两次健康检查之间的间隔(秒) | src/brpc/socket_map.cpp |
一旦服务器连接成功,它将重新成为 LoadBalancer 中的候选服务器。如果在健康检查期间某台服务器被 NamingService 移除,brpc 也会将其从健康检查中移除。
发起 RPC
通常,我们不会直接使用 Channel.CallMethod,而是调用由 protobuf 生成的 XXX_Stub,这样更像是在进行“方法调用”。stub 的成员字段很少,适合(也推荐)放在栈上而不是用 new() 创建。当然,stub 也可以被保存并重复使用。Channel.CallMethod 与 stub 都是线程安全的,可被多个线程同时访问。例如:
XXX_Stub stub(&channel);
stub.some_method(controller, request, response, done);
或者更进一步:
XXX_Stub(&channel).some_method(controller, request, response, done);一个例外是 http/h2 客户端,它与 protobuf 关系不大。直接调用 CallMethod 即可发起 http 调用,除 Controller 和 done 外其他参数均设为 NULL,详情参见 Access http/h2。
同步调用
CallMethod 会阻塞,直到收到服务器响应或发生错误(包括超时)。
在同步调用中,CallMethod 返回后 brpc 就不会再使用 response/controller,因此可以安全地将它们放在栈上。注意:如果 request/response 字段很多、体积较大,最好分配在堆上。
MyRequest request;
MyResponse response;
brpc::Controller cntl;
XXX_Stub stub(&channel);

request.set_foo(...);
cntl.set_timeout_ms(...);
stub.some_method(&cntl, &request, &response, NULL);
if (cntl.Failed()) {
    // RPC failed. fields in response are undefined, don't use.
} else {
    // RPC succeeded, response has what we want.
}
警告:在持有 pthread 锁时,请勿使用同步调用!否则很容易造成死锁。
解决方案(二选一):
- 将 pthread 锁替换为 bthread 锁(bthread_mutex_t)
- 在 CallMethod 之前释放锁
异步调用
向 CallMethod 传入一个回调 done,该回调在请求发送后(而非 RPC 完成后)恢复执行。当收到服务端的响应或发生错误(包括超时)时,会调用 done->Run()。RPC 的后处理代码应放在 done->Run() 中,而不是放在 CallMethod 之后。
由于 CallMethod 返回并不代表 RPC 已完成,响应/控制器可能仍会被 brpc 或 done->Run() 使用。通常应将它们分配在堆上,并在 done->Run() 中删除。如果过早删除,done->Run() 可能会访问无效内存。
你可以分别 new 这些对象,并通过 NewCallback 创建 done,也可以让响应/控制器成为 done 的成员,然后 将它们一起 new 出来。推荐使用前一种方式。
请求对象在异步 CallMethod 之后可以立即销毁。(SelectiveChannel 是例外:在使用 SelectiveChannel 的情况下,请求对象必须在 RPC 结束之后释放)
Channel 在异步 CallMethod 之后可以立即销毁。
注意,“立即”意味着对 Request/Channel 的销毁可以发生在 CallMethod 之后,但不能发生在 CallMethod 执行过程中。删除一个正被其他线程使用的 Channel 会导致未定义行为(最轻的结果是崩溃)。
使用 NewCallback
static void OnRPCDone(MyResponse* response, brpc::Controller* cntl) {
    // unique_ptr helps us to delete response/cntl automatically. unique_ptr in gcc 3.4 is an emulated version.
    std::unique_ptr<MyResponse> response_guard(response);
    std::unique_ptr<brpc::Controller> cntl_guard(cntl);
    if (cntl->Failed()) {
        // RPC failed. fields in response are undefined, don't use.
    } else {
        // RPC succeeded, response has what we want. Continue the post-processing.
    }
    // Closure created by NewCallback deletes itself at the end of Run.
}

MyResponse* response = new MyResponse;
brpc::Controller* cntl = new brpc::Controller;
MyService_Stub stub(&channel);

MyRequest request;  // you don't have to new request, even in an asynchronous call.
request.set_foo(...);
cntl->set_timeout_ms(...);
stub.some_method(cntl, &request, response, brpc::NewCallback(OnRPCDone, response, cntl));
由于 protobuf 3 将 NewCallback 改为私有成员,r32035 之后 brpc 将 NewCallback 放在了 src/brpc/callback.h 中(并新增了更多重载)。如果你的程序在使用 NewCallback 时出现编译问题,请将 google::protobuf::NewCallback 替换为 brpc::NewCallback。
继承 google::Closure
使用 NewCallback 的缺点是你至少需要在堆上分配 3 次内存:response、controller 和 done。如果性能分析工具显示内存分配是热点,你可以考虑自己继承 Closure,并将 response/controller 作为成员变量封装起来。这样做可以把 3 次 new 合并为 1 次,但代码的可读性会变差。如果内存分配不是问题,就不要这样做。
class OnRPCDone: public google::protobuf::Closure {
public:
    void Run() {
        // unique_ptr helps us to delete response/cntl automatically. unique_ptr in gcc 3.4 is an emulated version.
        std::unique_ptr<OnRPCDone> self_guard(this);

        if (cntl->Failed()) {
            // RPC failed. fields in response are undefined, don't use.
        } else {
            // RPC succeeded, response has what we want. Continue the post-processing.
        }
    }

    MyResponse response;
    brpc::Controller cntl;
}

OnRPCDone* done = new OnRPCDone;
MyService_Stub stub(&channel);

MyRequest request;  // you don't have to new request, even in an asynchronous call.
request.set_foo(...);
done->cntl.set_timeout_ms(...);
stub.some_method(&done->cntl, &request, &done->response, done);
当回调非常复杂时会发生什么?
没有特殊影响,回调会在独立的 bthread 中运行,不会阻塞其他会话。你可以在回调中做任何事情。
回调是否运行在 CallMethod 所在的同一线程中?
回调运行在另一个 bthread 中,即使 RPC 在刚进入 CallMethod 后就失败也是如此。这样可以避免在锁内进行 RPC(不推荐)时发生死锁。
等待 RPC 完成
NOTE:ParallelChannel 可能更适合并行发起多个 RPC。
以下代码启动 2 个异步 RPC 并等待它们完成。
const brpc::CallId cid1 = controller1->call_id();
const brpc::CallId cid2 = controller2->call_id();
...
stub.method1(controller1, request1, response1, done1);
stub.method2(controller2, request2, response2, done2);
...
brpc::Join(cid1);
brpc::Join(cid2);在发起 RPC 之前调用 Controller.call_id() 获取一个 id,RPC 完成后对这个 id 调用 Join()。
Join() 会阻塞直到 RPC 完成并且 done->Run() 结束,Join 的性质如下:
- 如果 RPC 已经完成,Join() 会立即返回。
- 多个线程可以对同一个 id 调用 Join(),它们都会被唤醒。
- 同步 RPC 也可以在另一个线程中调用 Join(),尽管我们很少这样做。
Join() 之前叫作 JoinResponse(),如果编译时遇到已废弃(deprecated)的提示,将其改名为 Join()。
在 RPC 完成之后调用 Join(controller->call_id()) 是错误的,务必在 RPC 发起之前保存 call_id,否则 controller 可能在任何时刻被 done 销毁。下面代码中的 Join 是错误的。
static void on_rpc_done(Controller* controller, MyResponse* response) {
    ... Handle response ...
    delete controller;
    delete response;
}

Controller* controller1 = new Controller;
Controller* controller2 = new Controller;
MyResponse* response1 = new MyResponse;
MyResponse* response2 = new MyResponse;
...
stub.method1(controller1, &request1, response1, google::protobuf::NewCallback(on_rpc_done, controller1, response1));
stub.method2(controller2, &request2, response2, google::protobuf::NewCallback(on_rpc_done, controller2, response2));
...
brpc::Join(controller1->call_id());   // WRONG, controller1 may be deleted by on_rpc_done
brpc::Join(controller2->call_id());   // WRONG, controller2 may be deleted by on_rpc_done
半同步调用
Join 可用于实现「半同步」调用:阻塞等待多个异步调用完成。由于调用点会阻塞至所有 RPC 结束,controller/response 可以安全地放在栈上。
brpc::Controller cntl1;
brpc::Controller cntl2;
MyResponse response1;
MyResponse response2;
...
stub1.method1(&cntl1, &request1, &response1, brpc::DoNothing());
stub2.method2(&cntl2, &request2, &response2, brpc::DoNothing());
...
brpc::Join(cntl1.call_id());
brpc::Join(cntl2.call_id());
brpc::DoNothing() 获取一个什么都不做的闭包,专门用于半同步调用。它的生命周期由 brpc 管理。
注意,在上面的例子中,我们在 RPC 完成之后访问了 controller.call_id(),这里是安全的,因为 DoNothing 不会像上例中的 on_rpc_done 那样删除 controller。
取消 RPC
brpc::StartCancel(call_id) 会取消对应的 RPC,call_id 必须在发起 RPC 之前通过 Controller.call_id() 获取,其他任何时候获取都可能发生竞态条件。
注意,被禁止且无效的是 brpc::StartCancel(call_id),而不是 controller->StartCancel()。后者是 protobuf 默认提供的,其 controller 的生命周期存在严重的竞态条件。
顾名思义,调用 StartCancel 后 RPC 可能尚未完成,你不应触碰 Controller 中的任何字段,也不应删除任何关联的资源,这些都应在 done->Run() 内部处理。如果你必须原地等待 RPC 完成(不推荐),请调用 Join(call_id)。
关于 StartCancel 的事实:
- call_id 可以在 CallMethod 之前被取消,RPC 会立即结束(done 也会被调用)。
- call_id 可以在另一个线程中被取消。
- 对已经取消的 call_id 再次取消没有效果。推论:一个 call_id 可以被多个线程同时取消,但只有其中一个生效。
- 这里的取消是仅客户端的功能,服务端不一定因此取消该操作,服务端取消是一个独立的功能。
获取服务端地址和端口
remote_side() 告知请求被发送到了哪里,返回类型是 butil::EndPoint,其中包含一个 ipv4 地址和端口。在 RPC 完成之前调用此方法是未定义行为。
如何打印:
LOG(INFO) << "remote_side=" << cntl->remote_side();
printf("remote_side=%s\n", butil::endpoint2str(cntl->remote_side()).c_str());
获取客户端地址与端口
自 r31384 起,local_side() 可以获取发送 RPC 的客户端地址与端口。
如何打印:
LOG(INFO) << "local_side=" << cntl->local_side();
printf("local_side=%s\n", butil::endpoint2str(cntl->local_side()).c_str());
是否应复用 brpc::Controller?
没有必要刻意复用。
Controller 包含各种字段,其中一些是可以通过调用 Reset() 来重复使用的缓冲区。
在大多数使用场景中,构造一个 Controller(代码片段 1)与复用一个 Controller(代码片段 2)的表现是相似的。
// snippet1
for (int i = 0; i < n; ++i) {
    brpc::Controller controller;
    ...
    stub.CallSomething(..., &controller);
}

// snippet2
brpc::Controller controller;
for (int i = 0; i < n; ++i) {
    controller.Reset();
    ...
    stub.CallSomething(..., &controller);
}
如果 snippet1 中的 Controller 是通过 new 在堆上创建的,那么 snippet1 会额外付出「堆分配」的开销,在某些情况下可能会稍慢一些。
设置
客户端设置包含 3 个部分:
- brpc:,定义于 src/brpc/channel.h,用于初始化 Channel,初始化完成后即不可变。
- brpc:,定义于 src/brpc/controller.h,用于根据上下文为某个 RPC 覆盖 brpc::ChannelOptions 中的字段。
- 全局 gflags:用于调整全局行为,一般保持不变。设置前请先阅读 /flags 中的注释。
Controller 包含请求本身可能没有的数据和选项。服务端与客户端共用同一个 Controller 类,但它们可能会设置不同的字段。使用前请仔细阅读 Controller 中的注释。
一个 Controller 对应一次 RPC。Controller 在调用 Reset() 之后可以被另一次 RPC 复用,但一个 Controller 不能同时被多次 RPC 使用,无论这些 RPC 是否由同一个线程发起。
Controller 的特性:
- 一个 Controller 只能有一个使用者。除非有明确说明,Controller 中的方法默认都是非线程安全的。
- 由于 Controller 通常不被共享,因此无需使用 shared_ptr 来管理 Controller。如果这样做,可能会出现问题。
- Controller 在 RPC 之前构造,在 RPC 之后析构,常见模式如下:
- 在同步 RPC 之前将 Controller 放在栈上,离开作用域时自动析构。注意异步 RPC 的 Controller 绝不能放在栈上,否则在 Controller 被析构时 RPC 可能仍在运行,从而导致未定义行为。
- 在异步 RPC 之前 new 一个 Controller,在 done 中 delete。
工作 pthread 的数量
brpc 中客户端没有独立的线程池。所有 Channel 和 Server 通过 bthread 共享同一组底层线程。如果使用了 Server,设置 Server 的工作 pthread 数量对 Client 同样生效;或者直接指定 gflag](/book/reader/apache-brpc/flags) -bthread_concurrency 来设置全局工作 pthread 的数量。
超时
ChannelOptions.timeout_ms 表示经由该 Channel 的所有 RPC 的超时时间(毫秒),Controller.set_timeout_ms() 可为单次 RPC 覆盖该值。默认值为 1 秒,最大值为 2^31(约 24 天),-1 表示无限等待响应或连接错误。
ChannelOptions.connect_timeout_ms 表示经由该 Channel 建立 RPC 连接的超时时间(毫秒),-1 表示没有期限。该值被限制为不大于 timeout_ms。注意此连接超时与 TCP 中的连接超时不同,通常此超时更小。
注意1:brpc 中的 timeout_ms 是期限(deadline),即一旦到达该时间,RPC 直接结束,不再进行更多重试。作为对比,其他实现可能同时存在会话超时和期限超时。移植到 brpc 之前请务必区分这两者。
注意2:RPC 超时的错误码是 **ERPCTIMEDOUT (1008) **,而 ETIMEDOUT 是连接超时,属于可重试错误。
重试
ChannelOptions.max_retry 表示经由该 channel 的所有 RPC 的最大重试次数,默认值为 3,0 表示不重试。Controller.set_max_retry() 可为单次 RPC 覆盖该值。
Controller.retried_count() 返回重试次数。
Controller.has_backup_request() 用于判断是否发送了 backup_request。
已尝试过的服务器会尽可能地避免被重试
重试的条件(同时满足):
- 连接已断开。
- 尚未达到超时时间。
- 仍有重试额度。Controller.set_max_retry(0) 或 ChannelOptions.max_retry = 0 会禁用重试。
- 重试是有意义的。如果 RPC 因请求本身失败(EREQUEST),则不会重试,因为服务器很可能再次拒绝该请求,此处重试没有意义。
连接断开
如果服务器没有响应但连接是正常的,则不会触发重试。如果你需要在某个超时之后再发送一个请求,请使用 backup request。
工作原理:如果在 backup_request_ms 指定的超时时间内没有收到响应,则发送另一个请求,以最先返回的响应为准。新请求会尽可能地发送给此前从未尝试过的另一台服务器。注意:如果 backup_request_ms 大于 timeout_ms,backup request 将永远不会被发送。backup request 会消耗一次重试额度。backup request 不意味着服务端会被取消。
ChannelOptions.backup_request_ms 影响通过该 Channel 发起的所有 RPC,单位为毫秒,默认值为 -1(禁用)。Controller.set_backup_request_ms() 可为单次 RPC 覆盖该值。
未达到超时时间
RPC 会在超时后很快结束。
仍有重试配额
Controller.set_max_retry(0) 或 ChannelOptions.max_retry = 0 会禁用重试。
重试有意义
如果 RPC 因请求问题失败(EREQUEST),则不会进行重试,因为服务器很可能再次拒绝该请求,此时重试没有意义。
用户可以继承 brpc::RetryPolicy 来自定义重试条件。例如,brpc 默认不会对 http/h2 相关错误进行重试。如果你希望在应用中对 HTTP_STATUS_FORBIDDEN(403) 进行重试,可以按如下方式操作:
#include <brpc/retry_policy.h>

class MyRetryPolicy : public brpc::RetryPolicy {
public:
    bool DoRetry(const brpc::Controller* cntl) const {
        if (cntl->ErrorCode() == brpc::EHTTP && // http/h2 error
            cntl->http_response().status_code() == brpc::HTTP_STATUS_FORBIDDEN) {
            return true;
        }
        // Leave other cases to brpc.
        return brpc::DefaultRetryPolicy()->DoRetry(cntl);
    }
};
...

// Assign the instance to ChannelOptions.retry_policy.
// NOTE: retry_policy must be kept valid during lifetime of Channel, and Channel does not retry_policy, so in most cases RetryPolicy should be created by singleton..
brpc::ChannelOptions options;
static MyRetryPolicy g_my_retry_policy;
options.retry_policy = &g_my_retry_policy;
...
一些提示:
- 通过 cntl->response() 获取 RPC 的响应。
- 由 ERPCTIMEDOUT 表示的 RPC 超时期限永远不会被重试,即使你的派生 RetryPolicy 允许重试。
重试应当保守
由于维护成本的原因,即便超大规模的集群,其部署的实例数量也只是“刚刚好”能够承受重大故障,也就是单个机房下线,最多占全部机器的 1/2。然而激进的重试很容易让所有客户端对服务端的压力翻倍甚至变成三倍,从而导致整个集群崩溃:越来越多的请求滞留在缓冲区中,因为服务端无法及时处理它们。所有请求都不得不等待非常长的时间才能被处理,并最终超时,就好像整个集群已经崩溃一样。默认的重试策略通常是安全的:除非连接断开,否则几乎不会发送重试。不过,用户可以通过继承 RetryPolicy 来自定义重试的触发条件,这有可能把重试变成一场“风暴”。在自定义 RetryPolicy 时,你需要仔细考虑客户端与服务端之间的交互方式,并设计相应的测试来验证重试行为符合预期。
熔断器
更多细节请查看 circuit_breaker。
协议
Channel 使用的默认协议是 baidu_std,可通过设置 ChannelOptions.protocol 进行更改。该字段同时接受枚举值和字符串。
支持的协议:
PROTOCOL_BAIDU_STD 或 "baidu_std",即百度内部的标准二进制协议,默认使用单连接。
PROTOCOL_HTTP 或 "http",即 http/1.0 或 http/1.1,默认使用连接池(Keep-Alive)。
- 访问普通 http 服务的方法列于 Access http/h2。
- 使用 http:json 或 http:proto 访问 pb 服务的方法列于 http/h2 derivatives
PROTOCOL_H2 或 "h2",即 http/2,默认使用单连接。
- 访问普通 http/h2 服务的方法列于 Access http/h2。
- 使用 h2:json 或 h2:proto 访问 pb 服务的方法列于 http/h2 衍生协议
PROTOCOL_THRIFT 或 “thrift”,即 apache thrift 的协议,默认使用连接池,详情参见 Access thrift。
PROTOCOL_MEMCACHE 或 “memcache”,即 memcached 的二进制协议,默认使用单连接。详情参见 Access memcached。
PROTOCOL_REDIS 或 “redis”,即 redis 1.2+(hiredis 所支持的版本)的协议,默认使用单连接。详情参见 Access Redis。
PROTOCOL_HULU_PBRPC 或 “hulu_pbrpc”,即 hulu-pbrpc 的协议,默认使用单连接。
PROTOCOL_NOVA_PBRPC 或 “nova_pbrpc”,即百度广告联盟的协议,默认使用连接池。
PROTOCOL_SOFA_PBRPC 或 “sofa_pbrpc”,即 sofa-pbrpc 的协议,默认使用单连接。
PROTOCOL_PUBLIC_PBRPC 或 “public_pbrpc”,即 public_pbrpc 的协议,默认使用连接池。
PROTOCOL_UBRPC_COMPACK 或 “ubrpc_compack”,即 public/ubrpc 的协议,使用 compack 打包,默认使用连接池。详情参见 ubrpc (by protobuf)。相关协议还有 PROTOCOL_UBRPC_MCPACK2 或 ubrpc_mcpack2,使用 mcpack2 打包。
PROTOCOL_NSHEAD_CLIENT 或 “nshead_client”,即 baidu-rpc-ub 中 UBXXXRequest 所需的协议,默认使用连接池。详情参见 Access UB。
PROTOCOL_NSHEAD 或 “nshead”,即发送 NsheadMessage 所需的协议,默认使用连接池。详情参见 nshead+blob。
PROTOCOL_NSHEAD_MCPACK 或 “nshead_mcpack”,顾名思义,即 nshead + mcpack(通过 mcpack2pb 由 protobuf 解析),默认使用连接池。
PROTOCOL_ESP 或 “esp”,用于访问使用 esp 协议的服务,默认使用连接池。
连接类型
brpc 支持以下连接类型:
- 短连接(short connection):每次 RPC 前建立,完成后关闭。由于每次 RPC 都要承担建立连接的开销,这种类型适用于偶尔发起的 RPC,而不适用于频繁发起的 RPC。默认情况下没有任何协议使用这种类型。http/1.0 中的连接按短连接方式处理。
- 池化连接(pooled connection):每次 RPC 前从连接池中取一个空闲连接,完成后归还。同一时刻一条连接至多承载一个请求。一个客户端对同一个服务端可以建立多条连接。http/1.1 以及使用 nshead 的协议默认使用这种类型。
- 单连接(single connection):同一进程内的所有客户端对同一个服务端至多建立一条连接,同一条连接可以同时承载多个请求。接收到响应的顺序不必与发送请求的顺序一致。baidu_std、hulu_pbrpc、sofa_pbrpc 默认使用这种类型。
| 短连接 | 池化连接 | 单连接 | |
|---|---|---|---|
| 长连接 | 否 | 是 | 是 |
| 服务端连接数(来自一个客户端) | qps*延迟(little 定律](https://en.wikipedia.org/wiki/Little%27s_law)) | qps*延迟 | 1 |
| 峰值 qps | 差,且受限于最大端口数 | 中等 | 高 |
| 延迟 | 1.5RTT(connect) + 1RTT + 处理时间 | 1RTT + 处理时间 | 1RTT + 处理时间 |
| CPU 占用 | 高,每次 RPC 都需进行 tcp connect | 中等,每个请求都需要一次系统写 | 低,可合并写操作以降低开销 |
brpc 默认会为每种协议选择最优的连接类型,用户通常无需修改。如果确实需要修改,可将 ChannelOptions.connection_type 设置为:
CONNECTION_TYPE_SINGLE 或 “single”:单个连接
CONNECTION_TYPE_POOLED 或 “pooled”:池化连接。从一个客户端到一个服务器的池化连接最大数量由 -max_connection_pool_size 限制。注意该数量并不等同于“最大连接数”。当池中没有空闲连接时总是会创建新连接;当池中已有 max_connection_pool_size 个连接时,归还的连接会立即被关闭。max_connection_pool_size 的取值应与并发量相匹配,否则无法入池的连接会被频繁地创建和关闭,其行为类似于短连接。如果 max_connection_pool_size 为 0,则池的行为完全等同于短连接。
名称 值 描述 定义位置 max_connection_pool_size (R) 100 到单个端点的池化连接最大数量 src/brpc/socket.cpp CONNECTION_TYPE_SHORT 或 “short”:短连接
""(空字符串)使 brpc 选择默认类型。
brpc 还支持 Streaming RPC,它是一种用于传输流式数据的应用层连接。
关闭池中的空闲连接
如果一个连接在 -idle_timeout_second 指定的秒数内没有发生读或写操作,它会被标记为“空闲”,并被自动关闭。默认值为 10 秒。该特性仅对池化连接有效。如果 -log_idle_connection_close 为 true,则会在关闭前打印一条日志。
| 名称 | 值 | 描述 | 定义位置 |
|---|---|---|---|
| idle_timeout_second | 10 | 池化连接在这么长时间内没有数据传输就会被关闭。取值非正数时不生效 | src/brpc/socket_map.cpp |
| log_idle_connection_close | false | 空闲连接被关闭时打印日志 | src/brpc/socket.cpp |
延迟关闭连接
多个 channel 可以通过引用计数共享同一个连接。当某个 channel 释放对该连接的最后一个引用时,该连接会被关闭。但在某些场景下,channel 在发送 RPC 之前刚刚创建、在完成之后就被销毁,这种情况下连接可能会被频繁地关闭并重新打开,其开销与短连接相当。
一种解决方案是缓存用户常用 的 channel,以避免频繁地创建和销毁 channel。然而 brpc 目前并未提供用于实现这一点的工具,用户自己也很难正确实现。
另一种解决方案是设置 gflag -defer_close_second
| 名称 | 值 | 描述 | 定义位置 |
|---|---|---|---|
| defer_close_second | 0 | 即使连接已无人使用,也延迟这么多秒后才关闭连接。取非正值时立即关闭 | src/brpc/socket_map.cpp |
设置该值后,连接在最后一个引用计数消失时不会立即关闭,而是经过这么多秒后才关闭。如果在等待期间又有 channel 引用该连接,连接会恢复正常。无论 channel 的创建频率多高,该标志都能限制关闭连接的频率。该标志的副作用是:销毁 channel 后文件描述符不会立即关闭;如果误将其设置为较大的值,进程中的活跃文件描述符数量也可能随之增多。
连接缓冲区大小
-socket_recv_buffer_size 设置所有连接的接收缓冲区大小,默认为 -1(不修改)
-socket_send_buffer_size 设置所有连接的发送缓冲区大小,默认为 -1(不修改)
| 名称 | 值 | 描述 | 定义位置 |
|---|---|---|---|
| socket_recv_buffer_size | -1 | 该值为正数时,设置 socket 的接收缓冲区大小 | src/brpc/socket.cpp |
| socket_send_buffer_size | -1 | 该值为正数时,设置 socket 的发送缓冲区大小 | src/brpc/socket.cpp |
log_id
set_log_id() 设置一个 64 位整型的 log_id,它会随请求一起发送到服务端,并且常被打印在服务端日志中,用于关联一次会话中访问的不同服务。字符串类型的 log-id 必须先转换为 64 位整数再进行设置。
附件(Attachment)
baidu_std 和 hulu_pbrpc 支持附件,附件随消息一起发送,由用户设置,用于绕过 protobuf 的序列化。作为客户端,设置在 Controller::request_attachment() 中的数据会被服务端收到,而 response_attachment() 中包含服务端回传的附件。
附件不会被框架压缩。
在 http/h2 中,附件对应于 消息体,即要发送到服务端的数据保存在 request_attachment() 中。
开启 SSL
开启 SSL 前请先将 openssl 升级到最新版本,因为旧版本的 openssl 可能存在严重的安全问题,且支持的加密算法较少,这与使用 SSL 的初衷相违背。将 ChannelOptions.mutable_ssl_options() 置位即可启用 SSL。详细选项请参考 ssl_options.h。ChannelOptions.has_ssl_options() 用于检查是否设置了 ssl_options;ChannelOptions.ssl_options() 返回 ssl_options 的 const 引用。
// Enable client-side SSL and use default values.
options.mutable_ssl_options();

// Enable client-side SSL and customize values.
options.mutable_ssl_options()->ciphers_name = "...";
options.mutable_ssl_options()->sni_name = "...";- 连接到单台服务器或集群的 Channel 都支持 SSL(初始实现不支持集群)
- 开启 SSL 后,通过该 Channel 的所有请求都会被加密。如果需要发送非 SSL 请求,用户应另外创建一个 Channel。
- HTTPS 的易用性改进:Channel.Init 能识别 https:// 前缀并自动开启 SSL;-http_verbose 在开启 SSL 时会打印证书信息。
认证
客户端一般有两种认证方式:
- 基于请求的认证:每个请求都携带认证信息。这种方式更灵活,因为认证信息可以包含与该次请求相关的字段。然而,由于每个请求都增加了额外的负载,会带来一定的性能损失。
- 基于连接的认证:在 TCP 连接建立之后,客户端发送一个认证包。经服务器验证通过后,该连接上的后续请求就无需再认证。与前者相比,这种方式的认证包只能携带一些静态信息,例如本地 IP。不过它的性能更好,尤其是在单连接/连接池场景下。
实现第一种方法非常简单,只需在请求的 proto 定义中加入认证数据格式,然后在每个请求中像普通 RPC 一样发送即可。要实现第二种方式,brpc 为用户提供了一个可自行实现的接口:
class Authenticator {
public:
    virtual ~Authenticator() {}

    // Implement this method to generate credential information
    // into `auth_str' which will be sent to `VerifyCredential'
    // at server side. This method will be called on client side.
    // Returns 0 on success, error code otherwise
    virtual int GenerateCredential(std::string* auth_str) const = 0;
};
当用户通过单条连接向同一服务器调用 RPC 接口时,框架保证一旦 TCP 连接建立,该连接上的第一个请求将包含由 GenerateCredential 生成的认证字符串。后续请求不会携带该字符串。整个发送过程仍然是高度并发的,因为它不会等待认证结果。如果验证成功,所有请求都会正常返回且无错误;否则,若验证失败,服务器通常会关闭连接,这些请求将收到相应的错误。
目前仅以下协议支持客户端认证:baidu_std(默认协议)、HTTP、hulu_pbrpc、ESP。对于自定义协议,一般来说,用户可以在请求打包过程中调用 Authenticator 的接口来生成认证字符串,以支持认证功能。
Reset
此方法使 Controller 恢复到刚创建时的状态。
不要在 RPC 过程中调用 Reset(),其行为是未定义的。
压缩
set_request_compress_type() 用于设置请求的压缩类型,默认不压缩。
注意:brpc 不会压缩 Attachment。
参见 compress request body 以压缩 http/h2 请求体。
支持的压缩方式:
- brpc::CompressTypeSnappy :snanpy,压缩和解压都非常快,但压缩率较低。
- brpc::CompressTypeGzip :gzip,速度明显慢于 snappy,但压缩率更高。
- brpc::CompressTypeZlib :zlib,比 gzip 快 10%~20%,但仍然明显慢于 snappy,压缩率略优于 gzip。
下表列出了不同方法对包含大量重复内容的数据进行压缩和解压的性能,仅供参考。
| 压缩方法 | 压缩数据大小(B) | 压缩耗时(us) | 解压耗时(us) | 压缩吞吐量(MB/s) | 解压吞吐量(MB/s) | 压缩率 |
|---|---|---|---|---|---|---|
| Snappy | 128 | 0.753114 | 0.890815 | 162.0875 | 137.0322 | 37.50% |
| Gzip | 10.85185 | 1.849199 | 11.2488 | 66.01252 | 47.66% | |
| Zlib | 10.71955 | 1.66522 | 11.38763 | 73.30581 | 38.28% | |
| Snappy | 1024 | 1.404812 | 1.374915 | 695.1555 | 710.2713 | 8.79% |
| Gzip | 16.97748 | 3.950946 | 57.52106 | 247.1718 | 6.64% | |
| Zlib | 15.98913 | 3.06195 | 61.07665 | 318.9348 | 5.47% | |
| Snappy | 16384 | 8.822967 | 9.865008 | 1770.946 | 1583.881 | 4.96% |
| Gzip | 160.8642 | 43.85911 | 97.13162 | 356.2544 | 0.78% | |
| Zlib | 147.6828 | 29.06039 | 105.8011 | 537.6734 | 0.71% | |
| Snappy | 32768 | 16.16362 | 19.43596 | 1933.354 | 1607.844 | 4.82% |
| Gzip | 229.7803 | 82.71903 | 135.9995 | 377.7849 | 0.54% | |
| Zlib | 240.7464 | 54.44099 | 129.8046 | 574.0161 | 0.50% |
下表列出了不同方法对重复内容极少的数据进行压缩和解压的性能,仅供参考。
| 压缩方法 | 压缩数据大小(B) | 压缩耗时(us) | 解压耗时(us) | 压缩吞吐(MB/s) | 解压吞吐(MB/s) | 压缩率 |
|---|---|---|---|---|---|---|
| Snappy | 128 | 0.866002 | 0.718052 | 140.9584 | 170.0021 | 105.47% |
| Gzip | 15.89855 | 4.936242 | 7.678077 | 24.7294 | 116.41% | |
| Zlib | 15.88757 | 4.793953 | 7.683384 | 25.46339 | 107.03% | |
| Snappy | 1024 | 2.087972 | 1.06572 | 467.7087 | 916.3403 | 100.78% |
| Gzip | 32.54279 | 12.27744 | 30.00857 | 79.5412 | 79.79% | |
| Zlib | 31.51397 | 11.2374 | 30.98824 | 86.90288 | 78.61% | |
| Snappy | 16384 | 12.598 | 6.306592 | 1240.276 | 2477.566 | 100.06% |
| Gzip | 537.1803 | 129.7558 | 29.08707 | 120.4185 | 75.32% | |
| Zlib | 519.5705 | 115.1463 | 30.07291 | 135.697 | 75.24% | |
| Snappy | 32768 | 22.68531 | 12.39793 | 1377.543 | 2520.582 | 100.03% |
| Gzip | 1403.974 | 258.9239 | 22.25825 | 120.6919 | 75.25% | |
| Zlib | 1370.201 | 230.3683 | 22.80687 | 135.6524 | 75.21% |
常见问题
问:brpc 支持 unix domain socket 吗?
不支持。本地 TCP socket 仅比 unix domain socket 稍慢一些,因为本地 TCP 连接的流量不经过网络。有些无法使用 TCP socket 的场景可能需要 unix domain socket,我们将来可能会考虑支持该能力。
问:连接 xx.xx.xx.xx:xxxx 失败,Connection refused
远端服务已经不再提供服务了(很可能已经崩溃)。
问:经常遇到 Connection timedout to another IDC
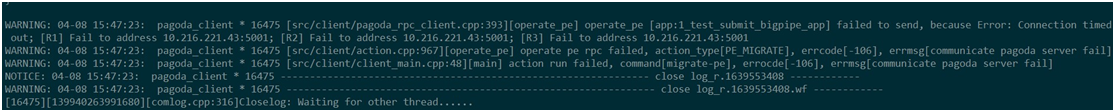
TCP 连接未能在 connection_timeout_ms 内建立,你需要调整以下选项:
struct ChannelOptions {
    ...
    // Issue error when a connection is not established after so many
    // milliseconds. -1 means wait indefinitely.
    // Default: 200 (milliseconds)
    // Maximum: 0x7fffffff (roughly 30 days)
    int32_t connect_timeout_ms;

    // Max duration of RPC over this Channel. -1 means wait indefinitely.
    // Overridable by Controller.set_timeout_ms().
    // Default: 500 (milliseconds)
    // Maximum: 0x7fffffff (roughly 30 days)
    int32_t timeout_ms;
    ...
};
NOTE:连接超时不是 RPC 超时,RPC 超时会以 “Reached timeout=…” 的形式打印。
Q:同步调用正常,异步调用崩溃
检查 Controller、Response 和 done 的生命周期。在异步调用中,CallMethod 的结束并不意味着 RPC 完成,RPC 完成是以 done->Run() 被调用为标志的。因此,这些对象不应在 CallMethod 返回后立即销毁,而应在 done->Run() 中销毁。通常应当将对象分配在堆上,而不是放在栈上。详情请参阅 异步调用]。
Q:如何保证请求被恰好处理一次
这个问题在 RPC 层无法解决。当响应返回且表示成功时,我们知道该 RPC 已在服务端被处理;当响应返回且表示被拒绝时,我们知道该 RPC 未在服务端被处理。但当没有返回响应时,服务端可能处理了该 RPC,也可能没有。如果此时进行重试,同一个请求可能会在服务端被处理两次。一般来说,具有副作用的 RPC 服务必须考虑服务的 幂等性],否则重试可能导致副作用被执行多次,从而产生非预期的行为。仅执行读操作的搜索类服务通常没有副作用(在搜索过程中),天然满足幂等性。而需要写入的存储服务则必须设计版本号或序列号机制,以拒绝已经发生过的副作用,从而保证幂等。
Q:无效地址=`bns://group.user-persona.dumi.nj03'
FATAL 04-07 20:00:03 7778 src/brpc/channel.cpp:123] Invalid address=`bns://group.user-persona.dumi.nj03'. You should use Init(naming_service_name, load_balancer_name, options) to access multiple servers.通过命名服务访问服务器需要使用带 3 个参数的 Init()(第二个参数是 load_balancer_name)。这里的 Init() 只有 2 个参数,brpc 会将其视为访问单个服务器,从而产生错误。
问:双方都使用 protobuf,为什么不能相互通信
protocol != protobuf。protobuf 只负责序列化一个包,而一个协议的消息可能包含多个包,以及额外的长度、校验和、魔数等信息。brpc 提供的「一次编码,多协议服务」能力,是通过将不同协议的数据转换为统一的 API 实现的,而不是在 protobuf 层实现的。
问:为什么 C++ 客户端/服务端可能无法与其他语言的客户端/服务端通信
检查 C++ 版本是否开启了压缩(Controller::set_compress_type),目前其他语言的 RPC 实现尚不支持压缩。
附:客户端工作流程
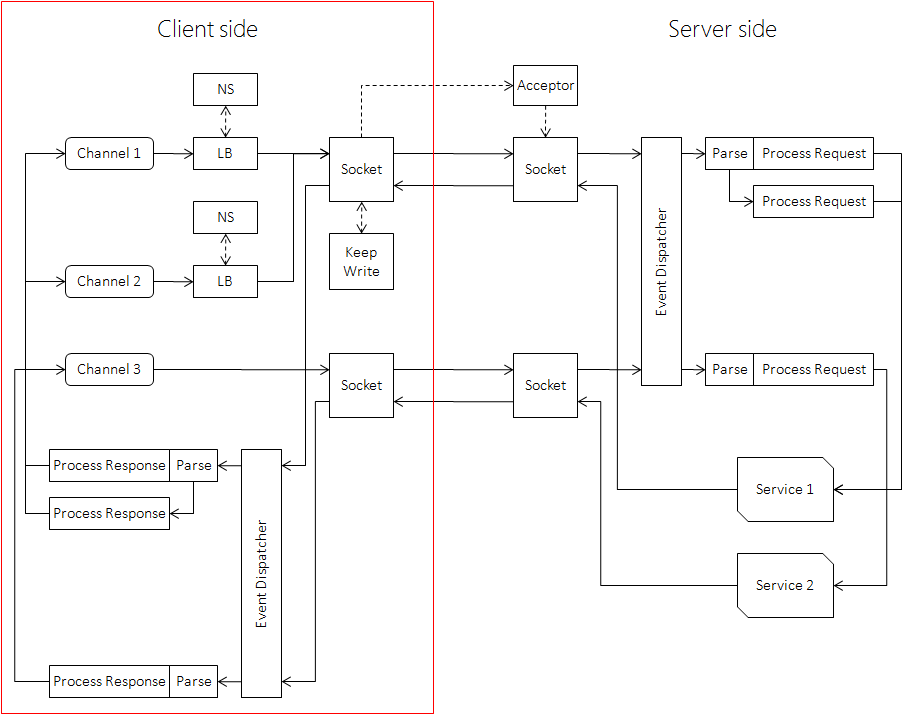
步骤:
- 创建一个 bthread_id 作为本次 RPC 的 correlation_id。
- 根据 Channel 的初始化方式,从全局 SocketMap 或 LoadBalancer 中选择一个服务器作为请求的目标。
- 根据连接类型(单连接、池化、短连接)选择一个 Socket。
- 如果开启了认证且该 Socket 尚未认证,第一个请求进入认证分支,其他请求阻塞等待,直到该分支将认证信息写入 Socket。服务端只校验第一个请求。
- 根据 Channel 的协议,选择对应的序列化回调,将请求序列化为 IOBuf。
- 如果设置了超时,则设置定时器。从此刻起,不要再使用 Controller,因为定时器可能在任意时刻触发并调用用户的超时回调,该回调可能销毁 Controller。
- 发送阶段完成。如果任何步骤出错,将调用 Channel::HandleSendFailed。
- 将序列化数据的 IOBuf 写入 Socket,并把 Channel::HandleSocketFailed 加入该 Socket 的 id_wait_list。当写入失败或在 RPC 完成前连接断开时,该回调会被调用。
- 同步调用中执行 Join correlation_id;否则 CallMethod() 直接返回。
- 向网络发送/从网络接收消息。
- 收到响应后,取出其中的 correlation_id,以 O(1) 时间复杂度找到关联的 Controller。该查找无需对全局 hashmap 加锁,扩展性很好。
- 按协议解析响应。
- 调用 Controller::OnRPCReturned,它可能重试出错的 RPC,或者完成本次 RPC。异步调用中会调用用户的 done。销毁 correlation_id 并唤醒 join 的线程。
最后修改于 2023 年 1 月 10 日:移除 incubator (devlive-community/knowforge#122) (7647361c1)]
评论
登录后参与评论