 KnowForge
高可用性
 师成· 更新于 2026-09-28· 阅读 6 分钟· 0 次阅读
Ozone 拥有两个元数据管理节点(Ozone Manager 负责键空间管理,Storage Container Manager 负责块空间管理)以及多个存储节点(Datanode)。数据借助 RAFT 共识算法在各个 Datanode 之间进行复制。
为避免出现任何单点故障,元数据管理节点同样应当采用 HA 部署方式。
Ozone Manager 和 Storage Container Manager 均支持 HA。在这种模式下,内部状态通过 RAFT(基于 Apache Ratis)进行复制。
本文档介绍 Ozone Manager(OM)的 HA 部署方式,SCM 的 HA 请参阅 SCM HA 文档。虽然两者可以各自独立部署 HA,但要实现可靠、完整的高可用部署,需要同时为这两个服务启用 HA。
Ozone Manager HA
单个 Ozone Manager 使用 RocksDB 将元数据(卷、桶、键)持久化存储在本地。HA 版本的 Ozone Manager 做的也是同样的事情,只不过所有数据都会借助 RAFT 共识算法复制到从属(follower)Ozone Manager 实例上。
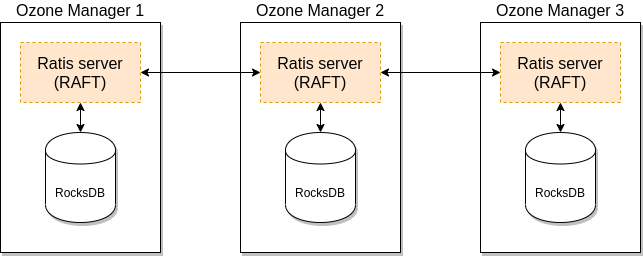
客户端连接到 Ozone Manager 主节点(Leader),由主节点处理请求并通过 RAFT 调度复制。当请求被复制到所有从节点后,主节点即可返回响应。
实现细节
只要请求被持久化到大多数节点的 RAFT 日志中,Raft 就能保证该请求的复制。为了让 Ozone Manager 获得高吞吐量,只要请求被写入 RAFT 日志,它就会返回响应。
RocksDB 实例由后台线程通过批量事务的方式更新(即所谓的"双缓冲":当其中一个缓冲区用于提交数据时,另一个缓冲区会收集下一次提交所需的所有新请求)。为了使所有数据在后台进程尚未写入的情况下也能对下一个请求可用,关键数据会被缓存在内存中。
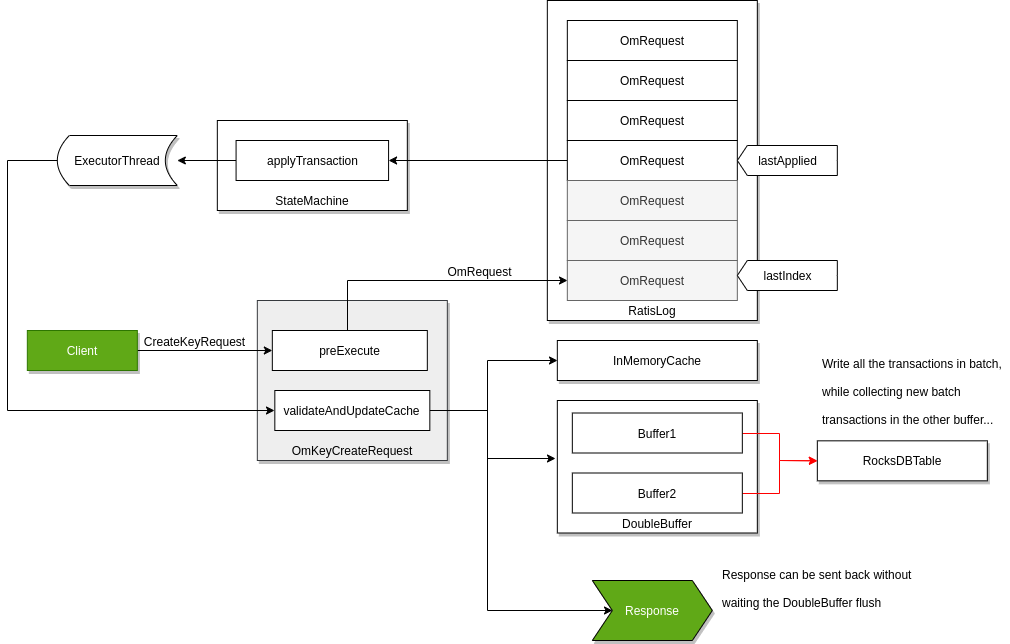
这一方案的细节在另一份设计文档中有专门讨论,它是 OM HA 设计中不可或缺的一部分。
落后 Ozone Manager 的自动快照安装
有时,OM 从节点可能会离线,或者远远落后于 OM 主节点的 raft 日志。此时,它无法通过逐条重放日志条目来轻松追赶。OM HA 实现为此类情况包含了自动快照安装与恢复流程。
工作方式如下:
- 主节点判定该从节点落后过多。
- 主节点通知从节点安装快照。
- 从节点从主节点下载并安装最新快照。
- 安装快照后,OM 从节点从新状态开始恢复正常运行和日志复制。
此逻辑实现在 OzoneManagerStateMachine.notifyInstallSnapshotFromLeader() 中;请参阅 2.0.0 版本中的代码。
请注意,用于 OM HA 状态同步的 Raft Snapshot 与用于数据备份和恢复的 Ozone Snapshot 是不同的。
在大多数场景中,落后的 OM 会自动恢复,即使它们错过了大量操作。只有在向集群添加新的 OM 节点时,才需要手动干预(例如运行 ozone om --bootstrap)。
关于 Ozone Manager(OM)快照磁盘空间的重要提示
当 Ozone Manager(OM)在 HA 环境中充当 follower 时,它会从 leader 下载快照 tar 包到本地元数据目录。因此,请务必确保 OM 磁盘至少有当前 OM 数据库大小 2 倍的可用空间,以容纳现有数据和传入的快照,从而防止磁盘空间不足问题并保持集群稳定性。
参考资料
- 设计文档 HDDS-505 Ozone Manager HA
- 有关 OM HA 快照安装问题的故障排查,请参阅故障排查文档。
- Ozone 发行版在
compose/ozone-om-ha目录下提供了一个 OM HA 配置示例,可在 Docker Compose 的帮助下进行测试。 - Apache Ratis 状态机 API 文档
评论
登录后参与评论