 KnowForge
Spark 扩展
Z-Ordering 支持
 师成· 更新于 2026-09-29· 阅读 4 分钟· 0 次阅读
登录后可跨设备保存划线和私人笔记登录
为了提升查询速度,Kyuubi 支持 Z-Ordering,以优化存储于各类存储系统、采用各种数据格式的数据的布局。
请查看我们的基准测试报告此处。
简介
下图展示了 Z-order 的工作流程。
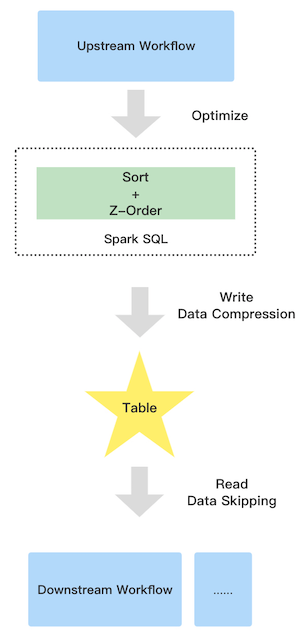
其中包含三个参与方:
上游
由于额外的排序操作,上游作业的运行速度会比之前稍慢一些
表
Z-order 具有良好的数据聚类效果,因此可以提升压缩比
下游
得益于数据跳过(data skipping),下游的读取性能得以提升。由于 Parquet 和 ORC 文件在写入数据时会自动收集数据统计信息(例如最小值和最大值),良好的数据聚类使得下推过滤器更加高效
支持的表格式
| 表格式 | 是否支持 |
|---|---|
| parquet | Y |
| orc | Y |
| json | N |
| csv | N |
| text | N |
支持的列数据类型
| 列数据类型 | 是否支持 |
|---|---|
| byte | Y |
| short | Y |
| int | Y |
| long | Y |
| float | Y |
| double | Y |
| boolean | Y |
| string | Y |
| decimal | Y |
| date | Y |
| timestamp | Y |
| array | N |
| map | N |
| struct | N |
| udt | N |
如何使用
该功能位于 Kyuubi 扩展中,因此你需要按照以下步骤将该扩展应用到 Spark。
- 添加扩展 jar:
copy $KYUUBI_HOME/extension/kyuubi-extension-spark-3-5* $SPARK_HOME/jars/ - 在
spark-defaults.conf中添加配置:spark.sql.extensions=org.apache.kyuubi.sql.KyuubiSparkSQLExtension
由于该扩展的限制,Z-order 仅适用于 Spark 3.2 及更高版本。
优化历史数据
如果你想优化表的历史数据,可以使用 OPTIMIZE ... 语法。由于 Spark SQL 不支持读取并覆盖同一数据源表,该语法仅支持优化 Hive 表。
语法
OPTIMIZE table_name [WHERE predicate] ZORDER BY col_name1 [, ...]注意,predicate 仅支持分区规范。
示例
OPTIMIZE t1 ZORDER BY c3;

OPTIMIZE t1 ZORDER BY c1,c2;

OPTIMIZE t1 WHERE day = '2021-12-01' ZORDER BY c1,c2;
优化增量数据
Kyuubi 支持针对增量数据(例如按时间分区的表)自动优化表。你唯一需要做的,就是将 Kyuubi 的相关属性添加到目标表的属性中:
ALTER TABLE t1 SET TBLPROPERTIES('kyuubi.zorder.enabled'='true','kyuubi.zorder.cols'='c1,c2');- 配置项
kyuubi.zorder.enabled用于决定该表是否允许 Kyuubi 通过 z-order 进行优化。 - 配置项
kyuubi.zorder.cols用于决定使用哪些列进行 z-order 优化。
Kyuubi 会在 SQL 编译期间检测这些表属性,并使用 z-order 对 SQL 进行优化,因此你可以在所有写入表的命令中享受 z-order,例如:
INSERT INTO TABLE t1 PARTITION() ...;

INSERT OVERWRITE TABLE t1 PARTITION() ...;

CREATE TABLE t1 AS SELECT ...;
评论
登录后参与评论
正在加载评论…