 KnowForge
Kyuubi 与 Spark Thrift JDBC/ODBC Server(STS)对比
 师成· 更新于 2026-09-29· 阅读 20 分钟· 0 次阅读
Kyuubi 与 Spark Thrift JDBC/ODBC Server(STS)的对比
Kyuubi 与 Spark Thrift JDBC/ODBC Server(STS)的对比
简介
Apache Spark 的 Thrift JDBC/ODBC Server 是 Apache Spark 社区基于 HiveServer2 实现的 Thrift 服务。它在设计上与 HiveServer2 无缝兼容,通过 JDBC 接口以纯 SQL 的方式为最终用户提供 Spark SQL 能力。这种"开箱即用"的模式最大限度地降低了用户使用 Spark 的门槛和成本。
Kyuubi 与 Spark 在这一目标上是一致的。除此之外,Kyuubi 还在多租户支持、服务可用性、服务并发能力、数据安全等方面进行了增强。
常见 Spark 作业使用方式的门槛
在这一部分中,最根本的问题是我们如何定义 Spark User。一般来说,Spark 用户是指直接调用 Spark API 的人,但从 Kyuubi 和 Spark ThriftServer 的角度来看,直接的 API 调用发生在服务端,Spark 用户则是通过更通用的 JDBC 规范和协议间接地与 Spark 后端进行交互。借助 JDBC 和 SQL,Kyuubi 与 Spark ThriftServer 让用户以与世界上大多数流行现代 DBMS 相同的方式进行交互。
直接使用 Spark API 对具有大数据背景的程序员来说很灵活,但对所有人可能并不友好。
高门槛
用户需要借助一定的编程框架,通过 Spark 提供的 Scala/Java/Python 接口来使用 Spark。此外,用户需要具备良好的大数据知识背景。例如,用户需要知道他们的应用将被提交到哪个平台——YARN、Kubernetes 或其他平台。他们还需要了解作业的资源消耗情况,例如 executor 的数量、每个 executor 的内存。如果他们使用了过多的资源,是否会影响其他关键任务?反之,集群资源是否会闲置和浪费?用户也很难正确配置成千上万个 Spark 配置项。像动态资源分配、推测执行(Speculation)这样的关键特性,一次性配置可能难以让所有人都受益。而像自适应查询执行这样的新特性,从其首次在 Spark 中发布到最终应用于最终用户,往往要经历漫长的历程。
不安全性
用户可以通过代码访问元数据和数据,数据安全无法得到保证。所有客户端配置都需要直接或间接地交给用户,这些配置可能包含敏感信息,并使所有后端服务完全暴露给用户。例如,在数据安全方面,Submarine Spark Security Plugin 结合 Apache Ranger 为 Apache Spark SQL 提供了 SQL 标准 ACL 管理。但最终,对于能够通过 Spark 代码编写并提交作业的程序员而言,这类安全特性充其量只是一种「君子协定」。
兼容性
客户端兼容性难以保证。当用户的 Spark 作业最终被调度到集群上运行时,会面临客户端环境与集群环境不一致、用户作业依赖、Spark 依赖与 Hadoop 集群依赖冲突等问题。当我们升级服务端组件(如 Spark、Hive、YARN 等)时,还必须尽可能地升级所有用户客户端及其传递依赖,这可能会引入大量不必要的兼容性测试工作,且很难做到完全的测试覆盖。
启动延迟
对于长期运行的 Spark 应用(如 Spark Structured Streaming),启动时间相对于整个生命周期来说可以忽略不计。在这种情况下,任务调度和计算完全在级别进行,延迟低、响应快。对于短期任务,启动时间则不可忽视,例如 SparkPi。相对而言,这个过程非常耗时,尤其是对于秒级和分钟级的计算任务。
Spark ThriftServer 本质上是一个处于多线程场景下的 Spark 应用。它在运行时预启动一个由一个 driver 和多个 executor 组成的分布式 SQL 引擎。在 SQL 解析层,该服务充分利用 Spark SQL 优化器;在计算执行层,由于 Spark ThriftServer 是常驻的,因此没有启动开销,并且在未启用 DRA 时,整个 SQL 计算过程处于纯线程调度模型,性能优异。
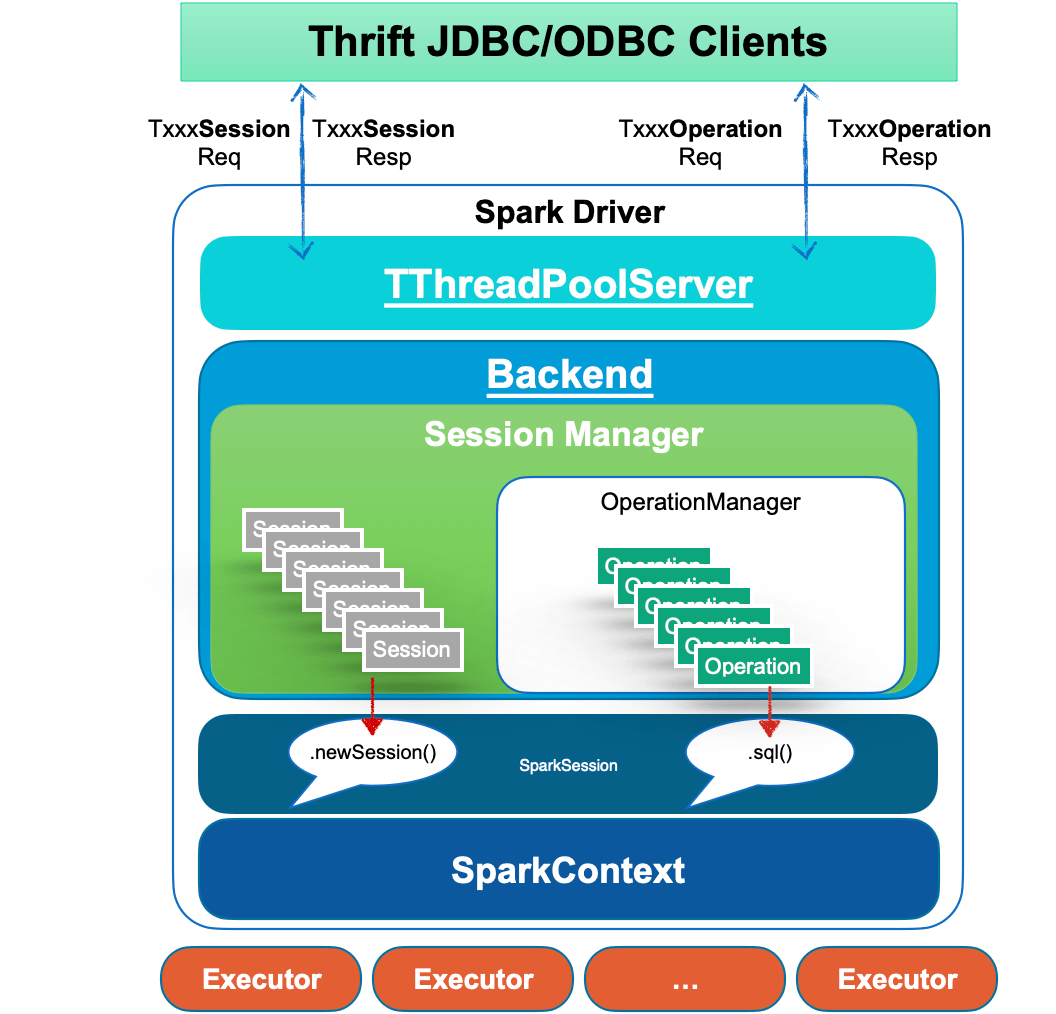
JDBC 连接和操作由前端线程池作为各种请求进行处理,然后调用后端的相应方法,绑定到 SparkSession 相关接口。例如,客户端的 DriverManager.getConnection 会在服务端调用 SparkSession.newSession(),客户端的所有查询都会异步提交到后端线程池,并由 SparkSession.sql(...) 执行。
首先,在该模式下,用户可以通过简单的 SQL 语言和 JDBC 接口与 Spark ThriftServer 交互,实现自身的业务逻辑。Spark ThriftServer 的基本容量规划、底层服务的整合以及各项优化都可以在服务端完成。有人可能会认为仅使用 SQL 无法满足所有业务需求,这确实没错,但该服务本身面向的是因查询速度而从 HiveServer2 迁移过来的用户。借助 UDF/UDAF 的支持,一些复杂逻辑仍然可以实现,因此 Spark ThriftServer 基本上能够处理大多数大数据处理工作负载。
其次,对 YARN、HDFS 和 Hive Metastore Server(HMS)等后端服务的所有配置工作都在 Spark ThriftServer 中完成,无需将后端服务的配置交给最终用户,这在一定程度上保障了数据安全。除此之外,服务器通常还具备身份认证/授权等能力,以保护数据安全。
最后,在服务端向后兼容的约束下,JDBC 接口协议和 C/S 架构基本可以保证客户端不存在兼容性障碍。用户只需选择合适版本的 JDBC 驱动即可,服务端升级不会导致接口不兼容。至于 Spark 版本升级可能带来的 SQL 兼容性问题,即便不使用 Spark ThriftServer 同样存在,且更难解决。此外,在 Spark ThriftServer 模式下,服务端可以预先采集全部 SQL,并在升级前完成验证。
Spark ThriftServer 的局限性
从上文 Spark ThriftServer 的基本架构可以看出,它本质上是一个 Spark 应用程序,在应对数千个客户端请求时通常存在明显的局限性。
Driver 瓶颈
Spark Driver 既需要扮演 Spark 应用程序调度器的角色,又要处理来自客户端的数千个连接和操作。在这种情况下,它很容易成为瓶颈。Spark 分析器在解析所有查询时所依赖的 Hive metastore 客户端只有一个,因此在访问 HMS 时会出现更为明显的并发问题。
资源隔离问题
过大的 Spark 作业会占用过多的 Spark ThriftServer 资源,导致其他作业延迟或卡住。
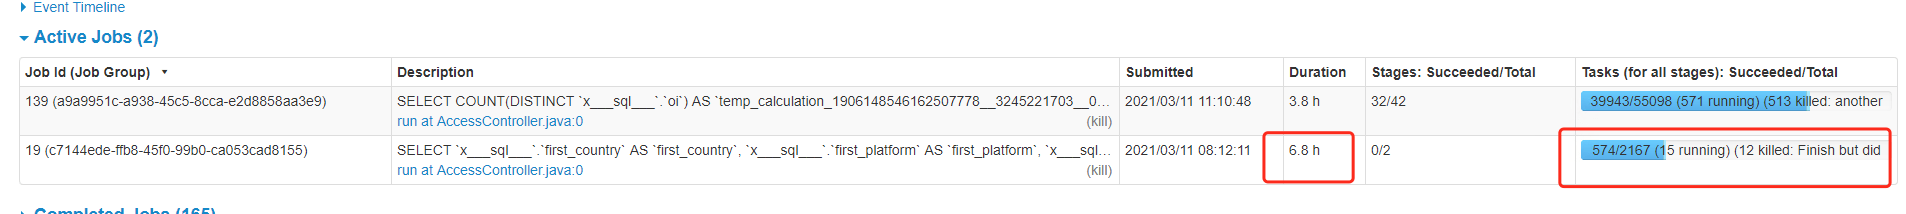
借助公平调度器(Fair Scheduler)池,Spark ThriftServer 具备了一定程度的资源隔离与共享能力。它会将查询发送到权重较高的池,以获取更多的执行器来执行。从本质上说,CPU、内存、IO 等资源的隔离应当由 YARN、Kubernetes 这类资源管理器来完成。在计算层做逻辑隔离很难取得良好效果——例如,Apache Impala 项目同样存在这个问题。此外,HMS、HDFS 单点访问的问题也难以避免,尤其是在读写动态分区表或处理包含大量 Union 的查询场景下。
多租户局限性
Spark ThriftServer 本身应当是一个支持多租户的系统,即可以接收来自不同客户端和用户的请求。然而,从 Spark 的设计角度来看,作为单个 Spark 应用实现的 Spark ThriftServer 无法完全支持多租户,因为整个应用只有一个全局唯一的用户名,驱动端和执行器端皆是如此。因此,它只能以单一租户的身份访问所有用户的数据。
Spark ThriftServer 占用单一资源队列(YARN 队列 / Kubernetes 命名空间),因此从资源隔离与共享的角度来看,难以细粒度地或弹性地控制每个租户可用资源池的大小。没有人愿意为了调整某个池的权重或增加总计算资源,就重启服务并让它停止对外服务。
高可用局限性
Spark ThriftServer 社区版不支持高可用(HA)。很难想象一个没有高可用能力的服务端应用如何能够满足 SLA 承诺。为 Spark ThriftServer 实现高可用并不困难,但颇为棘手。例如,已经有一个 JIRA 工单:SPARK-11100 并附带了对应的 pull request,参见 [SPARK-11100]。Spark ThriftServer 的高可用实现通常有两种方式,即 Active/Standby(主备)和 LoadBalancing(负载均衡)。
Active/Standby 模式由一个活跃的 Spark ThriftServer 和若干备用服务器组成。当活跃节点崩溃或挂起时,备用节点会触发领导者选举,成为新的活跃节点并接管服务。这里的问题显而易见:同一时刻只有一个活跃节点在运行,因此并发处理能力有限。当因软硬件故障发生故障切换时,所有当前连接和运行中的作业都会失败。这种故障切换对客户端用户来说代价高昂。客户端会同时重试,导致新选出的活跃服务器难以应对客户端重试的洪峰,很可能再次崩溃。无论是否启用 Spark 动态资源分配,备用节点都会造成集群资源的严重浪费。解决服务端单点问题更恰当的方案是自行加入负载均衡支持,这样当客户端请求增加时,我们可以对 Spark ThriftServer 进行水平扩展。不过,这种模式也有一定局限性。每个 Spark ThriftServer 都是有状态的,包含一些瞬时的数据或功能,例如某些全局临时视图、UDF 等,这些内容无法在两个服务器之间共享。而且连同计算资源一起扩展的成本也很高。
UDF 问题
对于 ADD JAR ... 或 CREATE TEMPORARY FUNCTION ... USING... 之类的操作,在 Spark ThriftServer 中类或 jar 可能会发生冲突,而且一旦冲突就没有删除的办法。此外,由于 UDF 是直接加载到 Spark ThriftServer 中的,如果其中包含某些非预期的或恶意的逻辑,例如调用 System.exit(-1),可能会直接导致服务终止;或者包含某些会影响服务端全局行为的操作,比如 Kerberos 认证。
Kyuubi 对比 Spark Thrift Server
这里也一并引入 HiveServer2,以便进行更全面的比较。
HiveServer2
(Hive on Spark) Spark ThriftServer Kyuubi
接口 HiveJDBC HiveJDBC HiveJDBC
SQL
语法 Hive QL Spark SQL Spark SQL
SQL
优化器 Hive 优化器 Spark SQL
Catalyst Spark SQL
Catalyst
SQL
解析与计划 服务端 服务端 引擎端
UDF
加载 服务端 服务端 引擎端
作业
提交 一个查询会被拆分为多个 Spark 应用,在服务器内称为 RemoteDriver 通过 Kyuubi 引擎使用不同策略实现隔离
1. USER 级别隔离,同一用户的不同 JDBC 连接共享归属于该用户的 Engine
2. CONNECTION 级别隔离,一个 JDBC 连接对应一个 Engine,该连接内的所有 SQL 均由同一 Engine 执行
Spark
兼容性 仅单一 版本 内置 多版本
Catalog
管理 HMS HMS HMS
高
可用性 支持 不支持 支持
多
租户 支持 不支持 支持
权限
控制 SQL 标准 细粒度 不支持 SQL 标准 细粒度
性能 一般 良好 良好
客户端
并发 高 低 高
查询排队 无 针对 Engine
资源
针对 Engine 的查询所使用的资源池的设置
计算
资源
管理 YARN 资源池 YARN、Kubernetes 等
资源
占用
时间 单个查询之内 永久占用 使用 Kyuubi Engine 申请与释放资源
1. 对于 CONNECTION 级别隔离,当 JDBC 连接断开时 Engine 即终止
2. 对于其他模式,当所有连接断开后 Engine 超时结束。
3. 所有隔离模式均支持 DRA
一致的接口
Kyuubi、Spark Thrift Server 与 HiveServer2 在接口和协议方面是完全一致的。因此,从使用者的角度来看,使用方式没有任何变化。与 HiveServer2 相比,前两者最显著的优势应在于性能上的提升。
从 SQL 语法兼容性的角度来看,Kyuubi 与 Spark Thrift Server 完全兼容 Spark SQL,因为它们都完全委托给 Spark SQL 的 Catalyst 层处理。Spark SQL 也完全支持 Hive QL 集合,仅在少数可枚举的 SQL 行为和语法上存在差异。
多租户架构
来自维基百科:“软件多租户”是指这样一种软件架构:同一软件的单个实例运行在服务器上,并同时为多个租户提供服务。按这种方式设计的系统通常被称为共享式(与专用式或隔离式相对)。
Kyuubi、Spark ThriftServer 与 HiveServer2 都是针对典型的多租户架构场景而设计的。
首先,我们需要考虑如何 1) 基于资源隔离,更安全、更高效地使用这些计算资源,以及 2) 如何让用户能够充分掌控属于自己的资源。
HiveServer2 本应是最灵活的一个。每条 SQL 都会被编程为若干 Spark 应用来执行,并且可以在执行前设置资源队列、内存等参数。但这种方式会导致 Spark 启动延迟极高,且无法高效利用资源。
Spark ThriftServer 则走向了另一个方向,因为它只对应一个 Spark 应用。由于应用已经预先启动,无法在用户侧接口中调整队列、内存等与资源相关的配置。查询可以被发送到预设的 Fair Scheduler Pools(公平调度器资源池)中,以实现隔离运行。Fair Scheduler Pools 只能在 Spark 应用内部提供较低程度的隔离,并且必须在 Spark ThriftServer 启动之前完成配置。
Kyuubi 通过另外两种系统实现的方式中和了这些方面。Kyuubi 基于 Kyuubi Engine 的概念来实现多租户特性,其中每个 Engine 即为一个 Spark 应用。
在 Kyuubi 的体系中,Engine 按租户隔离。租户(也称为用户)通过 JDBC 连接端到端统一且唯一。Kyuubi server 会识别并认证该用户,然后检索或创建属于该特定用户的 Engine。该用户将作为 Engine 的提交者,并且必须有权使用 YARN、Kubernetes 或本地机器等资源。在 Engine 内部,Engine 的用户(即 Spark User)也是同一个用户。当 Engine 执行来自 JDBC 连接的查询时,Engine 的用户也必须拥有访问数据的权限。此外,如果在此过程中需要访问元数据,我们还可以借助 Submarine Spark Security Plugin 在元数据层引入细粒度的 SQL 标准 ACL 管理。
Engine 有其生命周期,这与通过客户端配置指定的 kyuubi.engine.share.level 有关。例如,若设置为 CONNECTION,则会为每个 JDBC 连接创建相应的 Engine,并在关闭该连接时自动终止。又例如,若设置为 USER,则相应的 Engine 会被缓存,并与同一用户的所有 JDBC 连接共享,即使这些连接来自高可用(HA)模式下的不同 Kyuubi server。当所有会话关闭后,该 Engine 最终会超时退出。
由于需要创建 Engine,一方面我们可以在启动时配置所有 Spark 配置;另一方面,这确实会带来 Spark 应用启动引导的开销,但总体而言这只是一次性成本。该用户的所有查询或连接都将共享这个应用,运行的查询越多,启动引导开销的摊薄就越明显。
高可用能力
Spark ThriftServer 的高可用问题已在上一节中介绍,此处不再赘述。在 Kyuubi 中,我们以 LoadBlancing(负载均衡)的方式提供高可用能力。Kyuubi 非常轻量,因为它在启动时不会创建任何 Engine。添加 Kyuubi 高可用节点的成本很低,因此水平扩展并不会带来过重的负担。
客户端并发
HiveServer2 和 Spark ThriftServer 中查询的编译与优化都在服务端完成,而 Kyuubi 则在 Engine 端完成这些工作。这对于减轻服务端负载、提升客户端并发能力非常有帮助。同样属于计算阶段的任务调度也发生在 Kyuubi 的 Engine 端,其负担不像 Spark ThriftServer 那样沉重——后者中客户端并发与任务调度之间存在激烈的资源竞争。原则上,执行器数量越多,或处理的数据量越大,服务端所承受的压力就越大。
服务稳定性
客户端并发与任务调度之间的激烈竞争,会加剧 Spark ThriftServer 的 GC 问题和 OOM 风险。Kyuubi 由于实现了服务端与引擎的分离,在这方面不存在此类问题。UDF 风险同样无法威胁服务的稳定性:当用户加载并调用了一个无效的 UUDF 时,只会损坏其自身的 Engine,而不会影响其他用户或 Kyuubi 服务端。
总结
Kyuubi 在统一接口的基础上,以多租户模式扩展了 Spark ThriftServer 的使用,并借助多租户概念与集群管理器交互,最终获得了资源共享/隔离和数据安全的能力。Kyuubi Server 与 Engine 的松耦合架构,极大地提升了服务本身的并发能力和稳定性。
评论
登录后参与评论