 KnowForge
架构
 师成· 更新于 2026-09-29· 阅读 10 分钟· 0 次阅读
简介
Kyuubi 是一个高性能的通用 JDBC 和 SQL 执行引擎。Kyuubi 的目标是让用户能够像处理普通数据一样处理大数据。
它提供标准化的 JDBC 接口,使大数据场景下的数据访问简单易用。最终用户可以专注于开发业务系统和挖掘数据价值,而无需感知底层的大数据平台(计算引擎、存储服务、元数据管理等)。
Kyuubi 依赖 Apache Spark 提供高性能的数据查询能力,引擎能力的每一次提升都能帮助 Kyuubi 的性能实现质的飞跃。此外,Kyuubi 通过引擎缓存的方式提升即席查询的响应速度,并通过水平扩展和负载均衡来增强并发能力。
它提供完善的认证与鉴权服务,保障数据和元数据的安全。
它提供强大的高可用性和负载均衡能力,帮助您保障 SLA 承诺。
它提供两级弹性资源管理架构,在覆盖交互式、批处理、点查和全表扫描等各类场景的性能与响应需求的同时,有效提升资源利用率。
它拥抱 Spark 并在其之上构建生态系统,使 Kyuubi 能够快速扩展其现有生态系统并引入新特性,例如云原生支持和 Data Lake/Lake House 支持。
Kyuubi 的愿景是基于 Apache Spark 和数据湖技术,统一入口,打造理想的数据湖管理平台。它能够以纯 SQL 的方式支持数据处理(如 ETL)和数据分析(如 BI)。所有工作负载都可以在同一个平台上完成,使用同一份数据,通过同一个 SQL 接口。
架构总览
Kyuubi 系统的基础技术架构如下图所示。
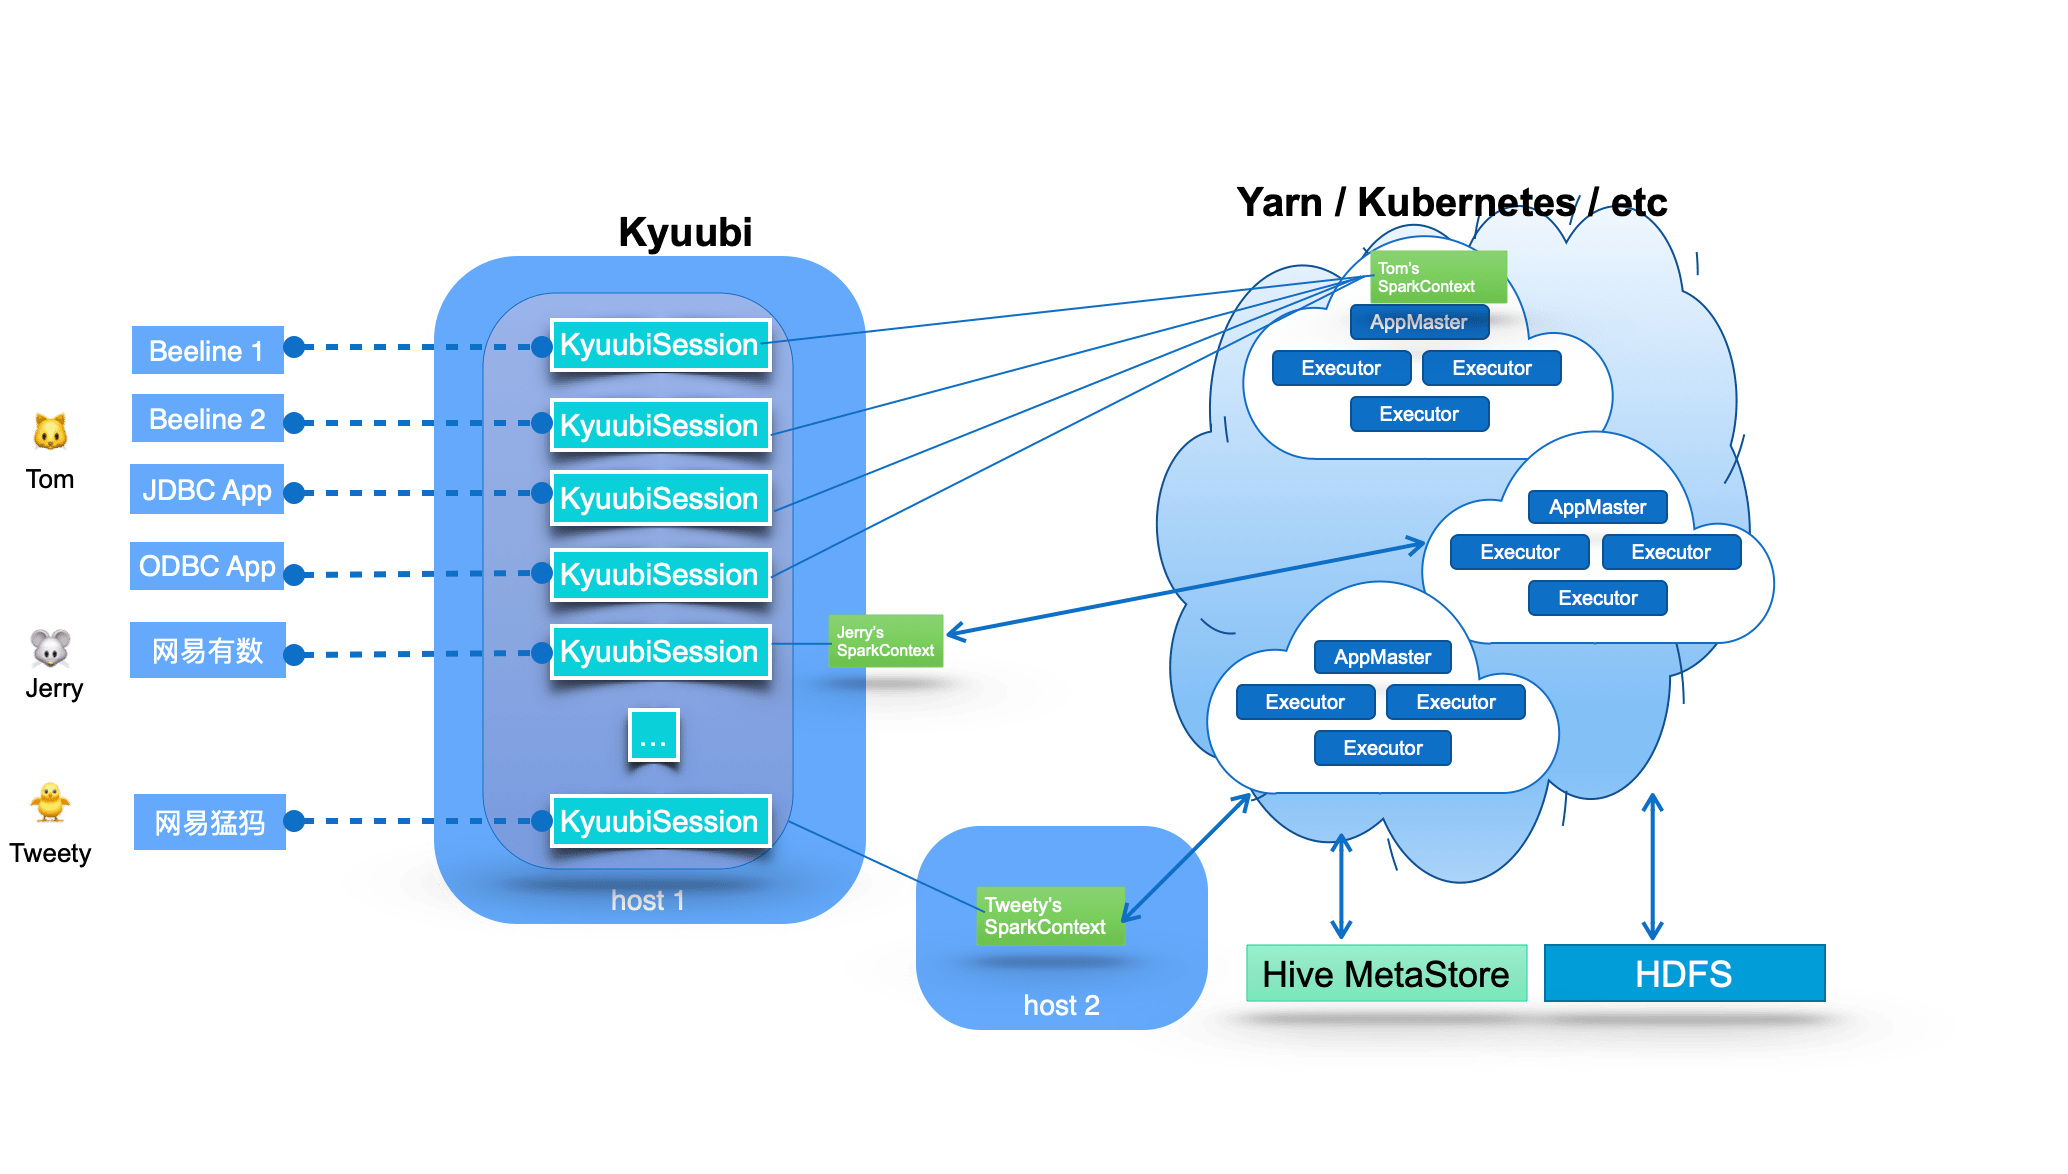
图中中间部分展示了 Kyuubi Server 的核心组件,它负责处理图左侧所示客户端的连接请求和执行请求。在 Kyuubi 内部,这些连接请求以 Kyuubi 会话(Session)的形式维护,执行请求则由绑定到相应会话的 Kyuubi 操作(Operation)来支持。
Kyuubi Session 的创建可以分为两种情况:轻量级和重量级。大多数会话创建都是轻量级的,用户不会感知。唯一的重量级情况是用户的共享域中没有已实例化或缓存的 SparkContext,这通常发生在用户首次连接或长时间未连接时。这种一次性的会话维护成本模型能够满足大多数即席查询的快速响应需求。
Kyuubi 以松耦合的方式维护与 SparkContext 的连接。这些 SparkContext 可以是由该服务实例在客户端部署模式下本地创建的 Spark 程序,也可以是在 YARN 或 Kubernetes 集群中以集群部署模式运行的程序。在高可用模式下,这些 SparkContext 也可以由运行在其他机器上的其他 Kyuubi 实例创建,并由本实例共享使用。
这些 SparkContext 实例本质上是由 Kyuubi 服务托管的远程查询执行引擎程序。这些程序基于 Spark SQL 实现,能够端到端地完成 SQL 语句的编译、优化与执行,并与元数据服务(如 Hive Metastore)和存储服务(如 HDFS)进行必要的交互,从而充分发挥 Spark SQL 的能力。它们可以自行管理生命周期、自行缓存与回收,并且不受 Kyuubi 服务器故障转移(failover)的影响。
接下来,让我们分享一些 Kyuubi 的关键设计思想。
统一接口
Kyuubi 实现了 Hive Service RPC 模块,提供了与 HiveServer2 和 Spark Thrift Server 相同的数据访问方式。在客户端,你仅需通过 Hive JDBC 模块,即可构建出色的业务报表、BI 应用,甚至 ETL 作业。
你只需要熟悉结构化查询语言(SQL)和 Java 数据库连接(JDBC),就能处理海量数据。这有助于你专注于业务系统的设计与实现。
- SQL 是访问关系型数据库的标准语言,在大数据生态中同样广受欢迎。事实证明,人人都懂 SQL。
- JDBC 为工具/数据库开发者提供了标准 API,使得使用纯 Java API 编写数据库应用成为可能。
- 市面上有大量免费或商业的 JDBC 工具可供选择。
运行时资源弹性
Kyuubi 与 Spark Thrift Server(STS)最显著的区别在于,STS 是一个单一的 Spark 应用程序。例如,如果它运行在 Apache Hadoop YARN 集群上,那么该应用程序同时也只是一个 YARN 应用程序,创建之后只能存在于 YARN 集群中某个特定的固定队列中。而 Kyuubi 支持提交多个 Spark 应用程序。
在这种情况下,YARN 在资源管理方面失去了其作为资源管理器的作用,也无法发挥相应的资源隔离与资源共享功能。当来自客户端的用户拥有不同的资源队列权限时,STS 将无法应对这种场景。
对于数据访问而言,单个 Spark 应用程序全局只有一个用户,即 sparkUser,我们不得不授予它类似超级用户的权限,以便它代表不同的客户端用户执行数据访问操作,这在生产环境中是一种过于不安全的做法。
Kyuubi 根据客户端的连接请求创建不同的 Spark 应用,这些应用可以放置在不同的共享域中,供其他连接请求复用。
Kyuubi 在启动阶段不会占用集群管理器(例如 YARN)的任何资源,并且当没有任何活动会话与 SparkContext 交互时,它会归还所有资源。
Spark 还提供了动态资源分配,可根据工作负载动态调整应用所占用的资源。这意味着当资源不再被使用时,应用可以将其归还给集群,并在之后有需求时再次申请。在多个应用共享 Spark 集群资源的场景下,这一特性非常实用。
借助这些特性,Kyuubi 提供了两级弹性资源管理架构,从而有效提升资源利用率。
例如,
./beeline -u "jdbc:hive2://kyuubi.org:10009/;\
hive.server2.proxy.user=tom#\
spark.yarn.queue=thequeue;\
spark.dynamicAllocation.enabled=true;\
spark.dynamicAllocation.maxExecutors=500;\
spark.shuffle.service.enabled=true;\
spark.executor.cores=3;\
spark.executor.memory=10g"
如果名为 tom 的用户打开上述连接,Kyuubi 将尝试在 Yarn 集群中名为 thequeue 的队列里创建一个 Spark SQL 引擎应用,其 executor 数量为 [3, 500](每个 executor 占用 3 核、10g 内存)。
一方面,由于 tom 启用了 Spark 的动态资源申请特性,Spark 会根据 SQL 操作的规模以及队列中的可用资源,在程序内部高效地申请和回收 executor。另一方面,当 Kyuubi 发现该应用长时间空闲时,也会回收其应用。
高可用与负载均衡
对于企业级服务,服务等级协议(SLA)的承诺必须非常高,并发能力也需要足够健壮,以支撑整个企业的请求。作为单个 Spark 应用且不具备高可用能力,Spark Thrift Server 很难满足 SLA 和并发需求。当存在大量查询请求时,元数据服务访问、调度以及 Spark Driver 的内存压力,或应用整体计算资源的限制,都可能成为瓶颈。
Kyuuba 基于 Zookeeper 提供了高可用和负载均衡解决方案,如下图所示。
让我们基于上图自上而下地逐步拆解。
- 图的最上方是客户端层。客户端可以从服务发现层的命名空间中找到多个已注册的 Kyuubi 实例(k.i.),然后选择其中一个进行连接。注册到同一命名空间的 Kyuubi 实例之间具备相互负载均衡的能力。
- 被选中的 Kyuubi 实例会从服务发现层的引擎命名空间(engine-namespace)中挑选一个可用的引擎实例(e.i.)来建立连接。如果没有找到可用实例,它会创建一个新实例,等待引擎完成注册,然后再进行连接。
- 如果同一个人请求新建连接,该连接可能会连接到相同或另一个 Kyuubi 实例,但引擎实例会被复用。
- 对于不同用户的连接,则会重复步骤 2 和步骤 3。这是因为在服务发现层中,用于存储引擎实例地址的命名空间默认是按用户隔离的,不同用户无法跨命名空间访问他人的实例。
认证与授权
在安全集群中,服务应当能够识别并认证调用方。因为用户自称的身份未必属实。Kyuubi 的认证过程用于验证客户端与 Kyuubi 服务器通信时所使用的用户身份。一旦验证通过,客户端与服务器之间将建立受信任的连接;否则,它们将被拒绝。
通过认证的客户端用户也将成为创建关联引擎实例的用户,因此可以对数据库对象或存储应用授权。我们还创建了 Submarine: Spark Security 外部插件,以实现基于 SQL 标准的细粒度授权。
结论
Kyuubi 是一个建立在 Apache Spark™ 之上的、用于大规模数据处理与分析的统一多租户 JDBC 接口。它扩展了 Spark Thrift Server 在企业应用中的使用场景,其中最重要的一项是多租户支持。
评论
登录后参与评论