 KnowForge
概述
 师成· 更新于 2026-09-28· 阅读 5 分钟· 0 次阅读
表迁移
Apache Iceberg 支持将其他格式的现有表转换为 Iceberg 表。本节介绍表迁移的基本概念、迁移方式,以及 Iceberg 中已有的实现。
迁移方式
表迁移有两种执行方式:全量数据迁移和原地元数据迁移。
全量数据迁移会将源表中的所有数据文件复制到新的 Iceberg 表中。这种方式使新表与源表完全隔离,但速度较慢,并且会使存储空间翻倍。在实际应用中,用户可以使用 Create-Table-As-Select、INSERT 以及变更数据捕获(CDC)管道等操作来执行此类迁移。
原地元数据迁移会在保留现有数据文件的基础上,在其之上引入 Iceberg 元数据。这种方式不仅更快,还无需复制数据。然而,新表与源表并未完全隔离。换言之,如果有任何进程对源表的数据文件执行了清理(vacuum),新表也会受到影响。
本文档将重点介绍原地元数据迁移。

Apache Iceberg 支持原地元数据迁移方式,其中包含三个重要操作:快照表(Snapshot Table)、迁移表(Migrate Table) 和 添加文件(Add Files)。
快照表
快照表操作会创建一个名称不同的新 Iceberg 表,其架构与分区方式与源表相同,在操作过程中及操作完成后源表保持不变。
- 创建一个与源表具有相同元数据(架构、分区规范等)但名称不同的新 Iceberg 表。源表上的读取方和写入方可以继续正常工作。
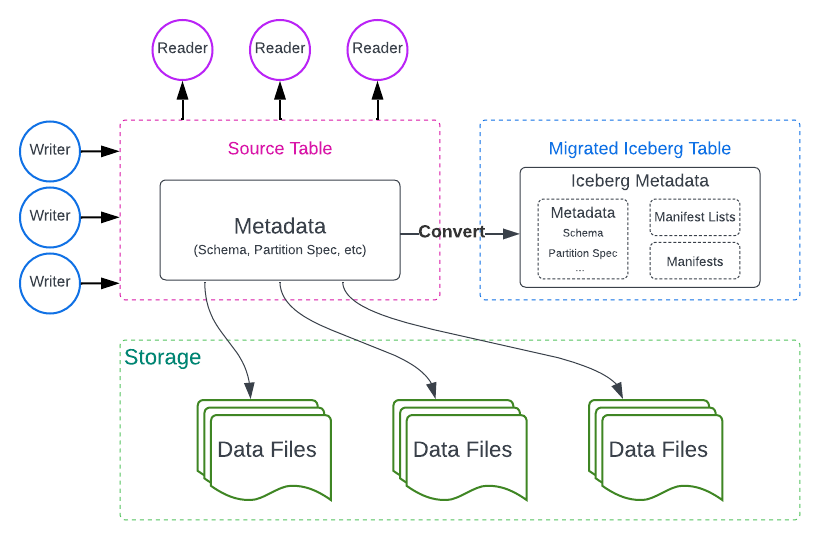
- 将所有分区中的全部数据文件提交到新的 Iceberg 表中。源表保持不变,读取方可以切换到新的 Iceberg 表。

- 最终,所有写入方都可以切换到新的 Iceberg 表。当所有写入方都迁移到新的 Iceberg 表后,即可认为迁移过程完成。
迁移表
迁移表操作同样会创建一个与源表架构和分区方式相同的新 Iceberg 表。不过,在该操作执行期间,它会锁定源表并将其从目录(catalog)中删除。因此,在执行迁移表操作之前,必须停止所有针对源表进行的修改操作。
停止所有与源表交互的写入者。同样支持 Iceberg 的读取者可以继续读取。

- 创建一个与源表具有相同标识符和元数据(schema、分区规范等)的新 Iceberg 表。重命名源表作为备份,以便在失败时进行回滚。

- 将所有分区中的全部数据文件提交到新的 Iceberg 表中。删除源表。写入者即可开始向新的 Iceberg 表写入数据。

添加文件
在初始步骤(快照表或迁移表)之后,通常会发现一些尚未迁移的数据文件。这些文件往往来自在迁移期间或迁移之后继续向源表写入的并发写入者。实际上,这些文件可能是 Hive 表中的新数据文件,也可能是 Delta Lake 表的新快照(版本)。添加文件操作对于将这些文件纳入 Iceberg 表至关重要。
从其他表格式迁移
评论
登录后参与评论