 KnowForge
分支与标签
 师成· 更新于 2026-09-28· 阅读 10 分钟· 0 次阅读
分支与标记
概述
Iceberg 表元数据维护着一份快照日志,用于记录应用于表的变更。快照是 Iceberg 中的基本概念,因为它们是读隔离和时间旅行查询的基础。为了控制元数据大小和存储成本,Iceberg 提供了快照生命周期管理过程,例如 expire_snapshots,用于根据表的快照保留属性移除未使用的快照以及不再需要的数据文件。
为了实现更精细的快照生命周期管理,Iceberg 支持分支(branch)和标记(tag),它们是指向快照的具名引用,并各自拥有独立的生命周期。该生命周期由分支和标记级别的保留策略来控制。 分支是相互独立的快照谱系,并指向该谱系的头部。分支和标记具有最大引用时长属性,用于控制对快照本身的引用应在何时过期。分支还具有保留属性,用于定义分支上要保留的最少快照数量,以及分支上要保留的单个快照的最大存活时长。运行 expireSnapshots 过程时会使用这些属性。有关 expireSnapshots 算法的详细信息,请参阅规范。
使用场景
分支与标记可用于满足 GDPR(通用数据保护条例)的要求,以及为审计保留重要的历史快照。分支还可以作为数据工程工作流的一部分,为测试和验证新任务创建实验性分支。下面给出一些示例,说明分支与标记如何促进这些使用场景。
历史标记
标记可用于为审计目的保留重要的历史快照。
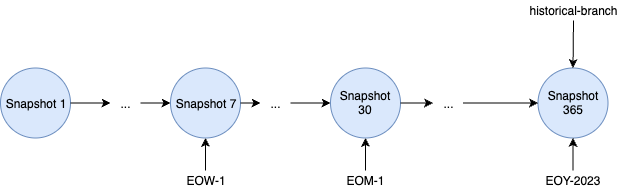
上图演示了通过 Spark SQL 定义如下保留策略,以保留重要的历史快照:
每周保留 1 个快照,持续 1 个月。这可以通过为每周的快照打标记,并将标记的保留时长设置为一个月来实现。快照将被保留,分支引用本身将保留 1 周。
-- 为第一个周末快照创建标记。将该快照保留一周
ALTER TABLE prod.db.table CREATE TAG `EOW-01` AS OF VERSION 7 RETAIN 7 DAYS;
每月保留 1 个快照,持续 6 个月。这可以通过为每月的快照打标记,并将标记的保留时长设置为 6 个月来实现。
-- 为第一个月末快照创建标记。将该快照保留 6 个月
ALTER TABLE prod.db.table CREATE TAG `EOM-01` AS OF VERSION 30 RETAIN 180 DAYS;
每年保留 1 个快照,永久保留。这可以通过为每年的快照打标记来实现。分支和标记的默认保留时长为永久。
-- 为年末创建一个标签,并永久保留。
ALTER TABLE prod.db.table CREATE TAG `EOY-2023` AS OF VERSION 365;
创建一个临时的 “test-branch”,保留 7 天,并在该分支上保留最近的 2 个快照。
-- Create a branch "test-branch" which will be retained for 7 days along with the  latest 2 snapshots
ALTER TABLE prod.db.table CREATE BRANCH `test-branch` RETAIN 7 DAYS WITH SNAPSHOT RETENTION 2 SNAPSHOTS;
审计分支

上图展示了使用审计分支来验证写入工作流的示例。
首先确保已设置
write.wap.enabled。ALTER TABLE db.table SET TBLPROPERTIES ( 'write.wap.enabled'='true' );从快照 3 创建
audit-branch,该分支将被写入数据并保留 1 周。ALTER TABLE db.table CREATE BRANCH `audit-branch` AS OF VERSION 3 RETAIN 7 DAYS;写入操作在独立于主表历史的
audit-branch上进行。-- WAP 分支写入 SET spark.wap.branch = audit-branch INSERT INTO prod.db.table VALUES (3, 'c');验证工作流可以对
audit-branch的状态进行验证(例如数据质量检查)。验证完成后,可以将主分支
fastForward到audit-branch的最新位置,从而更新主表状态。CALL catalog_name.system.fast_forward('prod.db.table', 'main', 'audit-branch');1 周后运行
expireSnapshots时,该分支引用将被移除。
使用方式
Iceberg Java 库以及 Spark 和 Flink 引擎集成均支持创建、查询分支与标签,以及向分支与标签写入数据。
使用分支和标签时的 Schema 选择
需要理解的重要一点是:表所跟踪的 schema 在所有分支上都是有效的。使用分支时,采用的是表的 schema,因为向分支写入数据时校验的正是这个 schema。另一方面,查询标签时使用的是快照的 schema,即该快照创建时所指向的 schema id。
以下示例展示了使用分支时实际使用的 schema。
创建一个表并插入一些数据:
CREATE TABLE db.table (id bigint, data string, col float);
INSERT INTO db.table VALUES (1, 'a', 1.0), (2, 'b', 2.0), (3, 'c', 3.0);
SELECT * FROM db.table;
1   a   1.0
2   b   2.0
3   c   3.0
创建一个指向当前快照的分支 test_branch,并从该分支读取数据:
ALTER TABLE db.table CREATE BRANCH test_branch;

SELECT * FROM db.table.branch_test_branch;
1   a   1.0
2   b   2.0
3   c   3.0
修改表结构,删除 col 列并新增一个名为 new_col 的列:
ALTER TABLE db.table DROP COLUMN col;

ALTER TABLE db.table ADD COLUMN new_col date;

INSERT INTO db.table VALUES (4, 'd', date('2024-04-04')), (5, 'e', date('2024-05-05'));

SELECT * FROM db.table;
1   a   NULL
2   b   NULL
3   c   NULL
4   d   2024-04-04
5   e   2024-05-05
使用以下任一语句查询分支的 HEAD,将返回基于表的 schema 的数据:
SELECT * FROM db.table.branch_test_branch;
1   a   NULL
2   b   NULL
3   c   NULL

SELECT * FROM db.table VERSION AS OF 'test_branch';
1   a   NULL
2   b   NULL
3   c   NULL
使用快照 ID 执行时间旅行查询时,将使用该快照的 schema:
SELECT * FROM db.table.refs;
test_branch BRANCH  8109744798576441359 NULL    NULL    NULL
main        BRANCH  6910357365743665710 NULL    NULL    NULL


SELECT * FROM db.table VERSION AS OF 8109744798576441359;
1   a   1.0
2   b   2.0
3 c 3.0写入分支时,会使用表的 schema 进行校验:
INSERT INTO db.table.branch_test_branch VALUES (6, 'e', date('2024-06-06')), (7, 'g', date('2024-07-07'));

SELECT * FROM db.table.branch_test_branch;
6   e   2024-06-06
7   g   2024-07-07
1   a   NULL
2   b   NULL
3   c   NULL
评论
登录后参与评论