 KnowForge
Bolt 快速开始
 qianmoQ· 更新于 2026-10-02· 阅读 7 分钟· 0 次阅读
快速开始:使用 Bolt 后端测试 Gluten
本指南以任务为导向,带你快速验证 Gluten Bolt 后端在 spark-shell(本地模式)和 spark-submit(集群模式)下是否正常工作,前提是已经构建好 Gluten JAR。
1. 前置条件(快速检查清单)
在开始之前,请确保您已具备以下条件:
兼容的环境:您的构建和运行环境必须满足 Bolt 的要求:
- 操作系统:Linux
- 编译器:GCC 10、11 或 12;或 Clang 16
- 依赖项:Python 3(配合 virtualenv 或 Conda)以及 Conan
- 内核:建议使用 Linux 内核 > 5.4 以启用
io_uring,从而获得更好的 I/O 性能。
包含 Bolt 的 Gluten JAR:一个已成功使用 Bolt 后端构建的 Gluten JAR 文件。该文件应包含
libbolt_backend.so。
注意:本指南不会重复完整的构建流程。如需从头开始构建,请参阅 Gluten 仓库中的迁移与构建文档:
2. 定位并验证 Gluten JAR
所有测试都依赖于一个包含 Bolt 后端的 Gluten JAR。该文件通常位于 Gluten 项目的 output/ 目录中。
使用以下命令查找该 JAR,并将其路径设置为环境变量以便后续使用:
```bash linenums=”1”
设置 Gluten 项目输出目录的路径
export GLUTEN_JAR=$(ls /path/to/your/gluten/output/gluten-spark*.jar | head -n 1)
验证路径是否设置正确
echo “Found Gluten JAR at: ${GLUTEN_JAR}”
**How to confirm the JAR contains Bolt?**

If you are unsure whether your JAR was built for Bolt, run this command. If it outputs a line containing `libbolt_backend.so`, the JAR is correct.

```bash
unzip -l "${GLUTEN_JAR}" | grep libbolt_backend.so
3. 本地 spark-shell 冒烟测试
使用 spark-shell 是验证 Bolt 后端是否已在本地机器上激活的最快方式。
3.1. 启动命令模板
启动一个已启用 Gluten 和 Bolt 的 spark-shell 会话。请确保 GLUTEN_JAR 和 JAVA_HOME 已正确设置。
# Ensure GLUTEN_JAR is set
if [ -z "${GLUTEN_JAR}" ]; then echo "Error: GLUTEN_JAR is not set." >&2; exit 1; fi

spark-shell \
  --master local[4] \
  --driver-memory 4G \
  --conf spark.plugins=org.apache.gluten.GlutenPlugin \
  --conf spark.memory.offHeap.enabled=true \
  --conf spark.memory.offHeap.size=10g \
  --conf spark.shuffle.manager=org.apache.spark.shuffle.sort.ColumnarShuffleManager \
  --conf spark.driver.extraClassPath=${GLUTEN_JAR} \
  --conf spark.executor.extraClassPath=${GLUTEN_JAR} \
  # For Java 11, set following two options
  --conf spark.driver.extraJavaOptions=-Dio.netty.tryReflectionSetAccessible=true \
  --conf spark.executor.extraJavaOptions=-Dio.netty.tryReflectionSetAccessible=true \
  --jars ${GLUTEN_JAR}
3.2. 示例查询与验证
进入 spark-shell 后,运行以下 Scala 代码。它会创建一个小型 Parquet 文件,然后对其进行读取、过滤和聚合。
准备测试数据(在
spark-shell中运行):import spark.implicits._ // Create a simple DataFrame val data = (1 to 1000).map(i => (i, s"name_$i", i % 10)) val df = spark.createDataFrame(data).toDF("id", "name", "category") // Save it as a Parquet file val parquetPath = "/tmp/bolt_quick_test.parquet" df.write.mode("overwrite").parquet(parquetPath) println(s"Test Parquet file written to: ${parquetPath}")执行查询并查看执行计划:
// Read the Parquet file
val inputDF = spark.read.parquet(parquetPath)

// Perform a filter and aggregation query
val resultDF = inputDF
  .filter($"category" > 5)
  .groupBy("category")
  .count()

// Print the execution plan
resultDF.explain()

// Show the results
resultDF.show()
验证 Bolt 已生效:
关键在于查看 Spark UI(ip:4040)的
SQL/DataFrame选项卡。如果看到 *Transformer,例如FilterExecTransformer、ProjectExecTransformer,则说明 Gluten 已经将计算下推到 Bolt 后端执行。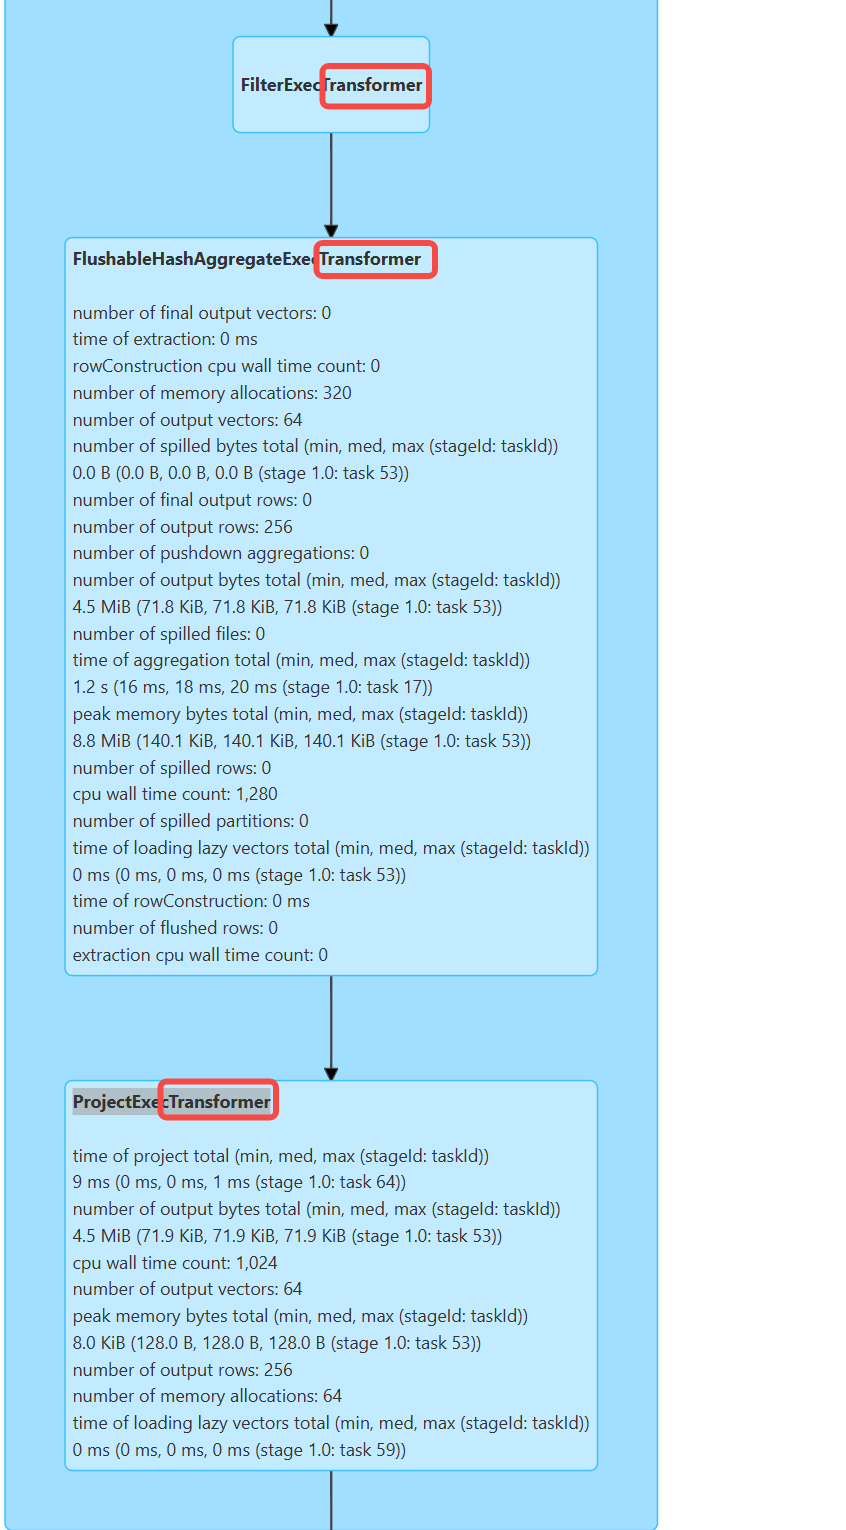
评论
登录后参与评论