 KnowForge
调试服务器问题
 qianmoQ· 更新于 2026-10-05· 阅读 10 分钟· 0 次阅读
调试服务端问题
学习如何调试服务端问题。
1. 检查工作线程数量
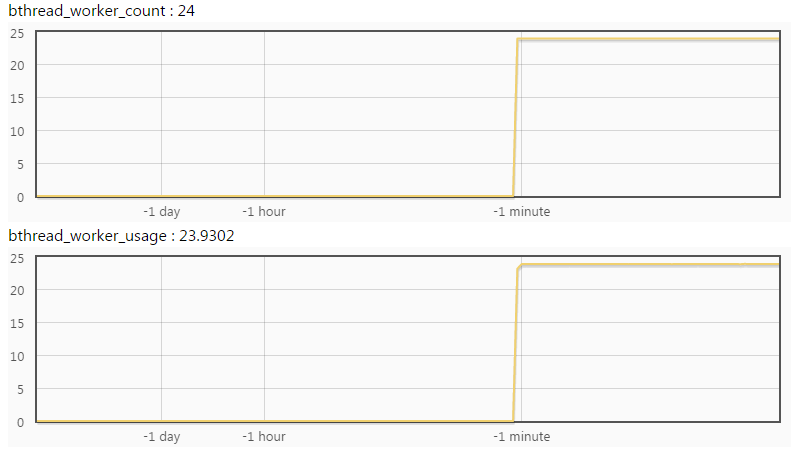
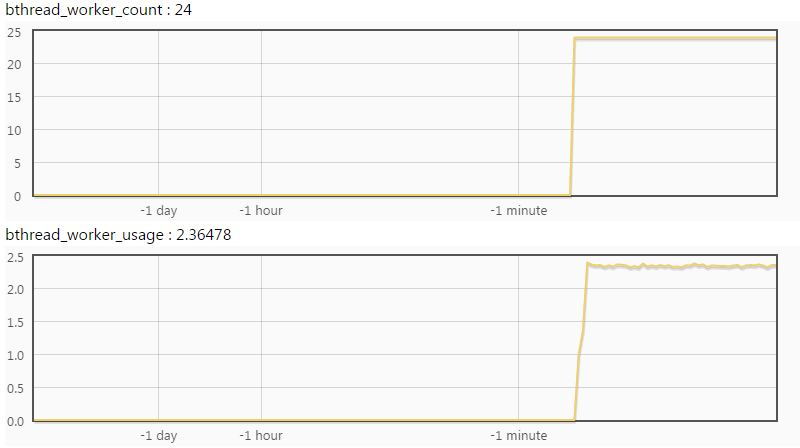
查看 /vars/bthread_worker_count 和 /vars/bthread_worker_usage,它们分别表示工作线程的总数和正在使用的数量。
使用数量与总数接近,说明工作线程不够用。
例如,下图中共有 24 个工作线程,其中 23.93 个工作线程正在被使用,说明所有工作线程都已满负荷,数量不足。
下图中有 2.36 个工作线程正在被使用,显然工作线程是足够的。
将 /vars/bthread_worker_count;bthread_worker_usage?expand 放在服务地址之后即可直接查看这两张图,就像 this 一样。
2. 检查 CPU 使用率
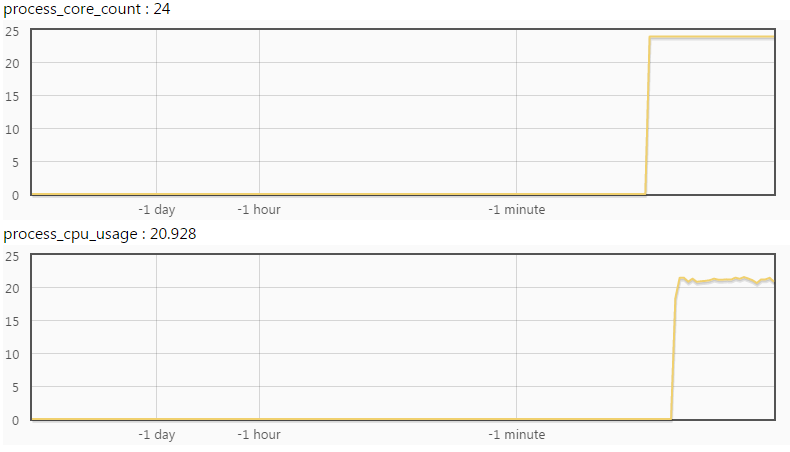
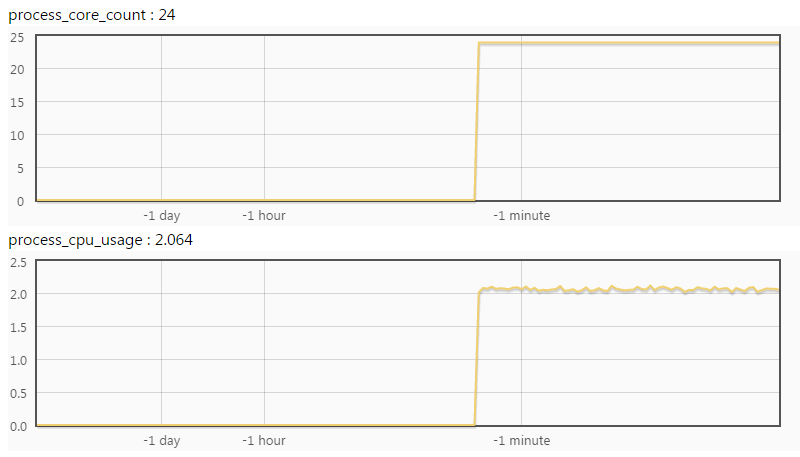
查看 /vars/system_core_count 和 /vars/process_cpu_usage,它们分别表示可用的 CPU 核心数和正在使用的核心数。
使用数量与总数接近,说明 CPU 已经足够。
下图中核心数为 24,而正在使用的核心数为 20.9,说明 CPU 是瓶颈。
下图中正在使用的核心数为 2.06,说明 CPU 是充足的。
3. 定位问题
process_cpu_usage 的数值接近 bthread_worker_usage,说明这是 CPU 密集型程序,工作线程大部分时间都在进行计算。
process_cpu_usage 的数值远小于 bthread_worker_usage,说明这是 IO 密集型程序,工作线程大部分时间都处于阻塞状态。
(1 - process_cpu_usage / bthread_worker_usage) 即为阻塞所占的时间比例。例如,如果 process_cpu_usage = 2.4,bthread_worker_usage = 18.5,那么工作线程有 87.1% 的时间花在阻塞上。
3.1 定位 CPU 密集型问题
可能的原因是单机性能不佳,或者上游流量分布不均。
排除上游流量分布不均的嫌疑
进入不同服务的 [vars]((http://brpc.baidu.com:8765/vars) 页面查看 qps 是否符合预期,如下所示:
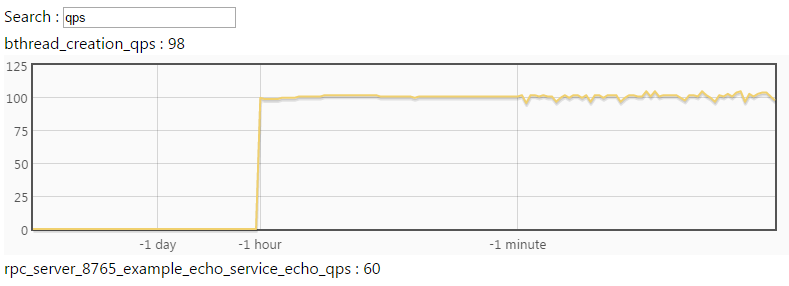
或者直接在命令行中使用 curl 访问,像这样:
$ curl brpc.baidu.com:8765/vars/*qps*
bthread_creation_qps : 95
rpc_server_8765_example_echo_service_echo_qps : 57
如果不同机器的分布确实不均匀且难以解决,可以考虑使用 Limit concurrency。
提升单台服务器的性能
请使用 CPU profiler 来分析程序的热点,并用数据来指导优化。一般来说,可以在 CPU 密集型程序中找到一些较大且明显的热点。
3.2 定位 IO 密集型问题
可能的原因:
- 工作线程不够。
- 访问下游服务器的客户端不支持 bthread,导致延迟过长。
- 内部锁、IO 等造成的阻塞。
如果阻塞不可避免,请考虑使用异步方式。
排除工作线程不足的嫌疑
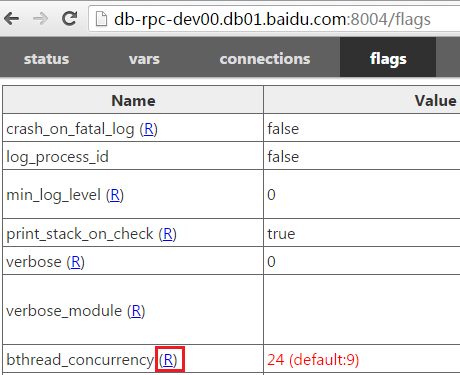
如果工作线程不够,你可以尝试动态调整线程数量。切换到 /flags 页面,点击 bthread_concurrency 右侧的 (R):
输入新的线程数量并确认:

返回 /flags 页面,可以看到 bthread_concurrency 已变为新的值。

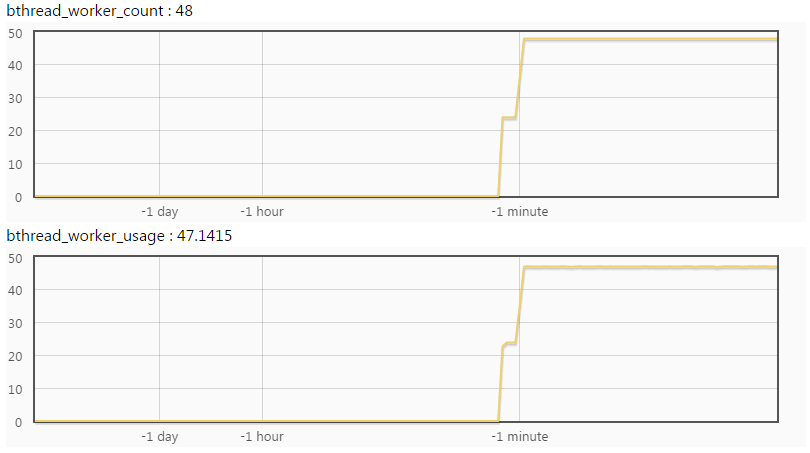
然而,调整线程数量可能没有用。如果工作线程在访问下游时被大量阻塞,调整线程数量是无效的,因为真正的瓶颈在后端,将线程数量调大只会让每个线程的阻塞时间变得更长。
例如,在我们的示例中,调整线程数量后工作线程仍然繁忙。
排除锁的嫌疑
如果程序被某些锁阻塞,也会呈现出 IO 密集型的特征。首先使用 contention profiler 来检查锁的竞争状况。
使用 rpcz
rpcz 可以帮助你查看所有最近的请求,以及处理每个请求时在各个阶段所花费的时间(微秒)。
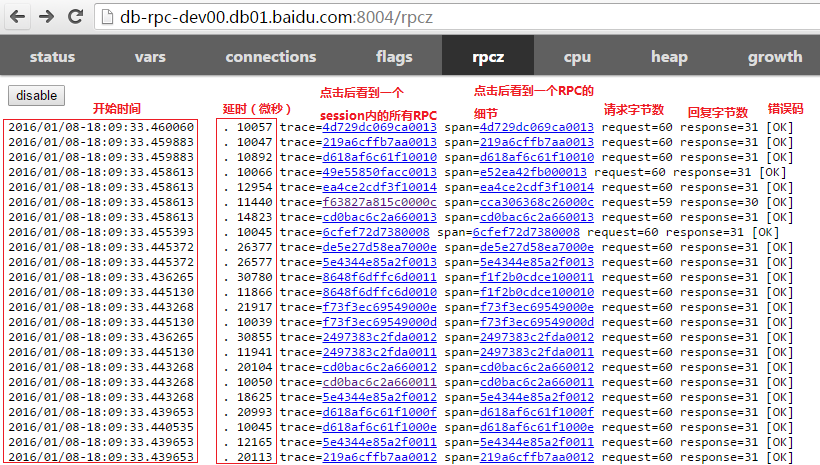
点击某个 span 链接,可以查看 RPC 的开始时间、各阶段所花费的时间以及结束时间。
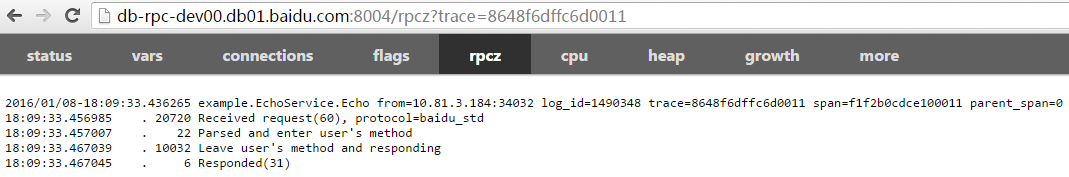
这是一个服务器严重阻塞的典型案例。从接收到请求到开始运行耗时 20ms,表明服务器没有足够的工作线程来及时完成任务。
目前该 span 的信息还比较少,我们可以在程序中添加一些。你可以使用 TRACEPRINTF 向 rpcz 打印日志。打印的内容会嵌入到 rpcz 的时间流中。

重新运行后,你可以检查该 span,确认其中确实包含了我们通过 TRACEPRINTF 添加的内容。
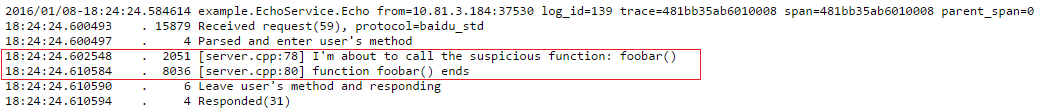
在执行到第一个 TRACEPRINTF 之前,用户回调已经运行了 2051ms(假设这符合我们的预期),随后是耗时 8036ms 的 foobar(),而该函数本应非常快速地返回。排查范围进一步缩小了。
重复这个过程,直到找到导致问题的函数。
使用 bvar
TRACEPRINTF 主要适用于被调用次数较少的函数,因此如果一个函数被调用了很多次,或者函数本身的开销很小,就不适合每次都向 rpcz 打印日志。你可以改用 bvar。
bvar 是一个多线程计数库,能够以极低的开销记录用户传入的数值,并且与日志记录相比几乎不影响程序行为。
按照下面的代码来监控 foobar 的运行时间。
#include <butil/time.h>
#include <bvar/bvar.h>

bvar::LatencyRecorder g_foobar_latency("foobar");

...
void search() {
    ...
    butil::Timer tm;
    tm.start();
    foobar();
    tm.stop();
    g_foobar_latency << tm.u_elapsed();
    ...
}
重新运行程序后,在 vars 的搜索框中输入 foobar。结果如下所示:
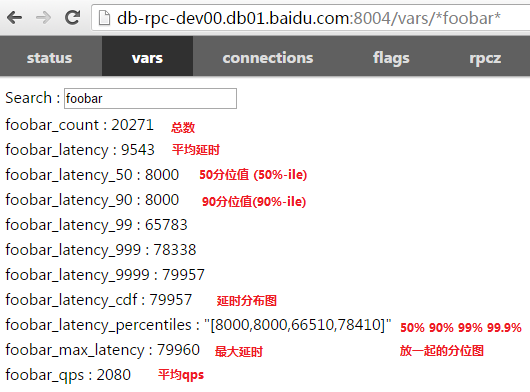
点击某个 bvar,即可看到动态图表。例如,点击 cdf 之后:
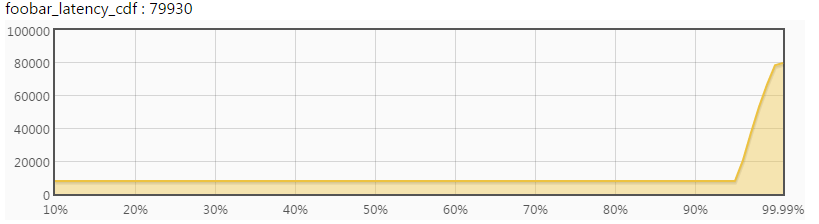
根据延迟的分布情况,你可以推断出该函数的整体行为:它在大多数请求下的表现如何,以及在长尾情况下的表现如何。
你可以继续在子例程中重复这一过程,添加更多的 bvar,比较不同的分布,最终定位到问题源头。
仅使用 brpc 客户端
你必须打开 dummy server 以提供内置服务,详见这里。
最后修改于 2022 年 5 月 17 日:update brpc users page (devlive-community/knowforge#71) (a31ce10d3)
评论
登录后参与评论